Liquid AIが、テキストを生成せず1回の順伝播で答えを返すオープンウェイトの意思決定モデル「d1-3B」と「d1-omni-600M」を公開した。エッジ端末での即時判断を狙う。
Liquid AIは10月7日、テキストと画像、あるいはテキストと音声を扱うオープンウェイトの意思決定モデルを2本公開した。d1-3Bと、実験的なd1-omni-600Mだ。生成モデルが文章を組み立てるのに対し、こちらは答えだけを返す。同社が「意思決定モデル」と呼ぶ種類で、端末上で素早く判断を下す用途を想定している。両モデルはHugging Faceで公開されている。
d1モデルが通常の生成AIと違う点
最大の違いは、単語を一つずつ出力しないことにある。通常の大規模言語モデルは、次の単語を予測して文章をつなげていく。d1はその工程を飛ばし、1回の順伝播で答えを出す。
順伝播とは、入力をモデルに一度通して出力を得る計算のことだ。何度も繰り返し処理する生成モデルに比べ、計算の回数が少ない。そのぶん速く、消費電力も抑えられる。文章を書く必要がなく、判断だけが欲しい場面に向く。
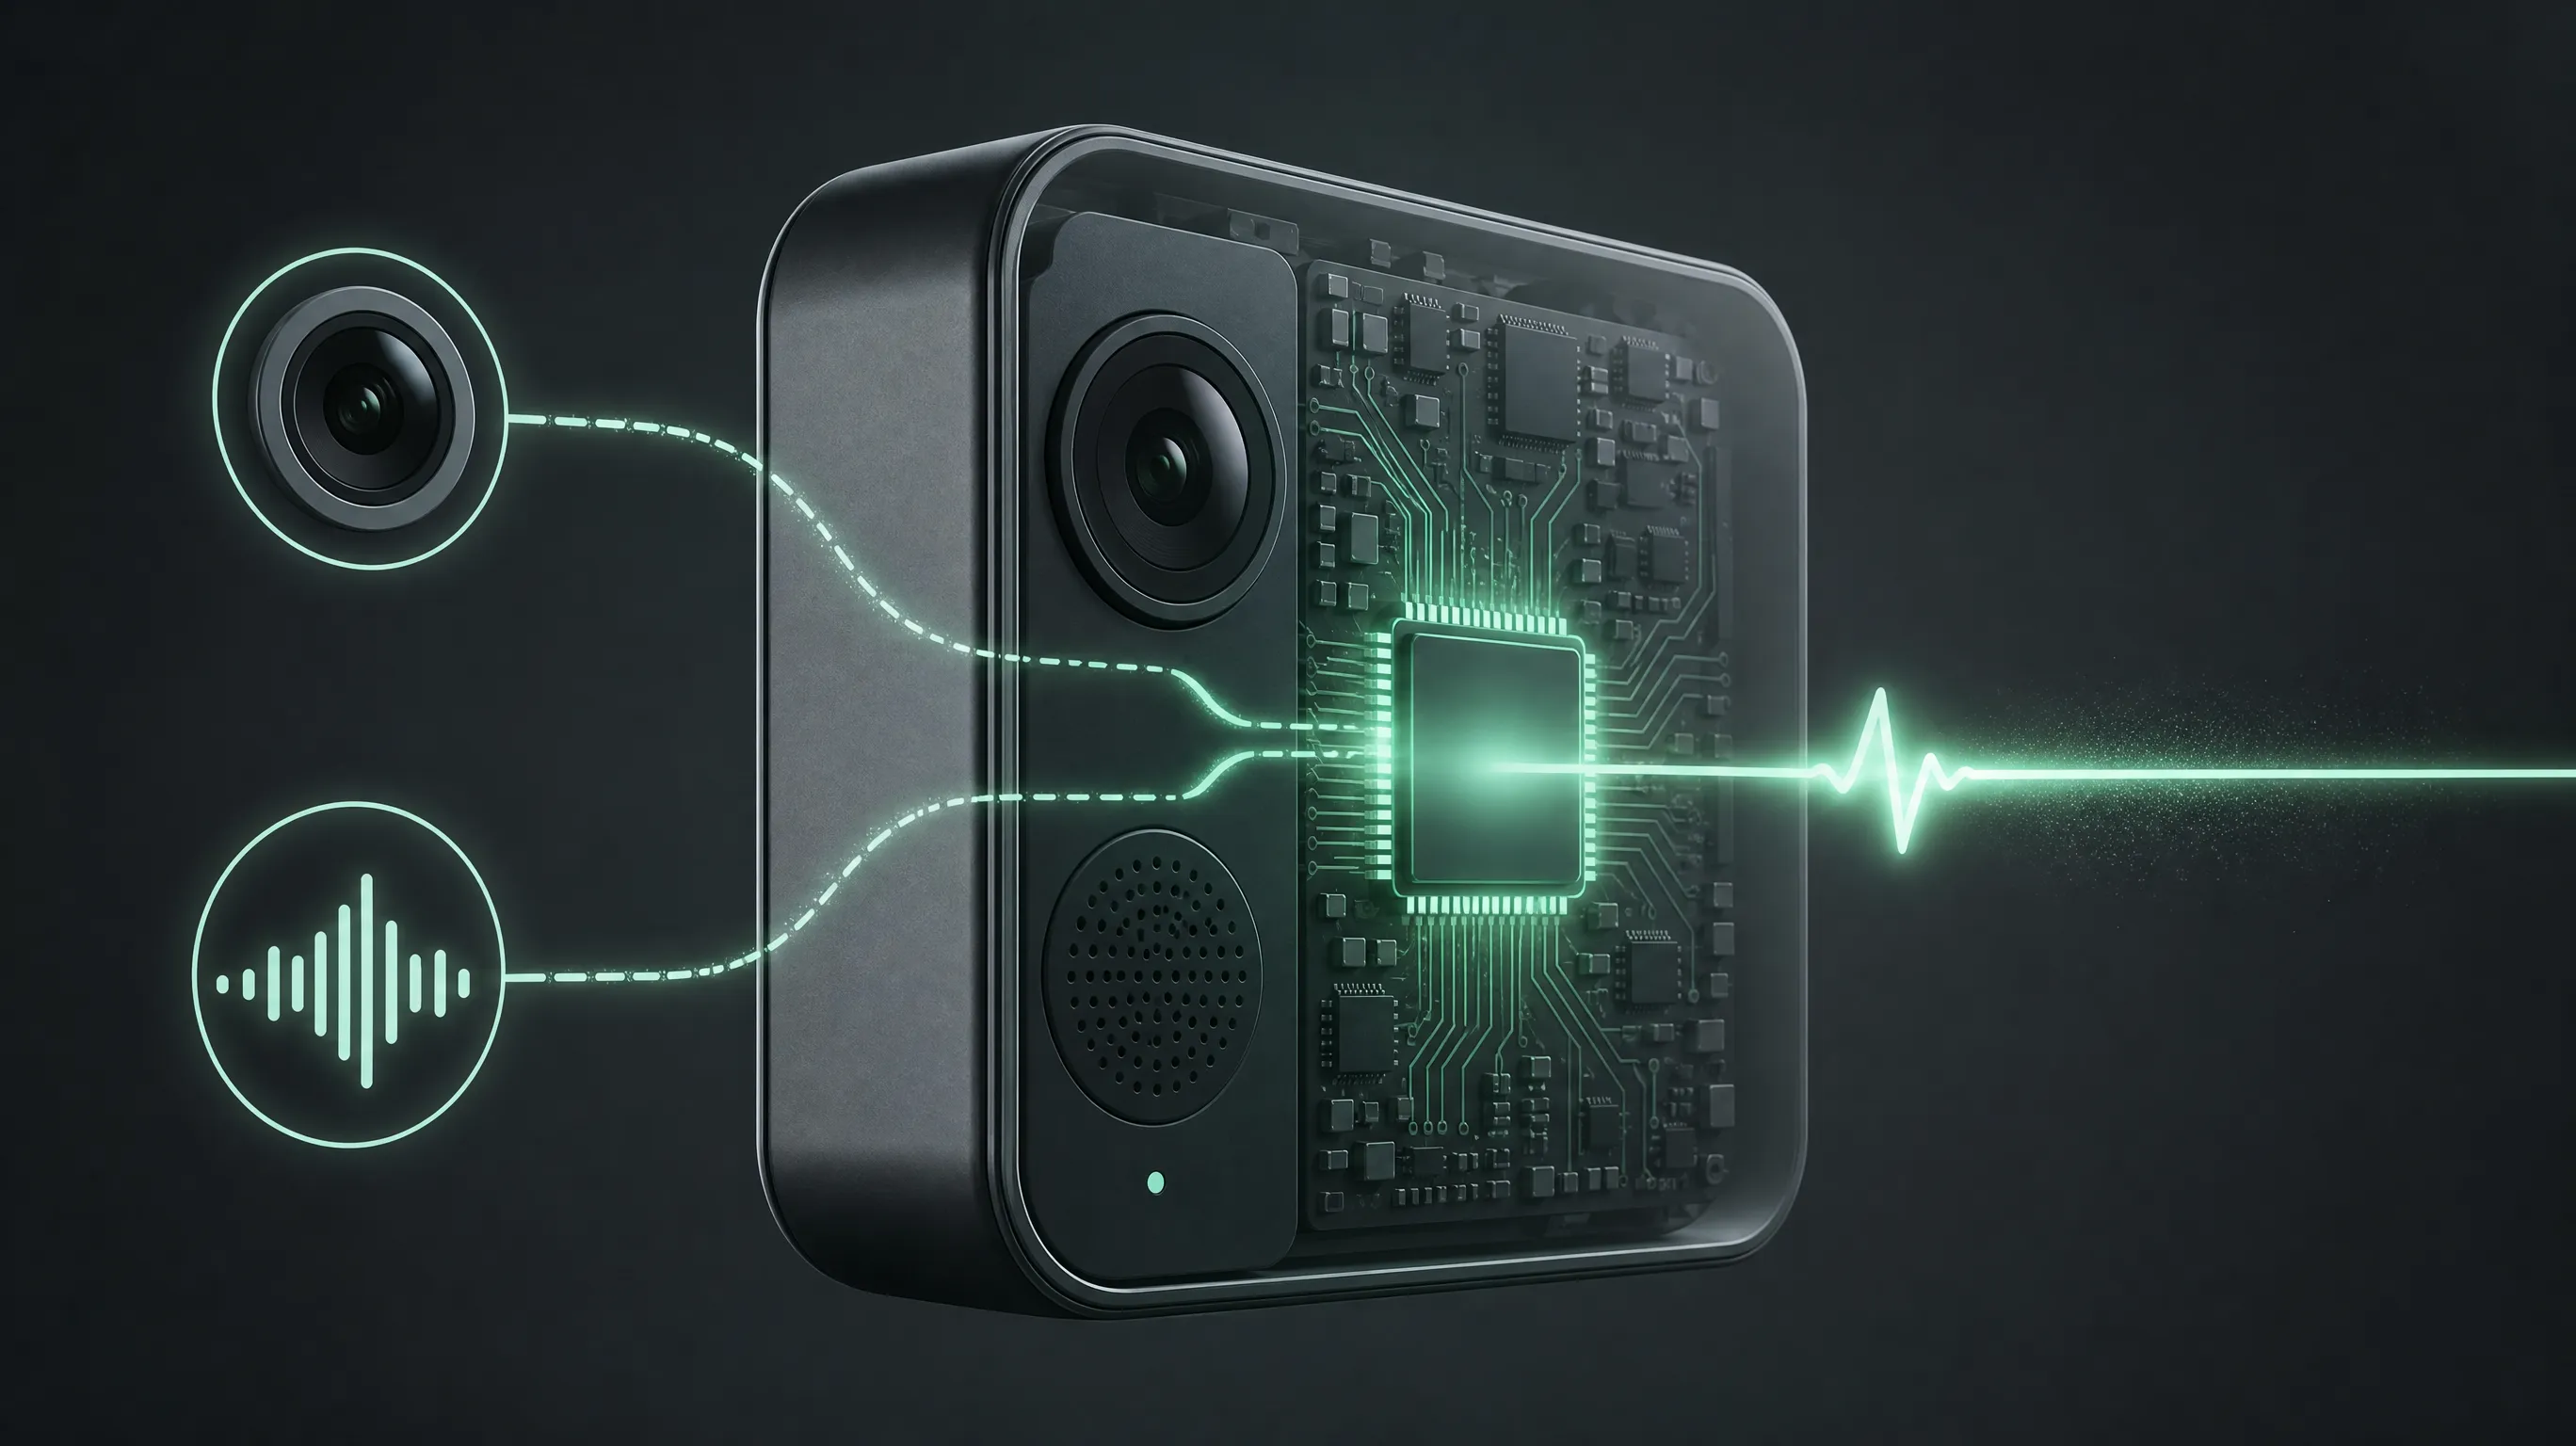
d1-3Bは、テキストと画像を扱うLFM2.5-VL-3Bを土台にする。d1-omni-600Mは双方向エンコーダのLFM2.5-Encoder-350Mを基盤に、視覚と音声のエンコーダを加えた構成だ。
性能と遅延の数字
Liquid AIの説明では、d1-3Bは意思決定の指標「Decision Index v0.2.1」の公開版で48.57を記録した。100億パラメータ未満のモデルをすべて上回り、12倍の規模を持つDecider 35B-A3Bと並ぶという。
遅延も売りにしている。RTX 4090で8ミリ秒。Jetson AGX Thorで16ミリ秒。Jetson AGX Orinで26ミリ秒。Jetson Orin Nanoで50ミリ秒。車載やロボット、産業機器といった端末で、通信を介さずその場で判断できる水準だ。
d1-omni-600Mは同じ指標で15.95。同社はこれを最初の実験的なチェックポイントと位置づける。
数字の扱いに注意
ここで挙げたベンチマークと遅延の数値は、すべてLiquid AIの自己申告だ。独立した第三者による検証は受けていない。
Decision Indexが何を測る指標なのか、その基準や難易度は公開情報だけでは判断しにくい。数字の大小をそのまま性能の優劣と受け取るのは早計だ。導入を検討するなら、実際のタスクで試して確かめる方が確実になる。
エッジ端末で何が変わるか
判断を端末の中で完結させる意味は大きい。データを外部に送らずに済む。通信が不安定な場所でも動く。応答までの待ち時間が短い。カメラや音声センサーを持つ機器が、その場で判断を下せるようになる。
製造ラインの異常検知、車両の状況判断、現場での仕分けといった用途が想定される。いずれも、遅延とプライバシーが効く場面だ。クラウドに投げるより、端末で即断するほうが合理的なケースは多い。
両モデルはHugging Faceで入手でき、ドキュメントはdocs.liquid.aiで公開されている。オープンウェイトなので、自前の環境で動かして挙動を確かめられる。
導入前に確かめたいこと
判断特化モデルは、文章を書く用途には向かない。あくまで分類や意思決定のための道具だ。用途が合うかどうかを見極める必要がある。
見るべきは、自己申告のスコアが実際のタスクでどこまで再現するかだ。手元の差し込みタスクで動かし、速度と精度を自分の目で確かめる。エッジ向けの小型モデルは、こうした実地の確認が導入判断を左右する。