
AgentQL
TinyFish · コーディング
AgentQLはTinyFishが提供するクエリ言語兼パーサーだ。要素を意味で捉えるため、サイトのHTMLが変わってもスクレイパーやエージェントは動作し続ける。
AgentQL について
About
AgentQLとは
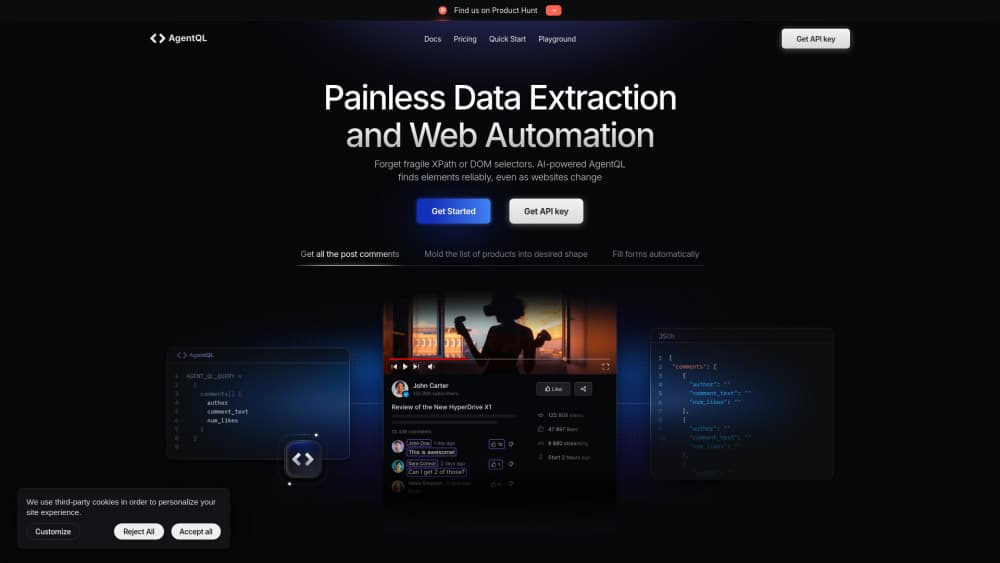
AgentQLはAI Webスクレイピング向けに作られた。AgentQLクエリ言語は、パーサーとAI層を組み合わせてWebページを読み、操作する。XPathやCSSセレクタを書く代わりに、欲しいフィールドを日常語に近い形で並べる。たとえば products[] { name price } と書けば、その形のJSONが返る。AIが各要素の周辺文脈を読むので、改修でマークアップが動いてもクエリはデータを見つけ出す。
製品は2つの用途をカバーする。データ抽出では query_data が構造化レコードを返す。操作では query_elements と get_by_prompt がPlaywrightのロケーターを渡すので、そのままクリックや入力、スクロールに使える。TinyFishはPythonとJavaScriptのSDK、ブラウザ不要のRESTエンドポイント、クエリを調整するChrome拡張、エージェントフレームワーク向けのMCPサーバーをそろえる。
便利さの代わりに、ホスト型サービスへの依存が付いてくる。クエリはすべてAPIキー付きでAgentQLのAPIを通るため、無料枠を超えれば呼び出しごとに課金され、実行時にはネット接続が要る。canvas主体の画面、珍しいレイアウト、bot対策の厳しいサイトでは失敗することもある。本番では結果を抜き取りで確認したい。
はじめかた
- agentql.comでアカウントを作り、開発者ポータルでAPIキーをコピーする。
pip install agentqlかnpm install agentqlでSDKを入れる。- 必要なフィールドを並べたクエリを書く。書式が重要なら
price(integer)のような型ヒントを足す。 - Playwrightスクリプト内で、抽出なら
query_data、操作ならquery_elementsを呼ぶ。 - playgroundかブラウザ拡張で試してから、規模を広げて実行する。
AIツール情報
AgentQLの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- PythonとJavaScriptの開発者
- 専任のスクレイピング担当がいないデータ・グロースチーム
- AIエージェントの開発者
タスク
- 価格と商品一覧の監視
- リードやディレクトリの収集
- フォーム入力と購入手続き
- 言語モデルへきれいなページデータを渡す
シーン
- 改修でスクレイパーが止まった
- 似たサイトを1本のクエリで回す
- ログイン後のページを調べる
主な機能
セマンティックセレクタ
AgentQLはDOM上の位置ではなく、意味と周辺の文脈で要素を特定する。product_price というフィールドは、class名が変わっても、ブロックが下へ移動しても価格を拾う。A/Bテストや緩やかなレイアウト変更に強く、別のチームが作ったサイトでも同じクエリが通る。
クエリが出力スキーマになる
クエリはそのまま出力の契約になる。オブジェクトを入れ子にし、リストは角括弧で示し、price(integer) や product_price(include currency symbol) のような指示で書式を決める。書いた通りのJSONが返るので、構造化データ抽出に後処理のクリーニングは要らない。
Playwright連携
PythonとJavaScriptのSDKはPlaywrightのページを包み、query_data、query_elements、get_by_prompt を追加する。画面遷移、スクリーンショット、ファイル送信にはブラウザAPIをそのまま使える。クエリが返すロケーターは通常のロケーターと同じに動くため、既存のテスト補助も生きる。
ブラウザ不要のREST API
RESTエンドポイントはブラウザを起動せずにURLからページデータを返す。Chromiumのダウンロードが現実的でない定時ジョブやサーバーレス関数に向く。URLとクエリを送れば、1回のリクエストで構造化結果が返る。
ブラウザデバッガー
Chrome拡張を入れると任意のページにサイドパネルが開き、クエリを書きながら一致した要素をその場で確認できる。セレクタを書いてから使えるか分かるまでの往復が短くなる。崩れたページほど効く。
MCPサーバー
オープンソースのMCPサーバーは、Model Context Protocolを話すアシスタントやエージェント実行環境にAgentQLの抽出を渡す。npxで入れ、APIキーを設定すれば、エージェントはURLの取得をツール呼び出しとして扱える。つなぎ込みのコードは不要だ。
メリットとデメリット
メリット
- クエリが欲しいデータそのもののように読めるので、セレクタに詳しくないメンバーでも編集できる。
- 意味ベースの照合が、スクレイピング予算の大半を食う保守作業を減らす。
- 無料のStarterプランに月50回のAPI呼び出しが付き、支払い前にユースケースを検証できる。
- Playwright対応により、抽出と操作を1本のスクリプトで書ける。
- REST APIとMCPサーバーが、ブラウザなしの処理とエージェントの流れをそれぞれ支える。
デメリット
- 呼び出しは従量課金だ。Starterは1回$0.02、Professionalは枠を超えると1回$0.015なので、10万ページのクロールは実際の出費になる。
- リモートブラウザの時間は別料金で、1時間$0.12または$0.10。長時間のWeb自動化は見た目より高くつく。
- すべてホスト型API頼みで、オフラインモードはない。障害が起きればパイプラインも止まる。
- AIの照合は決定論的ではない。変わったレイアウトでは一部のフィールドしか返らない、位置がずれるといったことがあり、本番では検証と再試行が要る。
よくある質問
用途は2つ。Webページからのデータ抽出と、ブラウザの操作だ。価格監視、リード収集、フォーム入力、AIエージェントへのデータ供給などで使われる。
関連コンテンツ
AgentQLに関連するツール、スキル、記事を探す。
AgentQLの代替ツール

Base Code
Base44 (Wix) · コーディング · 生産性向上Base CodeはBase44の共有クラウド開発環境だ。既存のGitHubリポジトリに対する変更をチャットで伝え、プレビューで確認し、プルリクエストとして返せる。

Google EmbeddingGemma 2
Google DeepMind · ライティング · 画像 · コーディングGoogle EmbeddingGemma 2 は 7 億 4000 万パラメータのオープンなモデルで、テキスト、コード、画像、音声、動画フレームを同じ 768 次元空間のベクトルに変え、スマートフォンやノート PC 上で動く。

GitGlow
GitGlow · コーディング · 生産性向上GitGlow は自分のコードと AI エージェントの変更を一つのレビューにまとめるデスクトップ Git クライアントだ。出荷前に、マシンから何が出ていくのかを確かめられる。