
EnergeticAI
EnergeticAI open-source project · コーディング
EnergeticAIはサーバーレス関数向けに調整したTensorFlow.jsのオープンソース配布版で、Node.jsアプリなら約50ミリ秒のコールドスタートで埋め込みモデルやテキスト分類器を動かせる。
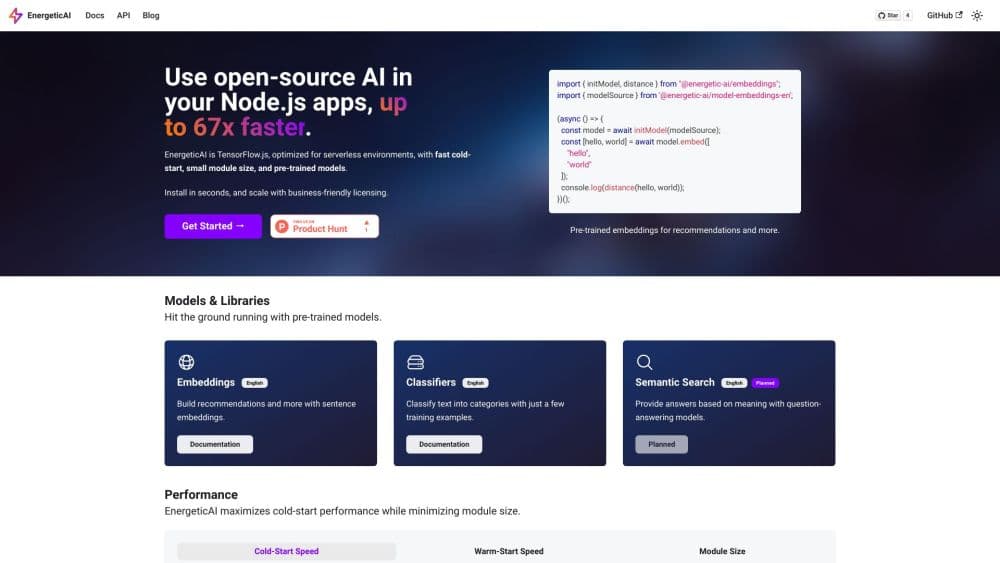
EnergeticAI について
What Is EnergeticAI
EnergeticAIは、AWS Lambda、Vercel Functions、Netlify Functionsといったサーバーレス関数向けにTensorFlow.jsを削って再パッケージしたものだ。解いているのはデプロイの具体的な詰まりどころである。本家TensorFlow.jsは非圧縮で146MBから513MBあり、コードが動き出す前にパッケージ上限へ引っかかる。さらにモデルの重みを初回呼び出し時に取りに行くため、コールドスタートは2秒を超える。
このプロジェクトは推論に必要な部分だけを残す。モジュールは約3MBに収まり、提供元の計測ではコールドスタートの推論が50ミリ秒前後、コアパッケージは@tensorflow/tfjs-coreの置き換えとしてそのまま使える。手持ちのコードとモデルは多くが書き換えなしで動く。
制約も同じくらい大きい。事前学習モデルは英語の埋め込みとテキスト分類だけで、セマンティック検索は計画中と表示されたまま、演算はWebAssemblyのみでGPUは使わない。npmのバージョンは2023年6月公開の0.2.0なので、伸び続けるプラットフォームではなく、安定したが動きの少ないプロジェクトとして扱うのが正しい。
Getting Started
- Node 18以上を用意し、コアパッケージと使うモデルライブラリを入れる。
npm install @energetic-ai/core @energetic-ai/embeddings @energetic-ai/model-embeddings-en - モデルライブラリから
initModelと対応するモデルソースを読み込み、関数インスタンスごとに一度だけ重みをロードする。 - 文字列の配列に対して
model.embed()を呼べばベクトルが返る。分類器パッケージなら数十件のラベル付き例で学習させる。 - 同梱の
distanceでベクトルを比較し、そのスコアを並べ替え、絞り込み、振り分けのロジックへ渡す。 - サーバーレスのホスティングへデプロイし、パッケージサイズを確認する。この上限こそがEnergeticAIへ乗り換える理由だからだ。
AIツール情報
EnergeticAIの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- サーバーレスAIを求めるNode.js開発者。TensorFlow.jsが通らないパッケージ上限を越えるために作られたライブラリなので、時間は機能に向き、梱包の工夫には取られない。
- 個人開発者と小規模チーム。推論の請求もAPIキーもなく、アクセスが本当に増えるまで副業プロジェクトの費用はゼロのままだ。
- データの扱いに厳しいチーム。推論は自分の関数の中で完結し、テキストは自社インフラから出ない。プライバシー書類に取引先を一行足す必要もない。
- 初めてAI機能を足すバックエンドエンジニア。事前学習モデルがよくある用途をカバーするので、学習パイプラインもGPUも機械学習の専任も要らない。
タスク
- 埋め込みモデルで商品レコメンドを組む。カタログを一度索引化し、リクエストごとにページ文脈のベクトルを作って距離で並べる。
- 数十件のラベル付き例でテキスト分類器を学習させ、サポートチケットやフォームの内容を振り分ける。
- レビューや重複出品をベクトル距離でまとめる。キーワード規則を書き続ける必要はない。
- 数百件の文書に軽いセマンティック検索をかける。ただし専用モデルはまだ計画中だという前提を受け入れること。
シーン
- パッケージ上限の厳しい無料枠や低価格枠へ載せる場合。3MBのモジュールが公開できるかどうかを分ける。
- 外部APIへ送れないテキストを扱う場合。社内チケット、診療メモ、契約下有の顧客データなどが該当する。
- ノートPCでAI機能を試作し、同じコードを本番へ上げる場合。ベンダーSDKに合わせてモデル層を書き直さずに済む。
主な機能
サーバーレス前提のパッケージ設計
プロジェクト全体が関数基盤の制約に合わせて組まれている。モジュールは約3MBまで縮み、Lambdaやエッジ環境の一般的な上限に収まる。本家TensorFlow.jsはそこで止まる。モデルの重みは初回取得ではなくパッケージに同梱されるため、冷えたコンテナがネットワーク待ちで止まらない。
コールドスタート
公式サイトはサーバーレス関数での推論がTensorFlow.js比で最大67倍速いとしている。M1 Max搭載MacBook Proでモデルを初期化し、5文の段落を埋め込む条件での計測だ。実数はホスティングと入力長で変わる。それでも方向は同じで、秒ではなく数十ミリ秒。リクエストがタイムアウトするかどうかはここで決まる。
事前学習済みの埋め込みモデル
埋め込みパッケージは文字列を比較、分類、並べ替えに使えるベクトルへ変える。英語モデルは別の重みパッケージとして配られるので、必要な言語だけを入れればいい。自分で学習せずにレコメンドや類似度検索へ到達する最短の道である。
少数例で動くテキスト分類器
分類器パッケージは実行時に小さなラベル付き集合で学習する。完全なデータセットではなく20件や50件しかない振り分けやタグ付けに向く。ラベルはリポジトリに置き、デプロイのたびに学習し直すので、挙動はコードと一緒に版管理される。
TensorFlow.jsとの直接互換
コアモジュールは@tensorflow/tfjs-coreのAPIをなぞっているため、既存のimportとモデルコードはたいていそのまま動く。サービス全体を決める前に1つのエンドポイントで試せるので、移行のコストは小さい。
WebAssemblyバックエンド
推論はWebAssemblyで走る。短い入力には十分速く、Nodeのホストならネイティブビルドなしで動く。GPU加速はないので、大きなバッチや長い文書はCUDA搭載機より明確に遅くなる。
メリットとデメリット
メリット
- パッケージが数百MBから約3MBへ減る。サーバーレス枠にモデルを載せられるかどうかは、多くの場合ここで決まる。
- 提供元の計測ではコールドスタートが50ミリ秒前後に収まり、利用者のリクエストがモデル読み込みで止まらない。
- Apache 2.0ライセンスで、事前学習モデルも同程度の条件のものが選ばれている。商用利用の手続きは単純だ。
- 呼び出しごとの課金がなく、データも関数の外へ出ない。ホスティング型の埋め込みAPIとの差は大きい。
- コアパッケージは既存のTensorFlow.jsコードへそのまま入る。移行は依存を差し替える程度で済む。
デメリット
- 事前学習モデルは英語のみ。多言語製品は自前の重みと追加の検証が要る。
- GPU非対応のため大きなバッチは遅く、文書量が多いと小さな関数では1リクエストに数秒かかることがある。
- モデルの品揃えは薄い。現在は埋め込みと分類器だけで、セマンティック検索は計画中のままだ。
- npmは2023年6月の0.2.0で止まっている。更新の遅いプロジェクトを引き受けることになるので、バージョンを固定し、不具合が出たらソースを読む姿勢が要る。
よくある質問
サーバーレス関数の中でオープンソースAIを動かすためのものだ。商品レコメンド、テキスト分類、重複検出、セマンティック検索など、機械学習の一式を抱えられないNode.jsバックエンドで使われる。
関連コンテンツ
EnergeticAIに関連するツール、スキル、記事を探す。
EnergeticAIの代替ツール

Udon
Udon · コーディング · 生産性向上Udon は Apple Silicon の Mac を Mac 家庭用サーバーに変えるソフトだ。ブラウザからコンテナとファイル共有を操作でき、AI システム管理者も任意で使える。

offstage
offstage cloud · コーディング · 生産性向上offstage は AI エージェントと CI ジョブに本物の Mac を渡す。Apple Silicon 上の macOS 27 アカウントを API で操作し、秒単位で課金される。

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · コーディング · 生産性向上BotBusを使えば、スマホからAIコーディングエージェントを操作できる。席を外したままコマンドを承認し、タスクを始め、結果を確認できる。