
Fish Speech
Fish Audio · 音声・言語 · 動画
Fish SpeechはFish Audioのオープンソース音声合成モデルで、現在はDrama 3として提供される。10〜30秒の音声で声を複製でき、83言語に対応し、文中に感情タグを置ける。
Fish Speech について
About
Fish Speechとは
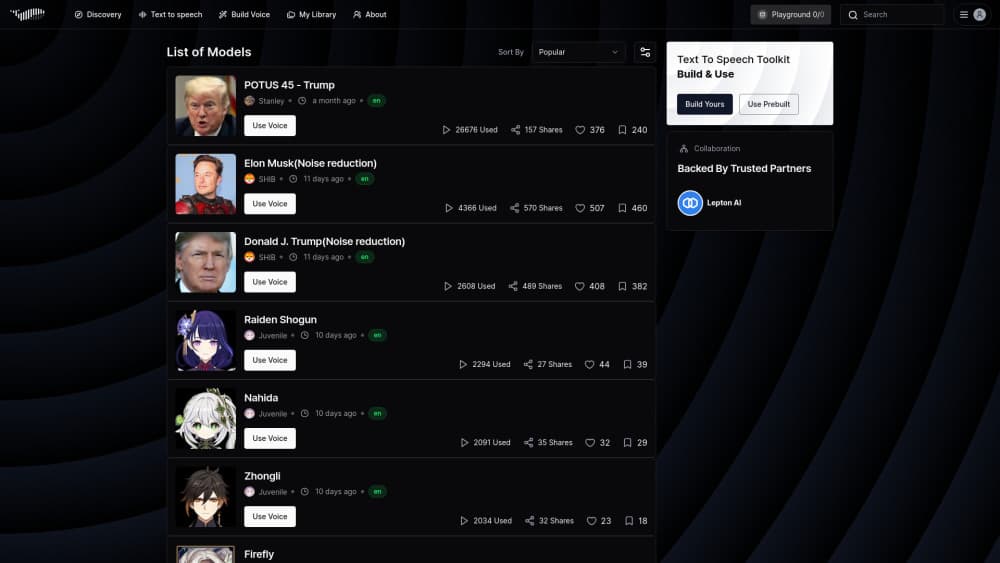
Fish Speechは、fish.audioを運営するFish Audioが公開しているオープンソースの音声合成モデルだ。この名前は二つをまとめて指す。Hugging Face上のモデル重みとGitHub上のコード、そして同じモデルをサイトとAPIの裏側で動かすホスティングサービスである。登録して使えば一般的なAI音声生成ツールと変わらない。重みを落とせば、生成の工程をすべて自分の手元に置ける。
モデルの系譜は速い。Fish Speech 1.xとOpenAudio S1が「短いサンプルから声を複製し、日常的な言葉で語り方を操作する」という方向を決めた。S2とS2.1 Proが精度とストリーミングを押し上げた。2026年10月13日公開のDrama 3が現行の主力で、350億パラメータ、トークンあたり30億をアクティブに動かす構成に、音声の部分編集とマルチターンの修正を加えている。
解いたのは「オープン」と「作り込み」のあいだの距離だ。オープンソースTTSは商用ツールの隣に置くと平板に聞こえ、商用ツールはたいていクラウドから出られない。ここは両方の扉が開いている。重みはFish Audioコミュニティライセンスで配布され、年商50万ドル未満の企業なら商用利用できる。ホスティングのプランは無料から始まる。
制約もはっきりしている。自前で動かすにはNVIDIAのGPUとPython環境への多少の慣れがいる。複製の質は参照音声のきれいさに直結し、雑音の多い録音からは雑音の多いクローンしか出ない。そして公表されているベンチマークの多くはFish Audio自身の計測で、第三者の比較として信頼できるのは今のところArtificial Analysis程度だ。
使い始める
- fish.audioを開き、無料アカウントを作る。無料プランは月に約7分の生成枠があり、声が自分の用途に合うか判断するには足りる。
- ライブラリから声を選ぶか、自分の声を複製する。複製する場合は音楽も残響もない10〜30秒の音声をアップロードする。
- 台本をテキスト欄に貼り、感情が変わる位置に指示タグを置く。たとえば文の前に[whisper]、後ろに[laughing]を入れる。
- 生成して聴き、タグを直す。文章を書き換えるより、タグ一つの変更のほうが演技は大きく動く。
- 自前で動かすならGitHubのリポジトリを複製し、環境を構築し、Hugging Faceから重みを取得して、最近のNVIDIA製カードを積んだマシンでWebUIかAPIサーバーを起動する。
AIツール情報
Fish Speechの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- YouTubeクリエイターとポッドキャスター:ナレーション、広告読み、他言語版が同じ台本から出る。無料枠でチャンネルの予告編は試せる。ノイズを見つけるにはそれなりのヘッドホンが要る。
- ゲーム開発者とアニメーター:キャラクターの声を一午后で試作でき、スタジオの空きを数週間待たなくて済む。Drama 3は1シーンに複数の話者を入れられる。本番は人間の演出があったほうが強い。
- 音声を製品に組み込む開発者:TTS APIはテキストを受け取り、最初の音まで約100ミリ秒でストリーミングを返す。音声エージェントの応答が引っかからない。試作の先に進むなら予算の見直しが要る。
- ローカライズ担当:83言語を1つの複製ボイスでまかなえるので、製品デモをスペイン語、日本語、アラビア語に展開するのに5人もナレーターを雇わなくていい。ブランド名の発音は母語話者に確認したい。
タスク
- 動画を別の言語に吹き替える:複製した声はそのまま、台本だけ差し替える。音を消して見る人が多いSNS向けの短尺では字幕より効く。
- キャラクターの台詞を試作する:[angry]や[nervous]を足して、スタジオを押さえる前に演技を聴ける。
- 記事を音声化する:本文を貼って生成し、区切りの位置に間タグを入れて公開する。
- アプリの試作に声を載せる:バックエンドからTTS APIを呼び、モデルのパイプラインを自前で組まずにクライアントへ音声を流す。
シーン
- スタジオ代を払う前に案を確かめる:荒い音声トラックでも台本が読めるかは分かる。もっとも安いフィードバックの回だ。
- 複数市場でチャンネルを回す:1つの声の人格を言語をまたいで使えるので、ブラジルとドイツの視聴者が同じ進行役を聴く。
- 締切のあるデモを出す:サイトとAPIで1日あれば動く試作になる。自前運用は数字が合ってからでいい。
主な機能
短いサンプルからのボイスクローン
10〜30秒の参照音声で声質を再現できる。公式サイトは15秒とうたう。複製されるのは漠然とした印象ではなく、なまり、音高、話すリズムまで含む。マイクに近づけて録ったモノラルの音源が最もよく効き、BGMは成果を最速で壊す。
文中の指示タグ
語り口は角括弧の指示で操作する。気分が変わる位置に[whispering]、[angry]、[sighing]、[laughing]、[pause]を置く。Drama 3は自由記述も受け付けるので、[barely holding it together, forcing a smile]のようなタグも通る。強調用の対タグなら、文中の数語だけを狙って動かせる。速度と音高をいじって当たりを祈るしかなかった旧世代のエンジンとの差はここにある。
広い言語カバレッジ
Drama 3は83言語を話す。Fish Speech 1.5の13言語から大きく増えた。ダウンロードできる多言語TTSの中では上位に入る広さだ。要点は言語をまたぐ複製にある。一度複製した声で別の言語を生成しても、話者の同一性は保たれる。指示タグは自分が考える言語で書いてよく、モデルは対象の文にそのまま適用する。
1シーンに複数の話者
1つのテキストに話者IDで区切って複数の人物を入れられ、モデルはそのやり取りを一度に生成する。オーディオドラマ、ゲームのカットシーン、2人進行の動画では、生成して繋いで時間を合わせ直す手間が消える。
部分編集とマルチターンの修正
Drama 3は仕上がったテイクを文書のように直せる。1語を差し替えても前後の声質と繋ぎ目は保たれ、5分の音声を丸ごと作り直さずに済む。マルチターンの修正は逆方向に効く。前のテイクはもっと柔らかく、もっと悲しくと言えば、その文脈を持ったまま生成し直す。
自前で動かせる公開重み
コードと重みは公開されており、コミュニティライセンスは年商50万ドル未満の商用利用を認める。秘匿性の要件があるチームや、量が読めるチームには現実的な選択肢になる。ローカル推論は文字数で課金されない。代わりにGPU、構築の時間、Pythonの環境維持を払う。
低遅延のストリーミングAPI
ホスティングAPIは生成しながら音声を流す。Fish Audioの計測では最初の音が約100ミリ秒、H200でリアルタイム係数0.195。音声合成、音声認識、音声エージェントのエンドポイントが同じキーで使える。対話型の製品では、この遅延が「割り込むアシスタント」と「待てるアシスタント」を分ける。
メリットとデメリット
メリット
- 短い参照音声で声を複製できるので、スタジオ収録なしでも使える声が手に入る。
- 感情と間は日常的な言葉のタグで操作でき、パラメータのスライダーより試行の回転が速い。
- 無料プランと公開重みという、支払う前に試せる安い経路が2つある。
- 83言語と言語をまたぐ複製で、1つの声の人格がローカライズ作業の大半をカバーする。
- ストリーミングの遅延とオープンなAPIがあり、単発のファイル生成ではなく実際の製品に載せられる。
デメリット
- 自前運用にはNVIDIAのGPUとPython環境への習熟が要り、気軽に試す層は届かない。
- 複製の質は参照音声に強く依存する。雑音の多い素材はこもった結果になり、クリーニング機能は内蔵されていない。
- コミュニティライセンスは無償の商用利用を年商50万ドル未満に限るため、それ以上の企業は別途契約が要る。
- 公開ベンチマークのほとんどは提供元の計測で、第三者の比較は発音の正確さを測るもので、感情の幅は測っていない。
よくある質問
無料で使える。ホスティングサービスには月約7分の生成枠がある無料プランがあり、モデルの重みも無償でダウンロードできる。公開重みの商用利用は年商50万ドル未満の組織なら自由だ。
関連コンテンツ
Fish Speechに関連するツール、スキル、記事を探す。
Fish Speechの代替ツール

Foley
Hanamori Labs, LLC · 音声・言語 · 生産性向上 · AIアシスタントFoleyは音声ToDoリストだ。話した一文をプロジェクト・日付・時刻まで入ったタスクとして整理し、その後はすでにあるリストを軸に一日の順番を組み立てる。

HireKey
HireKey · 音声・言語 · 生産性向上 · 学習HireKey は元テック業界リクルーターが作った AI 求職コパイロット。求人適合分析、職務経歴書のカスタマイズ、面接練習、応募管理を一つの画面にまとめる。

Fluence
Yay Software (Yannick Huchard) · ライティング · 音声・言語 · 生産性向上Fluence は Android 向けのドキュメントリーダーだ。PDF、EPUB、Word 文書、ウェブ記事を読み上げ、発話中の文を画面で追わせ、本文についての質問にも端末上で答える。