
Fuzzy Match
Radix Analytics Pvt Ltd · コーディング
Fuzzy MatchはCSVやExcelファイルを読み込み、指定した列から似た名前、誤記、表記ゆれを探し出すウェブ版のデータ照合ツールだ。
Fuzzy Match について
What Is Fuzzy Match
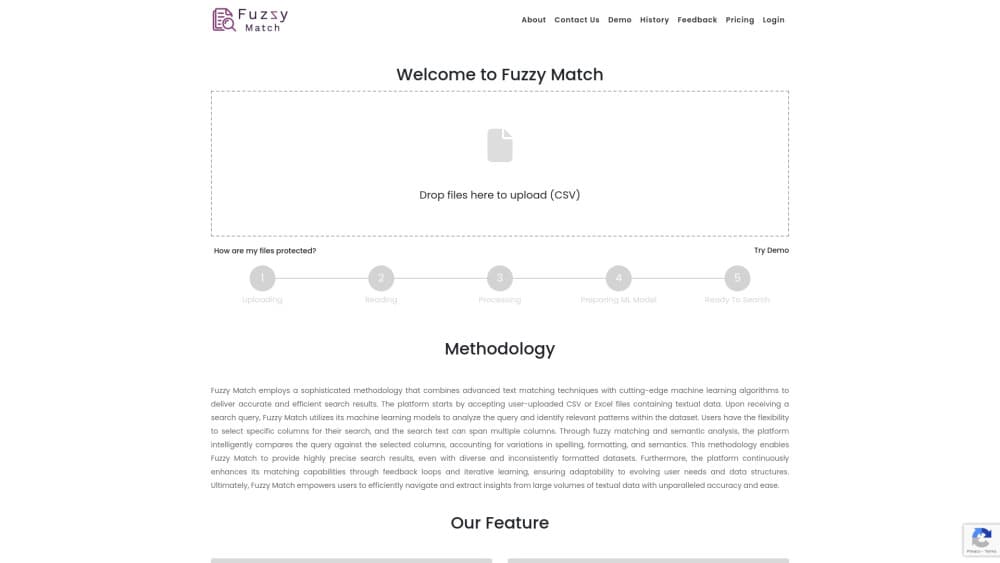
Fuzzy MatchはRadix Analyticsが提供するウェブアプリで、入力した文字列をアップロード済みのファイルと突き合わせる。検索対象の列を選び、氏名や住所、製品コードを送ると、つづりの誤りや書式の違いを含めて、近い行が返ってくる。
狙いはオフィスでよく起きる食い違いの解消にある。同じ相手を指す2つのリストが、表記だけは最後まで一致しない。ある顧客が一方の出力では「Jon Smith」、もう一方では「John Smyth」になっている。こうしたファジーマッチングツールがあれば、SQLもPythonも書かずにその組を見つけられる。
検索コンソールであって、データクレンジングの全部入りスイートではない。並んだ候補と実行履歴は手に入るが、マスターレコードを組み直す流れは用意されていない。ファイルサイズ、ファイル数、結果件数にはプランごとの上限があるため、巨大なデータは分割してからアップロードする。
Getting Started
- fuzzymatch.inを開き、アカウントなしでデモを試す。無料プランの範囲を使うならログインする。
- CSVまたはExcelファイルをアップロードし、サービスが行を読み込んで照合モデルを用意するまで待つ。
- 検索する列を選び、探したい氏名、住所、コードを入力する。
- 並んだ結果を確認し、必要なら言い回しを変えて再検索する。実行内容は履歴に残る。
AIツール情報
Fuzzy Matchの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- データアナリスト
- 運用やCRMの担当者
- エンジニアがいない小さなチーム
タスク
- 顧客リストの重複排除
- 住所の照合
- 商品カタログの整理
- レポート前のデータクレンジング
シーン
- 一度きりのファイル監査
- 毎月の取引先チェック
- 移行前の点検
主な機能
誤記に耐えるファジーマッチング
エンジンは入力した語を一行ずつと比べ、文字の抜けや重複、入れ替わりがあっても候補を返す。手入力のレコードを扱うデータ照合では重要な性質で、最初の打ち間違いで完全一致の絞り込みが崩れる。
列を絞った検索制御
読み取る列は自分で決められ、一度の検索で複数の列をまたげる。氏名の列だけに絞れば、備考や自由記述の雑音が落ち、並んだ候補も目で追える長さに収まる。
ルール表ではなく機械学習
Fuzzy Matchは照合を、固定した例外リストではなくアップロードされたファイルの傾向に合わせるモデルとして説明している。行ごとに書式が揺れるデータほど効いてくる。
フィードバックが結果を変える
候補への評価を集め、次の実行に反映する仕組みがある。誤った組を指摘すればモデルに信号が残る。匿名デモではなくログインして使う理由はここにある。
履歴と保存期間の管理
実行は履歴画面に残り、期限が来る前にファイルを削除できる。保存期間はプラン次第で、無料が24時間、上位プランは7日、15日、30日と延びる。
プランごとの上限とカスタムモデル
無料と有料の違いはファイルサイズ、結果件数、保存容量、月あたりのファイル数にある。Premiumは自社データで訓練したモデルを加え、照合の勘所が業界固有のチームに向く。
メリットとデメリット
メリット
- インストールも設定も不要: 流れはブラウザのタブで完結し、アカウントを作る前からデモが動く。
- 上限が明示されている: ファイルサイズ、結果件数、保存期間がプランごとに公開され、無料で足りるか判断しやすい。
- 学習する照合: 修正がモデルに戻るため、汚れたリストでは固定の文字列距離ルールより当たる。
- カスタムモデルの選択肢: 汎用モデルではなく自社データに合わせたいチームをPremiumが拾う。
デメリット
- 結果上限が大きなファイルに響く: Premiumでも1回1,000件で止まるので、5万行の重複排除は分割して回すことになる。
- 公開APIの資料がない: 自動化は手動アップロード止まりで、定時実行のパイプラインはウェブ画面の外に自前で組む必要がある。
- 保存期間が短い: ファイルは最長30日で消えるため、監査用の軽い記録置き場にはならない。
- 人の確認は残る: 近い候補には誤検出が混じり、レコードの統合まではしてくれない。
よくある質問
CSVやExcelファイルの中から、入力した文字列に近い行を探す。誤記や表記ゆれの行も対象になる。列を選び、並んだ結果を確認する流れだ。
関連コンテンツ
Fuzzy Matchに関連するツール、スキル、記事を探す。
Fuzzy Matchの代替ツール

Base Code
Base44 (Wix) · コーディング · 生産性向上Base CodeはBase44の共有クラウド開発環境だ。既存のGitHubリポジトリに対する変更をチャットで伝え、プレビューで確認し、プルリクエストとして返せる。

Google EmbeddingGemma 2
Google DeepMind · ライティング · 画像 · コーディングGoogle EmbeddingGemma 2 は 7 億 4000 万パラメータのオープンなモデルで、テキスト、コード、画像、音声、動画フレームを同じ 768 次元空間のベクトルに変え、スマートフォンやノート PC 上で動く。

GitGlow
GitGlow · コーディング · 生産性向上GitGlow は自分のコードと AI エージェントの変更を一つのレビューにまとめるデスクトップ Git クライアントだ。出荷前に、マシンから何が出ていくのかを確かめられる。