
Grably
Grably · コーディング · ビジネス
Grablyは写真や動画、音声を共有した人にトークンを付与し、AI企業には同意を得たデータセットをライセンスするAI学習データのマーケットプレイスだ。
Grably について
About
Grablyとは
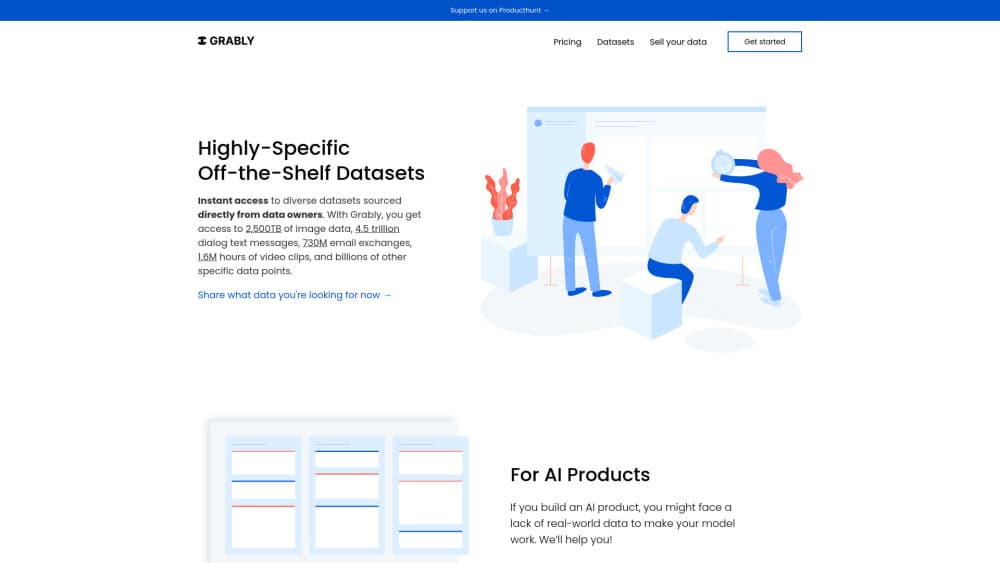
Grablyは二者間をつなぐデータ市場である。片側では一般の人が日常の素材をアップロードする。スマホの写真、短い動画、音声の録音、チャットの履歴などだ。もう片側ではAIラボや開発チームが、それを学習データとして買う。報酬はGrably Tokensで支払われ、USDTに交換できる。
売りは同意にある。ファイルは共有に賛同した人から集め、投稿はすべて審査を通してからデータセットに入れると会社は説明する。公開ウェブから画像や音声を拾いたくないチームにとって、ここが効いてくる。
自社でまとめたAIデータセットも販売している。5億人以上の参加者と100ペタバイト超の素材からなる17の独自データセットがあり、100言語以上の会話メッセージや、ラベル付きのスポーツ映像数千時間を含むという。数字はあくまで会社の主張で、こちらで独自に確認はできていない。
すぐに壁も見える。セルフサービスではない。データを買う側は営業と話す必要があり、提供側は公開された単価ではなく、承認されたタスクごとに報酬を受け取る。
はじめ方
- TelegramでGrablyのボットを開くか、Android版のGrablyアプリを入れてアカウントを作る。
- 写真の一括アップロードや音声の録音など、タスクを選ぶ。
- 共有条件を読み、何を渡すのかを確認する。
- ファイルを送信し、審査の結果を待つ。
- 残高にたまったGrably TokensをUSDTに交換する。
AIツール情報
Grablyの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- スマホの写真が余っている人:プリントしない写真にも学習価値はあり、端末からまとめて送れる。
- 音声を提供したい人:自宅で録った短いフレーズで音声モデルは育つ。スタジオ機材は要らない。
- ライセンス済みデータを必要とするAIチーム:各ファイルの出所を記録として残せる。法務が学習データを確認する場面で効く。
タスク
- AI企業にデータを売る:受け付けと審査はプラットフォームが担当する。一度アップロードすれば、あとは買い手がライセンスする。
- 多言語の会話コーパスをそろえる:会話の集合は100言語以上をカバーし、収集に何か月もかけずに済む。
- 音声と映像のデータセットを作る:タスクごとに何を録るか指示されるため、学習に使える粒度でそろう。
- 共有前に露出を確かめる:アプリが収集内容を示すので、ファイルが端末を出る前に判断できる。
シーン
- 研究室が日常の人間映像を必要とする:パソコン操作やスマホ動画は合法ルートが少なく、この経路なら権利の議論を避けられる。
- 学生が手持ちのファイルで小遣いを稼ぐ:金額は小さいが、手間はほぼゼロに近い。
- スタートアップが公開ウェブを巡回できない:同意済みデータをライセンスすれば、クローリングに付きまとう著作権の争いを避けられる。
主な機能
提供に報酬が付く仕組み
Grablyはアップロードを有償の作業に変える。タスクを選び、指定されたファイルを送り、審査が通ればGrably Tokensが入る。トークンはUSDTに交換できるため、報酬はストアの残高ではなく現金に近い。単価はタスクごとに変わり、1枚いくら、1分いくらという定価は公表されていない。
引き渡し前の審査
投稿は買い手に届く前に必ず確認される。データセットの品質を保ち、学習に不要な素材を混ぜないための仕組みだ。提供側から見れば、却下された束は報酬ゼロになる。指示に沿って出すのが得策である。
TelegramミニアプリとAndroidアプリ
作業の大半はTelegram内で完結する。ボットがタスク、アップロード、残高を管理する。メッセンジャーを避けたい人向けに、Android専用のGrablyアプリも用意されている。どちらもPCを必要とせず、端末で生まれるデータの性質に合っている。
多言語の会話データセット
チャットの集合には、100言語以上にわたる数十億件の連続したメッセージが、リアクションや返信、添付メディアごと収録されている。買い手は会話の文脈やマルチモーダルの整合に使う。価値は流れにある。一文の見た目ではなく、人が実際にどう反応するかが残る。
映像とスポーツの素材
Grablyは3億本以上のクリップ、9,000年分の映像を掲げる。パソコン操作、ゲーム、DIYといったカテゴリに分かれる。スポーツは別立てで、サッカーはフレーム単位のラベル付きだ。ブラウザエージェントや動作モデルを訓練するチームは、自分で撮って注釈を付ける費用が高いため、この映像を重宝する。
共有範囲を自分で決められる
何を渡すかは本人が選ぶ。各タスクは明示的な許可を前提に組まれている。AI学習データのマーケットプレイスとウェブスクレイパーの違いはここだ。あとから削除したい場合は、自動ダッシュボードではなく会社に直接連絡する。
メリットとデメリット
メリット
- すでに手元にあるデータを、特別な機材なしで換金できる。
- 審査が不適切なファイルを除くため、買い手が払う品質が保たれる。
- Telegramのボットなら、スマホから数タップで送信できる。
- 言語と映像の集合は、本格的なモデル訓練に耐える規模がある。
- 提供は無料で、解約すべきサブスクリプションもない。
デメリット
- 報酬はタスクの承認待ちで、単価も非公開のため収入を読みにくい。
- 換金はUSDT経由で、銀行振込だけを望む人には手間が増える。
- 買い手は自分で登録してダウンロードできず、ライセンスは営業との交渉になる。
- 公開APIの文書がなく、自社の処理に組み込みたいチームは止まる。
よくある質問
AI企業にデータを売りたい人と、同意の記録付きで学習データを必要とするチームをつなぐ。前者はアップロードのタスクをこなし、後者はその成果をライセンスする。
関連コンテンツ
Grablyに関連するツール、スキル、記事を探す。
Grablyの代替ツール

Base Code
Base44 (Wix) · コーディング · 生産性向上Base CodeはBase44の共有クラウド開発環境だ。既存のGitHubリポジトリに対する変更をチャットで伝え、プレビューで確認し、プルリクエストとして返せる。

Google EmbeddingGemma 2
Google DeepMind · ライティング · 画像 · コーディングGoogle EmbeddingGemma 2 は 7 億 4000 万パラメータのオープンなモデルで、テキスト、コード、画像、音声、動画フレームを同じ 768 次元空間のベクトルに変え、スマートフォンやノート PC 上で動く。

GitGlow
GitGlow · コーディング · 生産性向上GitGlow は自分のコードと AI エージェントの変更を一つのレビューにまとめるデスクトップ Git クライアントだ。出荷前に、マシンから何が出ていくのかを確かめられる。