
Griffin by Tavus
Tavus · 音声・言語 · 動画 · チャットボット
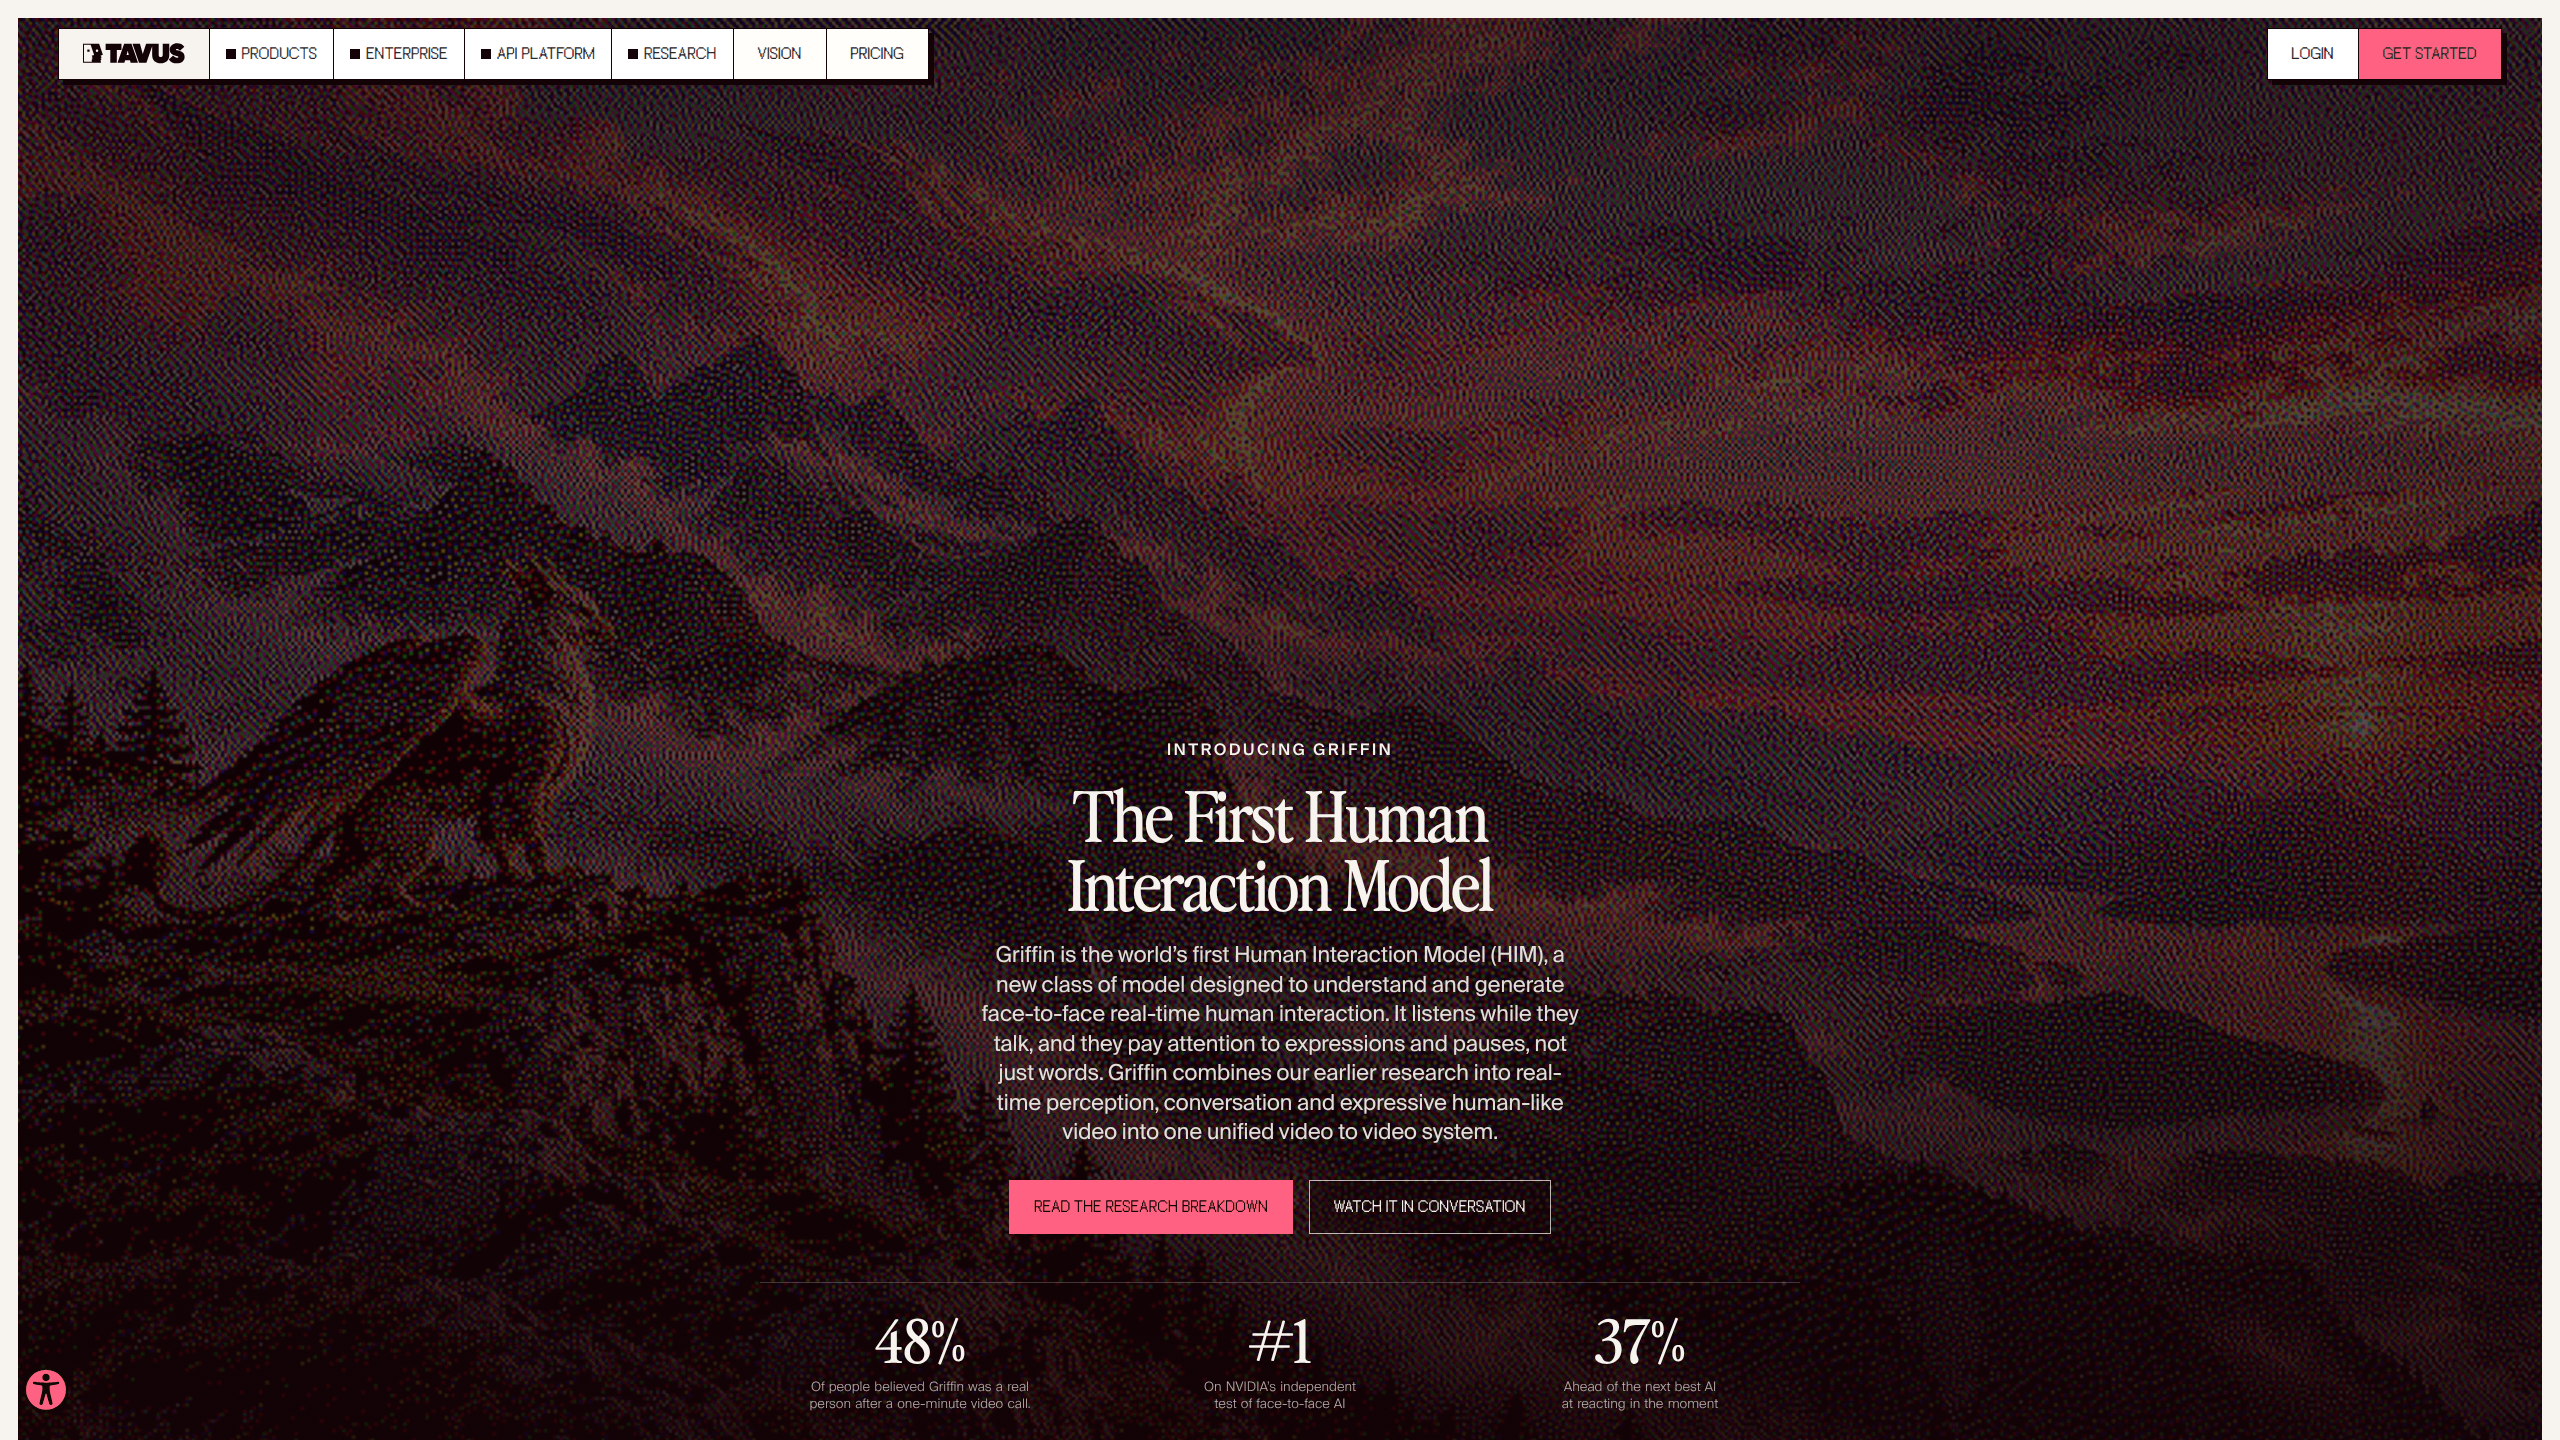
Griffin by Tavus は最初のヒューマンインタラクションモデルだ。全二重の動画から動画へのシステムで、AIビデオ通話の最中に相手を見て、聞いて、即座に応答する。
Griffin by Tavus について
What Is Griffin by Tavus
Griffin は Tavus の研究モデルで、ビデオ通話の中で対面の会話を成立させる。カメラとマイクを同時に読み取り、自分で話し出すタイミングを決め、通話の進行に合わせて相手の顔と声を生成する。Tavus は2026年10月1日に発表し、最初のヒューマンインタラクションモデル(HIM)と呼んでいる。
設計は従来の積み上げ式と違う。多くの対話型動画システムは音声認識、言語モデル、音声合成、アバター描画を順番につなぎ、こちらが話し終わるのを待ってから動き出す。Griffin は0.数秒ごとに会話の状態を判断し直す。だから相手が話している最中にうなずけるし、考え込むための沈黙を「発言の終わり」ではなく「間」として扱える。遮られても話の筋に戻れる。
その代償は利用条件にある。現在存在する Griffin-Lite は研究プレビューで、信頼できる少数のテスターに限られる。Tavus は自社プラットフォームにはまだ載せていないと明言し、価格も公開していない。公開APIもない。48%という数字は Tavus 自身が実施した調査によるもので、被験者は54人、通話は1分間だ。
Getting Started
- tavus.io/griffin を開き、アクセス申請フォームを送る。招待制なので、登録ボタンを押しても席が保証されるわけではない。
- 承認されたら、届いたリンクから AIビデオ通話に参加する。端末へのインストールは不要だ。
- カメラとマイクを許可し、同僚と話すように声を出す。AIアバターはこちらが話している間に応答を生成する。
- 検証は一度に一つ。文の途中で遮る、考え込んで黙る、物をカメラに近づける。それぞれに対する反応を見る。
- この通話は評価の場と割り切る。管理画面も書き出しも請求ページもない。Griffin-Lite は顧客向けの製品ではない。
AIツール情報
Griffin by Tavusの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- リアルタイムの動画エージェントを作るプロダクトチーム。Griffin は開発工数を投じる前に、対面エージェントの手触りを確かめられる。利用は承認済みテスターに限られるため、公開日ではなく申請フォームを前提に計画を立てたい。
- 企業研修の担当者。学習者の表情に反応するモデルは、切り出しにくい会話の練習に向く。プレビューには管理機能がないので、評価段階にとどめておく。
- 対話型AIの研究者。公開された VideoFDB のスコアと調査手法は具体的な比較軸になる。Tavus は重みもモデルカードも公開していないため、比較は振る舞いの水準にとどまる。
タスク
- 営業電話の練習。遮り、相づち、口調の変化がある相手と商談の初回通話を演じる。声を付けたテキストチャットより、実際の買い手に近い。
- 面接の練習。構造化面接を進め、こちらが考える間の沈黙をどう扱うかを見る。詰まった人には、先を促す代わりに本物に近い間が返ってくる。
- 語学の練習。ためらいや発音の誤りに反応する顔に向かって話す。視覚的な手がかりを読むので、言葉だけでなく困った表情にも反応する。
- サポートのエスカレーション準備。こちらに被せて話す怒った顧客との通話を演じる。全二重の処理は、台本付き研修がたいてい飛ばす部分だ。
シーン
- 動画エージェントが業務の流れに合うか判断する。短い通話のほうが、機能表より生成された顔への人の反応を教えてくれる。
- 開発前に遮りへの対応を試す。製品に割り込みが必要なら、同じ遮りを5回繰り返し、タイミングが保たれるか確認する。
- 規制のある会話を点検する。医療や金融のチームは、AIであることの開示と同意の仕組みが整っているか判断できる。このプレビューでは整っていない。
主な機能
全二重の会話
Griffin は話しながら聞いている。発言権を保つことも、譲ることも、遮られたら止まることもでき、自分の応答中も会話の追跡を続ける。Tavus はこれをターンごとの受け渡しではなく連続したループとして作った。だから文中の沈黙で発言が自動的に終わることはない。
シーン全体の生成
モデルは基準画像1枚から画面のすべてのピクセルを生成する。顔、手、座っている椅子、影、背景まで含む。多くのアバターは切り抜いた頭部だけを動かすので、手が動くと嘘が露呈する。Griffin にはその継ぎ目がない。
リアルタイム動画の720p出力
通話を続けながら720pで映像を出す。潜在表現を1つずつ生成する方式だ。Tavus の測定では、H100上で最小の映像チャンクに平均0.43秒、最良で0.27秒かかった。通話で効くのは、遮ってから顔が反応するまでの間隔であり、0.5秒なら注意を向けているように見える。
視覚による知覚
Griffin が受け取るのは音声だけでなく映像だ。視線、表情、身ぶり、カメラに映した物を捉え、共有された画面も読む。壊れた部品を掲げたときや、考えるために目をそらしたときに反応するのは、言葉の書き起こしに答えるのではなく、その場を見ているからだ。
感情とふるまいの表現
モデルは会話の文脈に応じて声の調子、表情、身ぶりを変える。笑うべき場面で笑い、話題が重くなれば表情を引き締め、言葉以外の信号でこちらの発言を受け止める。Tavus はこうした振る舞いを、何を話すかを決める同じシステムの中で学習させた。後から足した層ではない。
短い音声からの声の複製
Griffin の音声生成は、約10秒の基準音声から声を複製する。Tavus 製の音声コーデック Tavec を使い、10ミリ秒単位のパケットで流す。ブランドのAIアバターを作る側にとって、これだけ短いサンプルで済むなら収録の手間が1工程減る。
メリットとデメリット
メリット
- Tavus の実地調査では、被験者の48%が相手を人間だと思った。同社の従来構成 Phoenix-4.5 では2.4%だった。
- Griffin-Lite は NVIDIA の VideoFDB 生成トラックで3.83を記録した。人間の基準は3.92、次点のAIシステムは2.80だ。
- 遮りや相づちを処理しても話の筋を失わない。音声とアバターを直列につなぐ構成が最も崩れやすいところだ。
- シーン全体を生成するため、手、姿勢、背景が会話に合わせて動く。固まったままにならない。
- 声の複製に必要な音声は約10秒で済む。独自のAIアバターを短時間で用意できる。
デメリット
- 購入できない。Griffin-Lite は承認済みテスター限定で、一般公開の日程もない。ローンチを前提にした計画は立てられない。
- 公開API、モデル識別子、価格がない。開発者は自社環境で測ることも、予算に組み込むこともできない。
- 48%は54人・1分間の通話による、開発企業自身の調査だ。長い通話や第三者による再現は未検証のままである。
- 知覚トラックには差がある。3.73に対し人間は4.20、応答時間は2.2秒に対し1.4秒。複雑な視覚情報ではまだ崩れる。
よくある質問
Griffin は、対面の会話をリアルタイムで成立させる全二重の動画から動画へのモデルだ。Tavus がヒューマンインタラクションモデルと呼ぶのは、知覚、発言の判断、映像と音声の生成を1つのシステムで処理し、音声・言語・アバターのモデルを継ぎ合わせないからだ。
関連コンテンツ
Griffin by Tavusに関連するツール、スキル、記事を探す。
Griffin by Tavusの代替ツール

Foley
Hanamori Labs, LLC · 音声・言語 · 生産性向上 · AIアシスタントFoleyは音声ToDoリストだ。話した一文をプロジェクト・日付・時刻まで入ったタスクとして整理し、その後はすでにあるリストを軸に一日の順番を組み立てる。

HireKey
HireKey · 音声・言語 · 生産性向上 · 学習HireKey は元テック業界リクルーターが作った AI 求職コパイロット。求人適合分析、職務経歴書のカスタマイズ、面接練習、応募管理を一つの画面にまとめる。

Fluence
Yay Software (Yannick Huchard) · ライティング · 音声・言語 · 生産性向上Fluence は Android 向けのドキュメントリーダーだ。PDF、EPUB、Word 文書、ウェブ記事を読み上げ、発話中の文を画面で追わせ、本文についての質問にも端末上で答える。