
l1m.io
l1m.io · コーディング · その他
l1m.ioはテキストからJSONへの変換と、画像からJSONへの変換を一度の呼び出しでこなす構造化データ抽出APIである。スキーマを定義して内容を送れば、指定したフィールドだけがそのまま返ってくる。
l1m.io について
About
l1m.ioとは
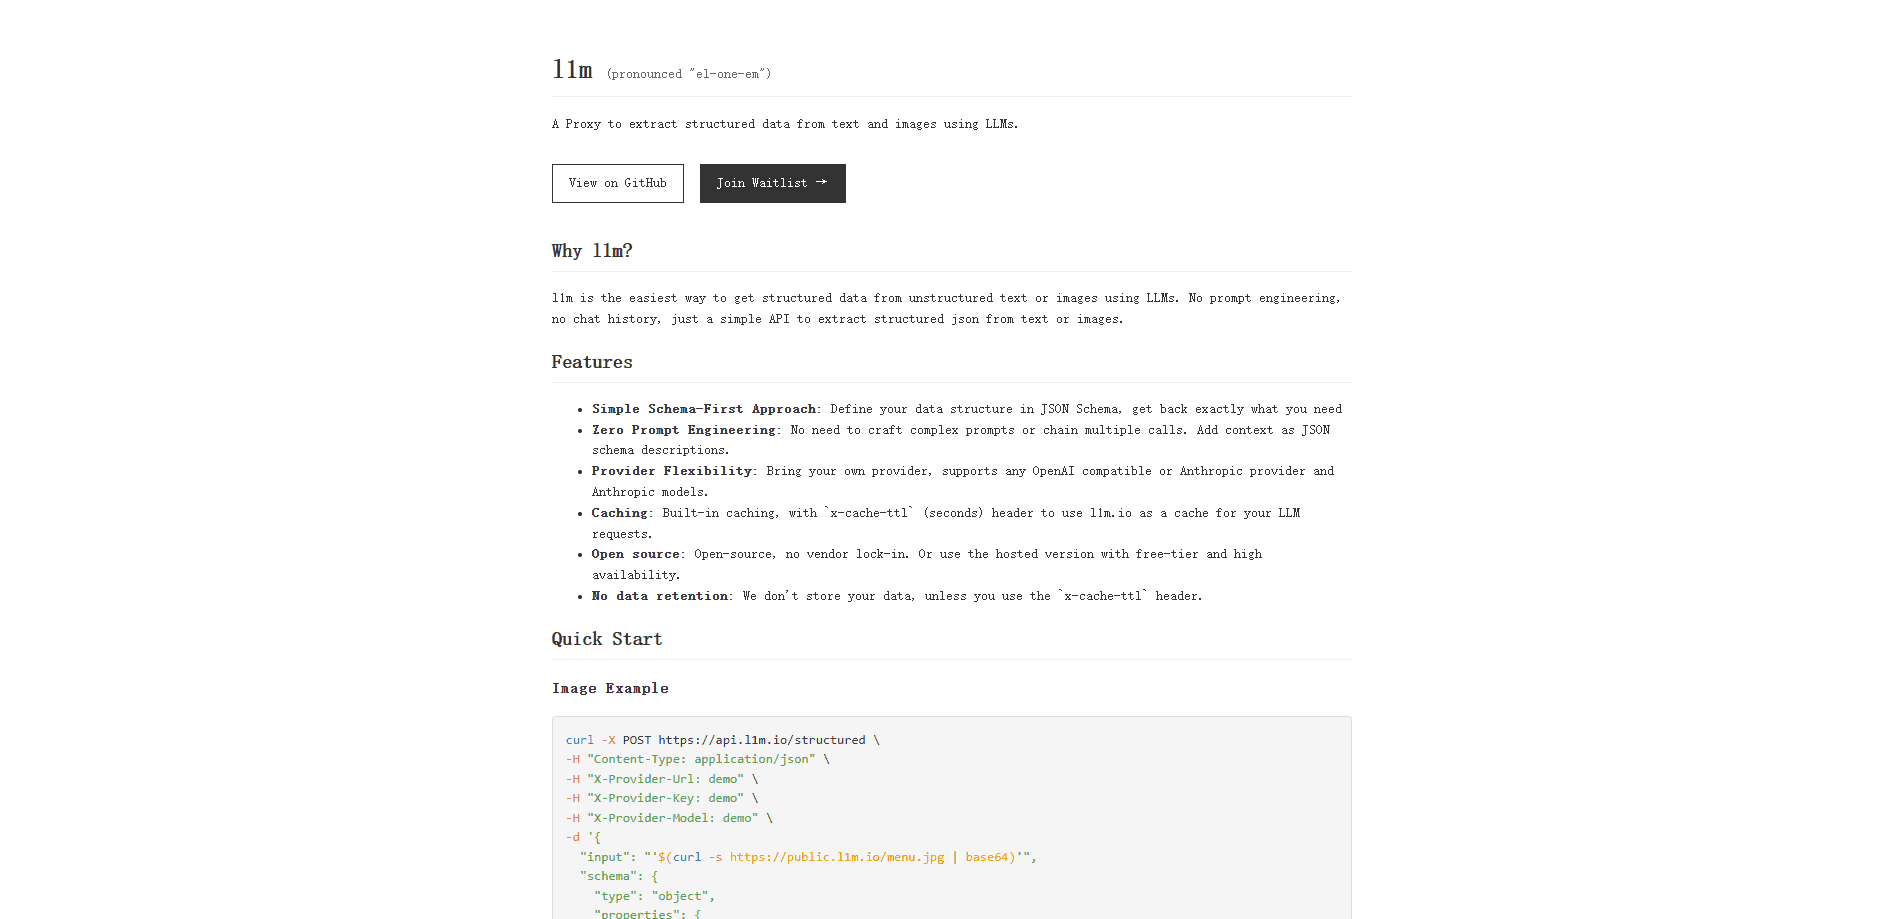
l1m.ioは、大規模言語モデルを使って形式の定まっていないテキストや画像から構造化データを引き出す、開発者向けの小さなツールである。狙いは明快で、プロンプト作成を省ける。欲しい答えの形をJSONスキーマとして書き、入力を送ると、そのスキーマに合うJSONオブジェクトが返る。管理すべき対話履歴も、調整すべき複数段のプロンプト連鎖もない。
これが解決するのは、LLMの上に何かを作るときの、往々にして一番厄介な最後の工程、すなわちLLMデータ抽出そのものだ。モデルに固定された機械可読な形で答えさせるのは手間がかかり、脆いプロンプトは入力が変わった瞬間に崩れる。この構造化JSON APIはその作業をスキーマ自体へ移す。出力の取り決めは、命令文の段落ではなくデータ構造の中に置かれる。モデルがスキーマに合う結果を返せなければ、崩れた塊ではなく422エラーが返る。
使い込む前に押さえておきたい制約もある。ホスト版はまだオープンベータで、正式版の提供に向けてチームは順番待ちリストへの登録を求めている。対応するスキーマはJSON Schemaの一部分であり、完全な仕様ではない。oneOfやanyOf、allOf、min/maxLengthといった記法は使えない。加えて開発者向けのAPIであってアプリではないため、利用には多少のコードが要る。
はじめかた
- APIキーを作成する。最初のテスト呼び出しなら、ドキュメントに載っているデモ用プロバイダのヘッダーで始めてもよい。
- プロバイダのURL、キー、モデルの各ヘッダーを設定して、リクエストをどこに向けるか決める。自分のOpenAI互換アカウントやAnthropicアカウントを持ち込んでも、ローカルモデルを使ってもよい。
- 構造化エンドポイントに、入力と欲しいフィールドを記述したJSONスキーマを添えてPOSTリクエストを送る。
- dataプロパティからJSONオブジェクトを読み取る。同じ結果を再利用したければキャッシュTTLヘッダーを設定する。
AIツール情報
l1m.ioの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- LLMの上に作る開発者:モデルの答えを決まった形で受け取りたい人は、整形をスキーマに任せられる。RESTとJSONの基礎は必須だ。
- バックエンドとデータのエンジニア:請求書や出品情報、ログをデータベースに流し込むチームには、入って出るJSONの取り決めが向く。PythonかNode.jsが少しかじれると楽だ。
- 個人開発者と試作を重ねる人:抽出のアイデアを一人で試すなら、課金の前に無料枠とデモ用エンドポイントへ頼れる。
タスク
- レシートやメニュー写真から明細を抜く:名前と価格のスキーマを添えてbase64画像を送れば、解析ルールを書かずに配列が返る。
- 自由記述のテキストをフィールドに振り分ける:サポートチケットや段落を渡して、種別や話題、感情、優先度を持つオブジェクトを受け取る。
- リクエストを正しい操作へ振り分ける:enumフィールドでモデルに固定のツール一覧から選ばせ、あとは自分のコードで分岐する。
- 繰り返すLLM照会をキャッシュする:TTLヘッダーを設定すれば、同一のリクエストはモデルを呼び直さずメモリから返る。
シーン
- 既存アプリに抽出の層を足す:すでにOpenAI互換プロバイダを呼んでいる製品は、整形の工程としてl1m.ioを前に置ける。
- 小さな予算でアイデアを試す:最初の500リクエストは無料なので、週末の試作は費用がかからない。
- ローカルモデルで非公開の流れを組む:データを外に出したくないチームは、プロバイダURLをトンネル経由の自前モデルへ向けられる。
主な機能
スキーマ抽出
出力をJSON Schemaオブジェクトで記述すると、サービスはその形に沿ったデータを返す。これがl1m.ioの仕組みの中心であり、スキーマ抽出という考え方の核だ。要件は巧みなプロンプトではなくスキーマの中に置かれる。ネストした配列とenumに対応しており、実際の抽出作業のほとんどをまかなえる。
プロンプト作成ゼロ
書くべきプロンプトも、管理すべき対話履歴もない。補足の文脈はスキーマのフィールド説明に書き込むので、モデルを導く文言は影響を与えるフィールドのすぐ隣に置かれる。抽出の手順は読みやすく、あとから変更しやすい。
プロバイダの柔軟さ
l1m.ioは特定のモデルベンダーに縛らない。いくつかのヘッダーを設定して自分のプロバイダを持ち込めば、OpenAI互換のエンドポイントでもAnthropicアカウントでも動く。デモ用プロバイダは用意済みの回答を返すので、本物のキーをつなぐ前にAPIを試せる。
キャッシュ内蔵
キャッシュTTLヘッダーを使うと、l1m.ioが抽出呼び出しのキャッシュになる。キーは入力、スキーマ、プロバイダキー、モデルのハッシュで、期間内の同じリクエストはモデルを再度呼ばず、キャッシュヒットのヘッダー付きで戻る。よく回す照会のコストを抑えられる。
オープンソースで囲い込みなし
プロジェクトはオープンソースなので、自分で動かせばホスト版に依存しなくてよい。ホスト版は無料枠と高い可用性を足したもので、インフラを自分で抱えたくないチームに向く。キャッシュを有効にしない限りデータは保持されない。
公式SDK
l1m.ioはNode.js、Python、Go向けのSDKを公開しているので、これらの言語でリクエストを手組みする必要はない。RESTエンドポイントはほかの何からでも呼べるため、自分の技術構成が対応外でも選択肢は残る。
メリットとデメリット
メリット
- スキーマベースの設計により、脆いプロンプト連鎖を、版管理して再利用できる構造へ置き換えられる。
- OpenAI互換の任意のプロバイダやAnthropicで動くため、今のモデル構成をそのまま使える。
- 無料枠が最初の500リクエストをまかない、アイデアの試作には十分だ。
- キャッシュヘッダーは追加コードなしで繰り返すLLM呼び出しのコストを削る。
デメリット
- ホスト版はまだオープンベータで、本番で頼る前に順番待ちリストを通る必要があるかもしれない。
- スキーマはJSON Schemaの一部分で、oneOfやmin/maxLengthといった記法は使えない。
- 開発者向けのAPIであり、コードを書かない人には代わりになるクリック操作の画面がない。
よくある質問
テキストや画像を構造化JSONへ変換する。欲しいフィールドを記述したスキーマを渡すと、APIがそれに合うオブジェクトを返すので、自分で解析やプロンプトのロジックを書かずに済む。
関連コンテンツ
l1m.ioに関連するツール、スキル、記事を探す。
l1m.ioの代替ツール

Base Code
Base44 (Wix) · コーディング · 生産性向上Base CodeはBase44の共有クラウド開発環境だ。既存のGitHubリポジトリに対する変更をチャットで伝え、プレビューで確認し、プルリクエストとして返せる。

Google EmbeddingGemma 2
Google DeepMind · ライティング · 画像 · コーディングGoogle EmbeddingGemma 2 は 7 億 4000 万パラメータのオープンなモデルで、テキスト、コード、画像、音声、動画フレームを同じ 768 次元空間のベクトルに変え、スマートフォンやノート PC 上で動く。

GitGlow
GitGlow · コーディング · 生産性向上GitGlow は自分のコードと AI エージェントの変更を一つのレビューにまとめるデスクトップ Git クライアントだ。出荷前に、マシンから何が出ていくのかを確かめられる。