
Liquid Inference
Architect Financial Technologies Inc. · コーディング · 生産性向上
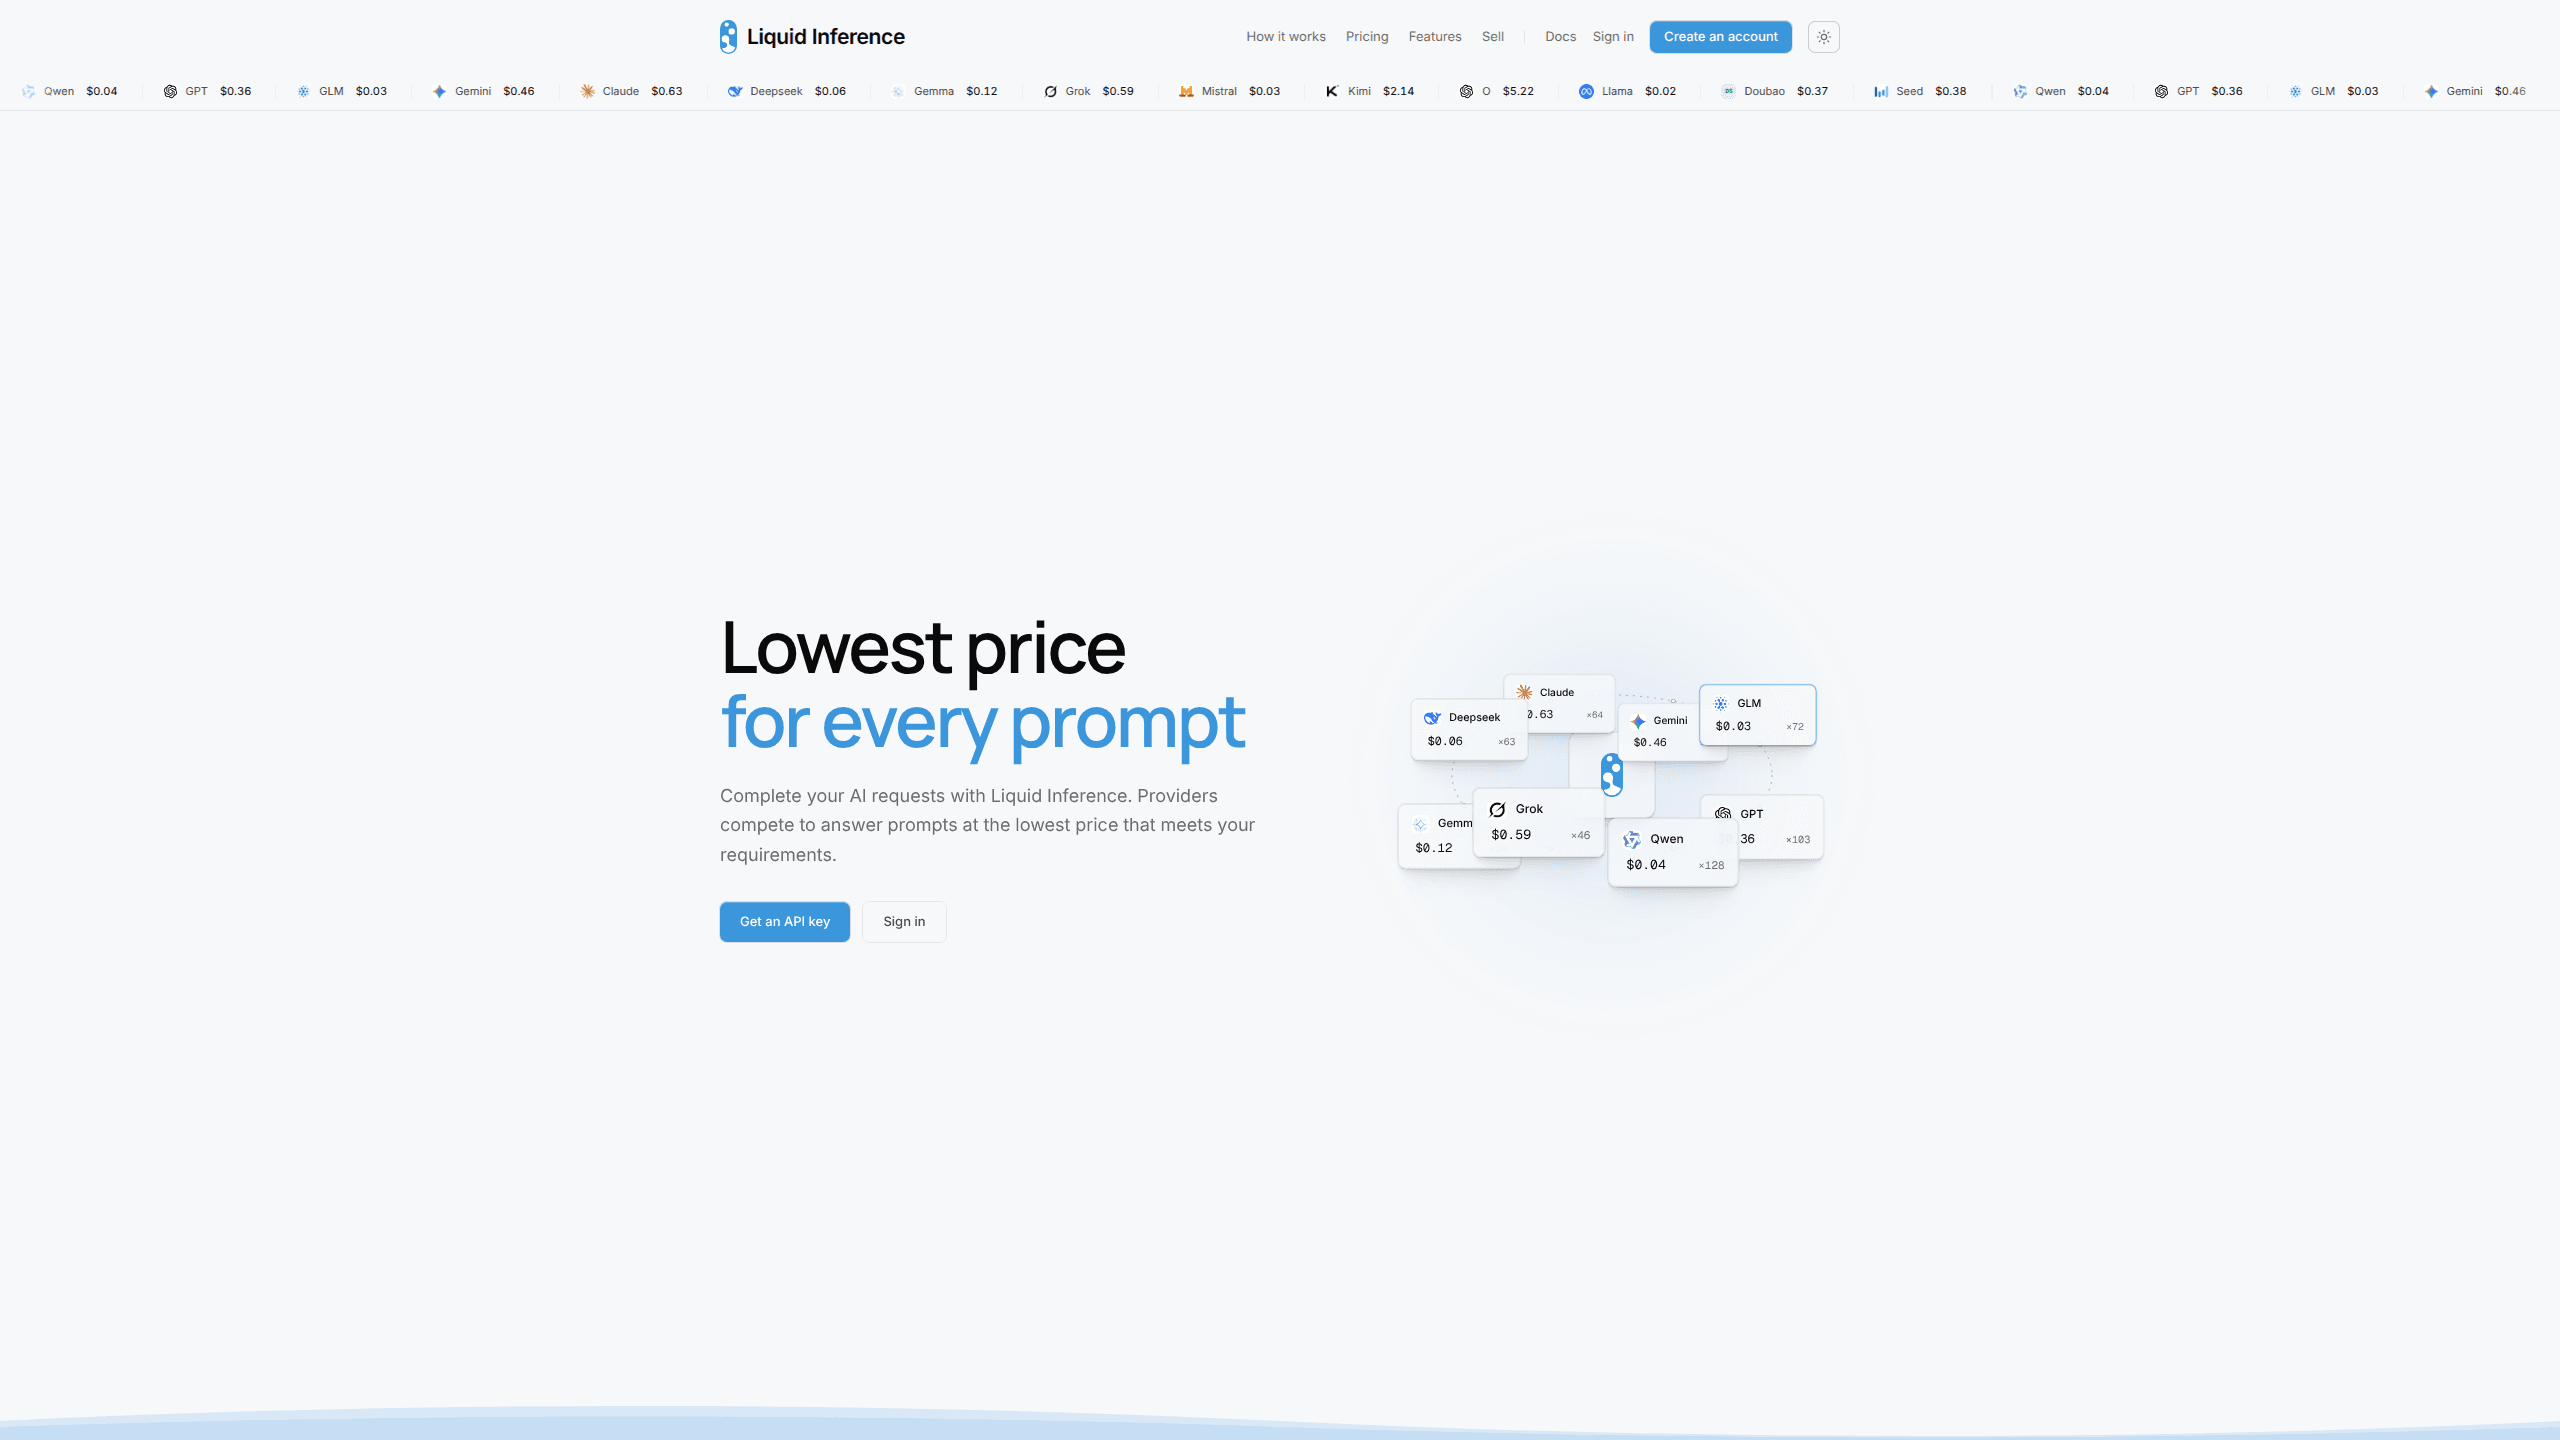
Liquid Inference は Architect が運営する AI 推論マーケットだ。リクエストごとに競売を開き、条件を満たす最も安いプロバイダーへ処理を渡す。
Liquid Inference について
About
Liquid Inference とは
Liquid Inference は取引所のように動く LLM ルーターだ。プロバイダーは自社が提供するモデルごとにトークン単価を提示し、利用者のリクエストは条件を満たす中で最も安い提示に割り当てられる。入口はブラウザーのチャット画面と推論 API の二つで、API は OpenAI 形式と Anthropic 形式を受け付ける。
解いているのはモデルの問題ではなく請求の問題だ。同じオープンモデルを複数の事業者が動かしていても、多くのチームは閉じた API の定価を払い続けている。ここでは最初のトークンを出す前に価格上限が固定され、使わなかった分は残高に戻る。処理ごとに、落札したプロバイダーと確定した請求額を記したレシートが残る。
本番のワークロードを移す前に、制約は把握しておきたい。市場が動き出したのは 2026 年 10 月で、売り手の数も扱えるモデルもまだ変わる。品質は落札者によって差が出るため、購入ルールには遅延、スループット、地域の条件が用意されている。さらにトークンあたりの最低手数料があり、安いモデルでは表向きの 5% より重くのしかかる。
使い始める
- liquidinference.ai で登録する。ワークスペースが作られ、残高、API キー、レシートがまとまる。開始クレジットがあるので、カードなしで試せる。
- キーのページで API キーを作る。シークレットは一度しか表示されないので、閉じる前に控えておく。
- 既存の OpenAI または Anthropic クライアントのベース URL を取引所のものに変え、キーを差し替える。モデル名は取引所が公開している名前に合わせる。
- 必要ならリクエスト本文に
exchangeオブジェクトを足し、価格上限、最初のトークンまでの期限、保持ポリシー、許可するプロバイダーを指定する。 - レスポンスの
exchangeフィールドかレシートを見て、どのプロバイダーが落札し、いくらかかったかを確認する。
AIツール情報
Liquid Inferenceの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- コーディングエージェントを回す開発者
- 利用量が読みにくいスタートアップ
- 証跡を求められるプラットフォーム担当者
- 余った GPU を持つ事業者
タスク
- 費用上限つきのバッチ処理
- 同じプロンプトでモデルを比べる
- RAG と検索のパイプライン
- 画像、音声、文字起こしの購入
シーン
- エージェントのループが止まらず請求が膨らむ
- 長いバッチの途中でプロバイダーが落ちる
- 社内ツール向けに最安の LLM API を探したいが、全ての売り手を試す余裕はない
主な機能
リクエストごとの競売
リクエストはそのまま生きた注文板に入る。条件を満たさない提示は外され、残りが推定費用と予想待ち時間の合計で並べられ、最良の提示に処理が渡る。価格は生成前に固定されるので、最悪の請求額は先に分かる。
自分で決める購入ルール
任意の exchange オブジェクトが条件を運ぶ。ドル建ての上限、最初のトークンまでの最大時間、最低スループット、許可する地域、保持ゼロの要求、プロバイダーとモデルの許可・拒否リストを置ける。すべてを満たす提示だけが参加し、方針はサポートへの依頼ではなくリクエストのフィールドになる。
最初のトークン前の切り替え
落札したプロバイダーが何も出力しないうちに失敗した場合、処理は次の提示へ移る。出力が始まった後は切り替えないので、一つの回答が二つのモデルにまたがることはない。これはストリーミングのエージェントで効く。途中で相手が変われば、送信済みのツール呼び出しが壊れる。
レシートと公開マーケットデータ
決済済みの処理には、落札者、価格上限、使用トークン、手数料を記したレシートが付く。アカウント保持者はリアルタイムの注文板、プロバイダー別の気配値、成立した取引も見られる。これらのデータはリクエストを送る前に API で取得でき、あるモデルが普段より高い水準で取引されていないか確認できる。
自動ルーターと軸ごとのルーティング
liquid.auto を指定すると、公開スコアと推定費用をもとに、上限の範囲でモデルを選ぶ。premium、balanced、economy の三種類がある。モデル名に接尾辞を付けて、最も賢い、最も速い、最も安いの順に並べることもできる。どちらも下では競売が動いており、価格は競争する売り手から決まる。
既存のスタックにつながる
エンドポイントは OpenAI 互換 API として Chat Completions と Responses を扱い、Anthropic Messages の経路も持つ。公式 SDK はベース URL の変更だけで動く。Claude Code、Codex、Cursor、Cline、Open WebUI、n8n、Dify、LangChain など多数のツール向けに接続ガイドがある。Liquid CLI を使えば、同じキーでターミナルからコーディングエージェントを起動できる。
GPU 保有者向けの売り手側
プロバイダーはデプロイを登録し、モデルごとに価格を決め、セッション中に気配を出す。取引所は処理を振り分け、使用量を計測し、支払いを精算する。遊んでいる GPU があれば、自前の課金基盤を作らずに収益化できる。すでに別の場所で売っている事業者は、同じデプロイを第二の場としてここに並べられる。
メリットとデメリット
メリット
- 生成前に価格上限が固定されるため、出力上限を大きく取ったプロンプトでも請求が跳ねない。
- 使い慣れた SDK とクライアントをそのまま残せる。多くの場合、移行はベース URL とキーの差し替えで済む。
- 購入ルールが遅延、地域、データ保持をカバーするので、規制や社内規定のある処理にも使いやすい。
- レシートと公開注文板が、各処理の費用と担当したプロバイダーを記録する。
- 売り手側があるため、GPU 保有者は余剰能力を埋められる。別途課金の仕組みを用意しなくてよい。
デメリット
- 市場が新しい。2026 年 10 月の開始で、既存のルーターより売り手が少なく、扱えるモデルも予告なく変わりうる。
- 100 万トークンあたり 0.01 ドルの最低手数料が、安価な提示や無料の提示に重く効く。低価格モデルでは実質手数料がプロバイダー取り分の半分近くまで上がる。
- 出力の品質は落札者次第だ。競売が最適化するのは価格と申告された性能であり、個々の回答の良し悪しではない。公開スコアが高くても良い回答とは限らない。
- 出力が始まると別のプロバイダーへ移れない。途中で品質が落ちた場合、不完全な回答と再送が残る。
よくある質問
Liquid Inference は Architect Financial Technologies が運営する LLM 推論の取引所だ。プロバイダーが提供モデルの価格を公開し、各リクエストは買い手の費用、速度、地域、データのルールを満たす最安の提示に割り当てられる。ウェブ、API、CLI から使える。
関連コンテンツ
Liquid Inferenceに関連するツール、スキル、記事を探す。
Liquid Inferenceの代替ツール

Base Code
Base44 (Wix) · コーディング · 生産性向上Base CodeはBase44の共有クラウド開発環境だ。既存のGitHubリポジトリに対する変更をチャットで伝え、プレビューで確認し、プルリクエストとして返せる。

Google EmbeddingGemma 2
Google DeepMind · ライティング · 画像 · コーディングGoogle EmbeddingGemma 2 は 7 億 4000 万パラメータのオープンなモデルで、テキスト、コード、画像、音声、動画フレームを同じ 768 次元空間のベクトルに変え、スマートフォンやノート PC 上で動く。

GitGlow
GitGlow · コーディング · 生産性向上GitGlow は自分のコードと AI エージェントの変更を一つのレビューにまとめるデスクトップ Git クライアントだ。出荷前に、マシンから何が出ていくのかを確かめられる。