
LiteLLM
BerriAI · コーディング · その他
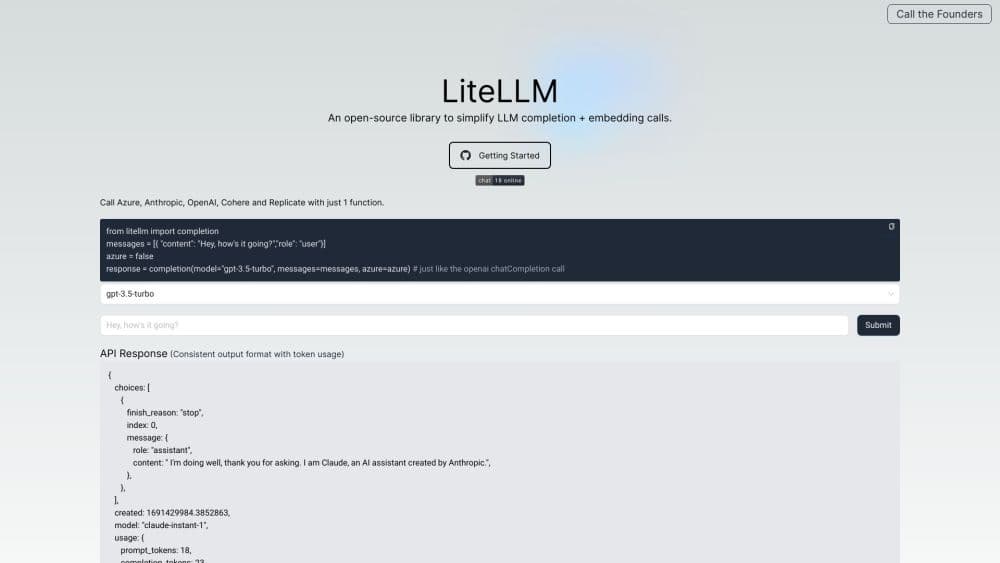
LiteLLMは、単一のOpenAI形式インターフェースで100以上のLLMを呼び出せるオープンソースのAIゲートウェイ兼Pythonライブラリだ。ルーティング、コスト管理、ガードレールを備える。
LiteLLM について
What Is LiteLLM
LiteLLMは、OpenAI、Anthropic、Gemini、Bedrock、Azure、Ollamaなど数十社のモデルをひとつのインターフェースで呼び出せるようにするBerriAIのツールだ。プロバイダーごとにSDK、認証方式、レスポンス形式を覚える必要はなく、呼び出しを一度書いておけば、バックエンドを変えたいときはモデル名を差し替えるだけで済む。
これが解決するのは、特定ベンダーへの囲い込みだ。ひとつのプラットフォームの上にシステムを組んだチームは、モデルを変えようとした段階で、リクエストの組み立て、エラー処理、ストリーミングのロジックをコード全体で書き直す羽目になる。LiteLLMはコードの下に翻訳層を置く。業務ロジックはそのままに、土台のモデルだけを設定ファイルで切り替えられる。
使い方は二通りあり、この二つでほとんど足りる。Python SDKはパッケージとして既存アプリに組み込み、ゲートウェイ(プロキシサーバー)はセルフホストのサービスとして動き、チーム全体の仮想キー、予算、ログを一元管理する。その便利さの代償は、ゲートウェイという運用すべきインフラが増える点で、オープンソース版は自前でのホストと更新を前提にしている。
Getting Started
uv add litellmかpip install litellmでパッケージを入れ、各プロバイダーのAPIキーを環境変数に設定する。- SDKを使う場合は
completionをインポートし、openai/gpt-4oやanthropic/claude-sonnet-4のようなモデル名でメッセージ配列を渡して呼び出す。 - ゲートウェイを使う場合は
litellm --model gpt-4oを実行するかDockerイメージを配備し、任意のOpenAIクライアントの接続先をローカルのベースURLに向ける。 - 複数のデプロイ間で再試行とフォールバックを効かせたいときはRouter設定を足し、ゲートウェイを複数インスタンスで回すならPostgresとRedisを接続する。
- 管理ダッシュボードかコールバックで利用状況を追い、トラフィックの増加に合わせてキー、ユーザー、チーム単位で予算を設定する。
AIツール情報
LiteLLMの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- バックエンドエンジニア:ひとつのアプリが同じコードから複数のモデルプロバイダーを呼ぶ必要がある場面に向く。モデルの変更が書き直しではなく設定変更で済むからだ。
- プラットフォームチームとMLチーム:社内の多くのチームがモデルへのアクセスを共有し、キー、予算、利用レポートを一か所にまとめたいときに合う。
- 実験を回すプロダクトマネージャー:同じプロンプトでモデルごとの出力を比べたいときに便利だ。呼び出しはそのままで、変わるのはモデル名だけだからだ。
タスク
- モデルアクセスの一本化:OpenAI、Anthropic、Bedrock、ローカルのOllamaサーバーへのリクエストを、OpenAI形式の単一エンドポイント経由で振り分ける。
- コスト管理:キーやプロジェクト単位で予算とレート上限を割り当て、ダッシュボードで積み上がる支出を確認する。
- 障害時の切り替えと負荷分散:同じモデルの複数デプロイにトラフィックを分散し、あるプロバイダーがエラーを返したら自動でフォールバックする。
- 可観測性:1行のコールバックでログとトークン数をLangfuse、MLflow、Heliconeといったツールへ送る。
シーン
- ひとつのプロバイダーから始め、業務ロジックに触れずに安価なモデルを足したいスタートアップ。
- モデルのトラフィックとキーを自社インフラ内に留めるため、ゲートウェイをセルフホストする企業。
- ひとつのスクリプトで同じプロンプトを5つのモデルに投げて比べる試作の場面。
主な機能
100社以上をまたぐ統一API
ひとつのインターフェースでOpenAI、Anthropic、Gemini、Bedrock、Azure、Vertex AI、Ollama、vLLMなどを幅広く扱える。返ってくる応答はすべてOpenAIのchat completions形式なので、choices[0].message.contentを読むコードはプロバイダーを変えても動き続ける。
そのまま差し替えられるOpenAI互換
すでにOpenAI SDKを使っているプロジェクトなら、ベースURLとキーを変えるだけでクライアントをLiteLLMゲートウェイに向けられる。リクエスト側のコードは一切触らずに済み、稼働中のアプリへマルチモデル対応を低リスクで足せる。
LLMプロキシサーバーとゲートウェイ
セルフホストのゲートウェイはチームの中央管制点になる。仮想キーを管理し、キー、ユーザー、チーム、組織ごとに支出を記録し、RPMとTPMの上限を適用し、日々の運用に使う管理ダッシュボードも備える。
再試行とフォールバック付きのRouter
Routerモジュールは同じモデルの複数デプロイを束ねる。失敗した呼び出しを再試行し、プロバイダーが落ちたら健全なデプロイへ切り替え、バックエンド間で負荷を均す。遅いエンドポイントがアプリ全体を止めるのを防ぐ。
コスト追跡と予算
LiteLLMは呼び出しごとのコストを算出し、それを発行したキーやプロジェクトに記録する。チームは月次予算とレート上限を設定でき、自前の計測を組まずに支出を確認できる。
可観測性とガードレール
1行のコールバックでログ、トークン数、トレースをLangfuse、MLflow、Heliconeなどへ送れる。ガードレールは危険な入力と出力をフィルタリングまたは遮断し、エラー変換はプロバイダー固有の例外をなじみ深いOpenAIの型に収める。
メリットとデメリット
メリット
- 単一のOpenAI形式インターフェースにより、プロバイダーごとに別のSDKを覚えなくて済む。
- モデルの変更は設定側で完結し、プロバイダー切り替えが本番コードを壊すリスクを下げる。
- オープンソースの中核はMITライセンスで無料、完全なセルフホストも可能だ。
- Routerの再試行とフォールバックが、プロバイダー障害時の可用性を高める。
- コスト追跡と予算により、これまで見えにくかった支出をチームが把握できる。
デメリット
- ゲートウェイは配備、監視、更新すべきサービスがひとつ増えることを意味し、小さなチームには運用負担になる。
- 複数インスタンスで回すにはPostgresとRedisが必要で、本格的な配備は相応のインフラを要する。
- SSO、SCIM、監査ログ、閉域網での配備といった機能は有料のEnterpriseプランに含まれる。
- 新しいプロバイダーの細かな仕様は公式SDKより遅れることがあり、あまり使わないエンドポイントでは追加設定が要る場合がある。
よくある質問
LiteLLMを使うと、アプリは単一のOpenAI形式インターフェースから多数のLLMプロバイダーを呼び出せる。モデルを変えるたびにコードを書き直さずに済ませたいときや、キー、予算、ログをセルフホストのゲートウェイに集約したいときに使われる。
関連コンテンツ
LiteLLMに関連するツール、スキル、記事を探す。
LiteLLMの代替ツール

Base Code
Base44 (Wix) · コーディング · 生産性向上Base CodeはBase44の共有クラウド開発環境だ。既存のGitHubリポジトリに対する変更をチャットで伝え、プレビューで確認し、プルリクエストとして返せる。

Google EmbeddingGemma 2
Google DeepMind · ライティング · 画像 · コーディングGoogle EmbeddingGemma 2 は 7 億 4000 万パラメータのオープンなモデルで、テキスト、コード、画像、音声、動画フレームを同じ 768 次元空間のベクトルに変え、スマートフォンやノート PC 上で動く。

GitGlow
GitGlow · コーディング · 生産性向上GitGlow は自分のコードと AI エージェントの変更を一つのレビューにまとめるデスクトップ Git クライアントだ。出荷前に、マシンから何が出ていくのかを確かめられる。