
LlamaIndex
LlamaIndex, Inc. · マーケティング · その他
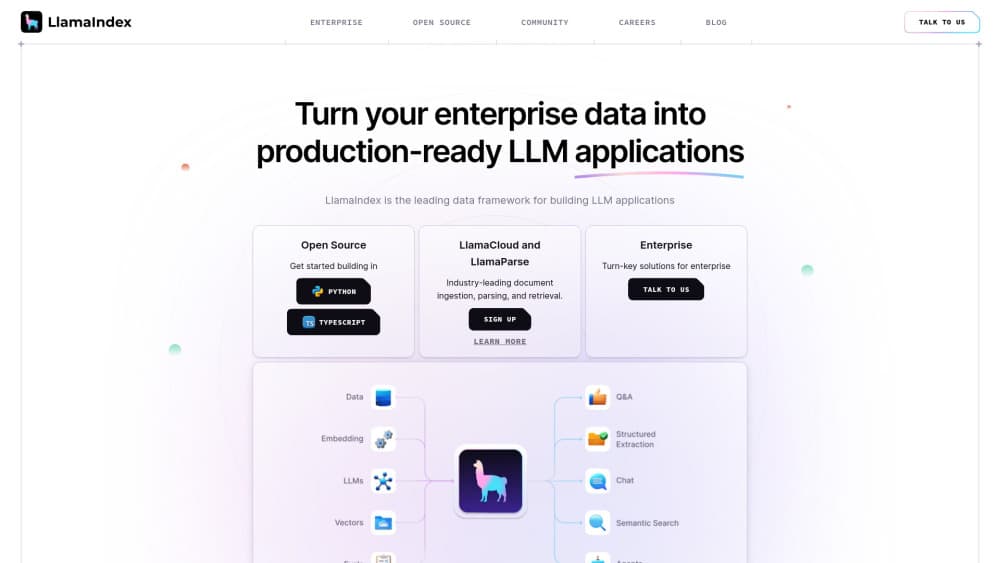
LlamaIndexはRAGアプリとAIエージェントを作るためのオープンソースデータフレームワークだ。手持ちのファイルを読み込み、索引化し、いつも使っているモデルにきれいな文脈を渡せる。
LlamaIndex について
About
LlamaIndexとは何か
LlamaIndexは、自分の文書と言語モデルのあいだに置くコードライブラリだ。2022年末にGPT Indexとして公開され、2023年に現在の名前に変わり、いまはサンフランシスコのLlamaIndex, Inc.が維持している。ライセンスはMITで、コードを読み、フォークし、商用製品に組み込んでも許諾を取る必要はない。
解いている問題は地味だが、なくならない。モデルは公開ウェブを知っていて、あなたの契約書やサポートチケットや実験ノートは知らない。LlamaIndexは、そうしたファイルを読み込み、ノードに分割し、ベクトルインデックスやキーワード索引に格納し、質問が来たときに必要な断片だけを取り戻す配管を提供する。この型がRAGであり、このライブラリは始めるときに大抵のチームが比べる二つの名前の一つだ。
会社はLlamaParseとLlamaCloudも販売している。文書解析、抽出、索引化を請け負うホスト型サービスだ。この分け方は重要で、フレームワーク自体は無料、スキャンしたPDFを使えるテキストに変える部分は商用でクレジット課金、しかも非公開だ。
最大の制約は開発者向けの道具だという点にある。オープンソース側にドラッグ&ドロップの画面はない。PythonかTypeScriptを書き、鍵を自分で設定し、回答が外れたら検索のどこが悪いかを自分で追う。
使い始める
pip install llama-index-coreで中核パッケージを入れ、続けて使うモデルのプロバイダー用パッケージを入れる。例はllama-index-llms-openai。- APIキーを環境変数に置く。ローカルモデルを動かしているなら Settings.llm をそちらに向ける。
- SimpleDirectoryReaderか、Notion、Slack、S3、データベース向けのLlamaHubコネクタでファイルを読み込む。
- 永続化できる索引を作る。多くはベクトルインデックスで、実行のたびに埋め込みを計算し直さないようディスクに保存する。
- 分岐、再試行、二つ目のエージェントが必要になったらクエリエンジンをWorkflowで包み、そのままサービスとして配備する。
AIツール情報
LlamaIndexの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- 初めてのRAGアプリを作るPython開発者。公式チュートリアルなら読み込み、索引化、問い合わせまで数十行で済む。ただしAPIキーかローカルモデルは自分で用意する。
- 文書検索製品を任されているAIエンジニア。検索の設定は差し替え可能なオブジェクトなので、実務の質問でチャンクサイズやリランカーを比べやすい。
- スキャン書類に埋もれたデータチーム。LlamaParseは素朴なPDF文字抽出が壊す表や手書きを読む。その代わりクレジットを食う。
タスク
- 社内文書への質問応答。フォルダやドライブをつなぎ、索引を作れば、当てずっぽうのチャット欄ではなく出典付きの答えが返る。
- 請求書、契約書、報告書の処理。抽出と分類の工程が、構造のないページをスキーマに沿ったJSONに変えるので、後段のコードは正規表現で文字を削らずに済む。
- 多段のAIエージェント構築。イベント駆動のワークフローが作業を各段に振り分け、取り返しのつかない処理の手前に人の承認を挟める。
- 検索戦略の比較。ハイブリッド検索、メタデータ絞り込み、リランカーは独立した部品なので、アプリを書き直さずに測定できる。
シーン
- 社内ナレッジベースの試験運用。中核が無料なので試す費用は小さく、検索が普通の検索窓に勝てるかを見極められる。
- 論文や特許の調査。長いPDFはまずドキュメント解析を通し、そのうえでクエリエンジンが何百本もの論文をまとめて扱う。
- インフラ予算のない初期プロダクト。オープンウェイトのモデルで全部を手元で動かし、実際に投げたモデル呼び出しの分だけ払う。
主な機能
実データソース向けのコネクタ
LlamaHubにはファイル共有、Notion、Slack、Google Drive、SQLデータベース、ウェブ巡回のためのローダーとパッケージが数百そろう。どれも同じDocumentオブジェクトにメタデータを付けて返すので、日付や著者での絞り込みはテキストの出どころに関係なく同じ書き方になる。この揃い方のおかげで、接続元ごとに別のアダプタを書かずに済む。
複数の索引とハイブリッド検索
検索の形は一つに縛られない。ベクトルインデックスは意味の近さを扱い、キーワード索引は固有名詞や型番を拾い、要約インデックスは段落ではなく文書全体を求める問いに答える。ルーターでつなぐか、両方の結果をまとめる検索器を使い、その上にリランカーを載せる。最初の失敗を一巡したあと、ほとんどのチームはハイブリッド検索に落ち着く。
イベント駆動のワークフロー
Workflowは以前の硬いチェーンを置き換えた仕組みだ。各ステップはイベントを購読し、型付きの結果を次へ渡し、繰り返し、分岐、人の承認待ちができる。普通の非同期Pythonなので、部分的な出力を利用者に流しながら残りを走らせられる。ノートブックを出たらそのままマイクロサービスとして配備できる。
LlamaParseによるドキュメント解析
LlamaParseは普通のローダーが壊れるファイルのためにある。スキャンページ、詰まった表、グラフ、手書き文字だ。出力はMarkdown、プレーンテキスト、ページ単位のJSON、XLSXから選べ、130を超えるファイル形式と80言語に対応するとしている。解析モードは案件ごとに選ぶので、きれいなデジタルPDFは安い設定、汚いスキャンは遅いエージェント設定に回せる。
LlamaCloudプラットフォーム
LlamaCloudは解析、抽出、分類、分割、索引化を一つのアカウントと一つのAPIキーの背後にまとめる。ウェブ画面でファイルを試し、設定を保存し、同じ設定をコードから呼ぶ。どの操作もクレジットを消費するが、キャッシュ済みの再解析は課金されない。プロンプトやスキーマを詰めるときに効いてくる。
評価とトレース
自作のテスト質問に対して、回答の忠実さと関連性を採点するモジュールが入っている。Arize PhoenixやLangSmithといったトレース基盤にもつながる。プロンプトを変えて製品が良くなったのかと聞かれたとき、数字で答えられる。この循環がないと、検索の調整は勘になる。
メリットとデメリット
メリット
- 検索が設計の中心にあるので、動くRAGパイプラインまでの糊コードは汎用エージェントフレームワークよりずっと少ない。
- 中核はMITライセンスで利用者ごとの課金もなく、スタック全体を自前で運用しても何も止められない。
- モデルとベクトルストアの提供元を差し替えられるため、一社の価格に縛られない。
- LlamaParseは表、グラフ、スキャンを読む。素朴な文字抽出ではゴミになる部分だ。
- Workflowが分岐、再試行、人の確認までライブラリ内で提供する。
デメリット
- すべてコードで書く。画面で組み立てたいチームは初日から開発者が必要になる。
- リリースが速くAPI名も変わるので、一年前のチュートリアルはimportの時点で失敗しがちだ。
- LlamaCloudはクレジット課金で、1,000クレジットが1.25ドル。実ファイルで試す前に月額を見積もるのは難しい。
- 最良のドキュメント解析は有料の非公開部分なので、完全にオープンな構成ではPDFの扱いが弱くなる。
よくある質問
フレームワークは無料でMITライセンスだ。WorkflowとLlamaHubの連携も含まれる。モデルのトークン代は提供元に支払い続けるし、LlamaCloudやLlamaParseの利用は別会計になる。
関連コンテンツ
LlamaIndexに関連するツール、スキル、記事を探す。
LlamaIndexの代替ツール

ngram 2.0
ngram · 動画 · マーケティングngram 2.0はチーム向けのAI動画生成ツールだ。プロンプト、画面録画、製品URLのいずれかから、ナレーション付きのAI解説動画、製品デモ、AIアバター動画を作れる。生成後も全シーンを編集できる。

shippedit.me
Krawlup · マーケティング · ビジネスshippedit.me は現在 Krawlup へ転送される。SEO、AEO、表示速度を毎週監査し、修正内容を MCP 経由で AI コーディングエージェントに渡すウェブプラットフォームだ。

MePersona
MePersona, Inc. · ライティング · 生産性向上 · マーケティングMePersonaはクリエイター向けのAI統合受信箱だ。あなたの話し方を学習し、12プラットフォームに届くファンメッセージの返信を下書きして、承認したものだけを送る。