
Middleware Observability Platform
Middleware · コーディング
Middlewareは、ログ、メトリクス、トレース、実際のユーザーセッションを1本のタイムラインに集約し、AIエージェントで障害の原因を突き止めて修正案まで出すクラウド可観測性プラットフォームだ。
Middleware Observability Platform について
About
Middlewareとは
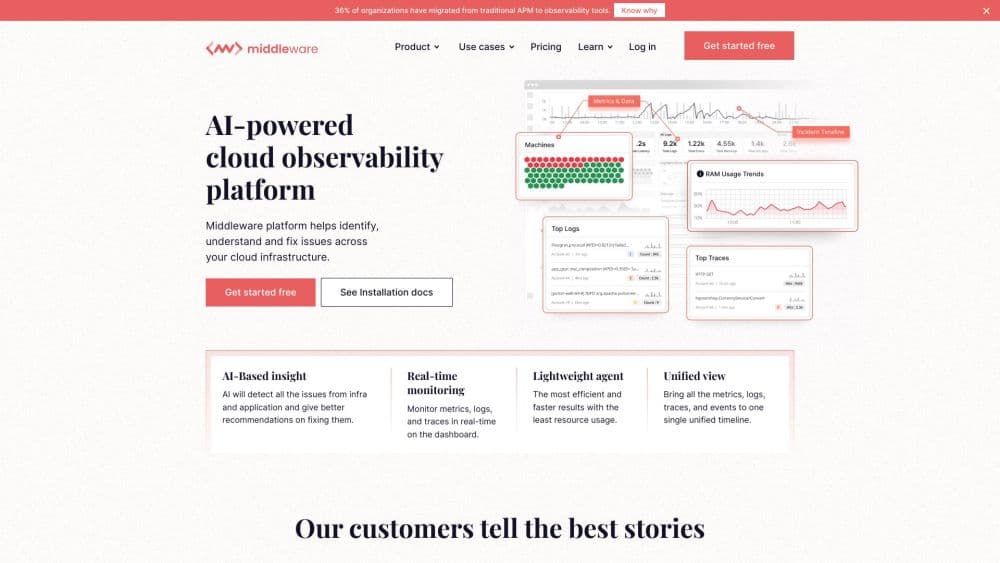
Middleware Observability Platformは、Kubernetes、仮想マシン、マネージドデータベースの上でアプリケーションを動かすエンジニアリングチーム向けのクラウド監視サービスだ。メトリクス用、ログ用、アプリケーション監視用のツールを別々に契約する代わりに、エージェントを1つ入れるだけで全部が同じ画面に並ぶ。この共通のタイムラインは、遅いAPIコール、エラーログ、ユーザーセッションの再生が同じリクエストコンテキストで横に並ぶため、障害が起きたときに効いてくる。
運営元は同名のMiddlewareで、Netflix、DigitalOcean、Google、Ciscoを経たエンジニアが2022年に立ち上げた。データはホストエージェント、言語ごとのSDK、サードパーティ連携から取り込み、OpenTelemetryにも対応する。すでに動いているコレクターや他社エージェントをそのまま流し込めるということだ。料金は従量制で、売り文句は機能の網羅性ではなく総保有コストにある。
制約は最初に押さえておきたい。ホスティング型のため、自前クラウド持ち込みのオプションを契約しない限りデータはネットワーク外に出る。深いコンプライアンス対応や長期保存は個別契約の範囲だ。AIエージェントは中核の監視機能より後から登場しており、変更管理が厳しいチームは自動プルリクエスト機能をよく確認してから有効にしてほしい。
はじめかた
- app.middleware.ioでアカウントを作り、Google、GitHub、メール、Okta SSO、Microsoft Entra IDのいずれかでログインする。
- インストールページを開き、プロジェクトのMW_API_KEYとMW_TARGETを控える。
- 環境に合わせて選ぶ。KubernetesのDaemonSet、Linux向けホストエージェント、JavaやPython、Node.jsのSDK、あるいはAWS、Azure、Prometheus、Datadogとの連携だ。
- エージェントを配備し、数分以内にダッシュボードへデータが届くことを確認する。
- チームが必要とするシグナルでビューとアラートを組み、その後でOpsAIの異常検知を有効にする。
AIツール情報
Middleware Observability Platformの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- DevOps・SREチーム
- 予算の限られたスタートアップ
- LLM機能を開発するバックエンドエンジニア
タスク
- 遅いエンドポイントの原因を特定する
- Kubernetesクラスタを健全に保つ
- データベースのクエリを追う
- APIが外部から応答するか確かめる
シーン
- 深夜2時の本番障害
- リリース週のアクセス急増
- 月次のコスト見直し
主な機能
OpsAIによる検知と修正
OpsAIはアプリケーション、インフラ、データベース、コンテナ、ログ、LLMアプリを同時に見張り、見つけた兆候をシグナル間で突き合わせる。価値が出るのはアラートの次の段階だ。有力な原因を示し、修正案を出し、プルリクエストまで開ける。エラー検知そのものは無料で、原因分析はトークン課金なので、すべての障害にAIを走らせたくないチームでもアラートだけは残せる。
アプリケーションパフォーマンス監視
APMモジュールはスパンをリアルタイムに記録し、APIエンドポイントから触れたデータベースまでリクエストを追う。継続プロファイリングはどの関数がCPUを消費しているかを示し、これは遅いトレースとは別の問いに答える。トレースは時間がどこへ消えたかを、プロファイルはどのコードが消したかを教えてくれる。トラフィックマップと依存関係のビューは、障害を非エンジニアに説明する場面で役立つ。
QueryGenieを使ったログ管理
ログはどんなJSONソースからでも入るため、出力を整形し直す必要はない。属性一致、あいまい一致、正規表現で検索でき、デプロイ中はライブ表示を止めて再開できる。QueryGenieは自然言語の依頼をクエリに変換するので、構造化クエリを日常的に書かない人でも扱える。機密データのマスキングと独自属性の抽出は保存前に行われ、ログに顧客情報が含まれる場合に効いてくる。
インフラとKubernetesの監視
インフラ監視とKubernetes監視は同じエージェントで動く。自動インストルメンテーションがホスト、Kubernetesクラスタ、Linuxノード、クラウドサービスをカバーし、マシンごとのスクリプトは要らない。クラスタの健全性、CRD、ネットワークポリシーを1つのビューに集め、コンテナワークロードにはECSレベルの詳細も出す。CPUスパイクをそれが引き起こした遅延と結びつける作業は、この製品が最初から狙った流れであり、チームが真っ先に実感する部分でもある。
リアルユーザーモニタリングとセッション再生
リアルユーザーモニタリングは、Webとモバイルアプリで利用者が実際に何を体験したかを記録し、遅いページ読み込みを引き起こしたバックエンドのトレースにつなぐ。セッション再生を使えば、利用者に状況を説明してもらう代わりに、画面とネットワークデータを並べて確認できる。プライバシー設定で項目を匿名化し取得範囲を絞れるため、個人情報を扱う製品でも使いやすい。
合成テストとブラウザテスト
合成チェックはHTTP、UDP、DNS、WebSocketのリクエストを複数拠点から定期的に送り、リクエストとレスポンスの詳細を残す。ブラウザテストはログインから決済までのような利用者の動線をスクリプト化し、複数のブラウザとデバイスプロファイルで実行する。サーバー側の監視では見えない部分、つまり外部からサービスに到達できて使えるかどうかを2つで補う。
データベースとLLMの可観測性
データベース監視とLLM可観測性は別のモジュールだが、共通のタイムラインでつながる。データベース監視はMySQL、PostgreSQL、MongoDB、Cassandra、Auroraのクエリ単位まで掘り下げ、CPU、メモリ、ディスク、スループットをクエリと並べて追う。LLMモジュールはプロンプト、エージェント、複数ステップのワークフローについてレイテンシ、トークン消費、コスト、応答品質、エラーを計測し、高コストや失敗したAI呼び出しを、それを生んだトレースとセッションに結びつける。
メリットとデメリット
メリット
- エージェント1つと画面1つで、ログ、メトリクス、トレース、インフラ、リアルユーザーモニタリング、合成テスト、LLMデータを扱えるため、障害の最中にツールを切り替えずに済む。
- OpenTelemetryベースの収集なので、既存のコレクター、Datadogエージェント、Prometheusの設定からそのままデータを流せる。
- 従量課金は100GBのデータと無制限ユーザーを含む無料枠から始まり、費用は人数ではなくテレメトリ量に比例する。
- データパイプラインでノイズの多いログソースを保存前に捨てられるため、請求額と検索結果の両方を抑えられる。
- OpsAIのエラー検知は無料で、提案されるコード変更はプルリクエストを通るため、レビュー担当が最終判断を握れる。
デメリット
- ホスティング型のため、個別契約で自前クラウド持ち込みを選ばない限りデータはネットワーク外に出る。
- 無料枠は14日、従量プランは標準で30日の保存期間しかない。監査後に1年分を振り返る必要があるチームには短い。
- 自動修復とコード変更の提案は規制の厳しい環境では実リスクを伴い、多くのチームは最初は切ったままにする。
- LLMの可観測性は中核のAPMやログより新しく、長く運用してきた競合と比べると深い連携の数は少ない。
よくある質問
Middlewareはインフラ、コンテナ、Kubernetes、アプリケーションのトレース、ログ、データベース、実際のユーザーセッション、合成チェック、LLMアプリを監視する。すべてがリクエストコンテキストで結ばれた1本のタイムラインに集まり、利用者の不満から原因となったクエリまでたどれる。
関連コンテンツ
Middleware Observability Platformに関連するツール、スキル、記事を探す。
Middleware Observability Platformの代替ツール

Base Code
Base44 (Wix) · コーディング · 生産性向上Base CodeはBase44の共有クラウド開発環境だ。既存のGitHubリポジトリに対する変更をチャットで伝え、プレビューで確認し、プルリクエストとして返せる。

Google EmbeddingGemma 2
Google DeepMind · ライティング · 画像 · コーディングGoogle EmbeddingGemma 2 は 7 億 4000 万パラメータのオープンなモデルで、テキスト、コード、画像、音声、動画フレームを同じ 768 次元空間のベクトルに変え、スマートフォンやノート PC 上で動く。

GitGlow
GitGlow · コーディング · 生産性向上GitGlow は自分のコードと AI エージェントの変更を一つのレビューにまとめるデスクトップ Git クライアントだ。出荷前に、マシンから何が出ていくのかを確かめられる。