
AI Secured
Mindgard Ltd · AI検出
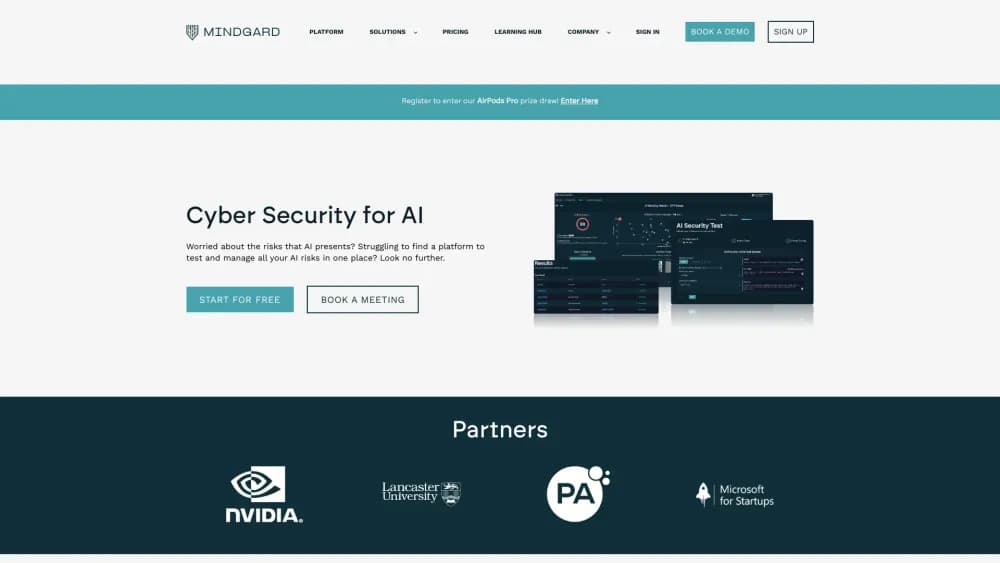
MindgardはAIレッドチーミングを自動化するセキュリティプラットフォームだ。LLM、エージェント、マルチモーダルモデルを検査し、実際に悪用できる欠陥を特定して、OWASPとMITRE ATLASへの対応づけまで行う。
AI Secured について
What Is Mindgard
MindgardはAIシステムの安全性を試すプラットフォームだ。チームは2022年にランカスター大学から独立し、現在はロンドンとボストンを拠点にする。モデル、アプリケーション、エージェントのいずれかを指定すると、本気の攻撃者と同じ手順で対象に迫る。まずシステムが届く範囲を洗い出し、緩いガードレールを探し、プロンプトとツール呼び出しを連鎖させて綻びを突く。
製品が担うのはテストの層で、フィルタの層ではない。ガードレールやファイアウォールは実行時に通信を止める。Mindgardが追うのは、そうした制御をすり抜ける通信そのものだ。再現手順、影響の説明、修正案をチームに渡す。この順番が効く。警告の壁を返すスキャナなら、すでに導入しているチームが多い。足りないのは、その警告が公開前に直す価値のある問題へ繋がるという証拠である。
導入前に押さえる制約は2つある。料金は見積もり制で、セルフサービス登録も無料枠もない。最初の確認は営業との会話から始まる。もう一つは、JSONをHTTPで話す到達可能なエンドポイントが必要なことだ。実際のリクエストを送って挙動を見るDAST系のAIツールでは当然の条件である。モデルがデスクトップアプリや私物のノートブックの中でしか動かないなら、Python SDKでの接続作業が増える。
Getting Started
- mindgard.aiでデモかトライアルを申し込み、対象システム、環境、テストの実行頻度という範囲を先に合意する。
- 対象を接続する。モデルの推論エンドポイントかアプリケーションのAPIがあれば足りる。Webコンソール、CLI、Python SDK、Burp Suite拡張は同じプロジェクトに繋がる。
- 基準となるテストを1回走らせ、結果は検出件数ではなく攻撃経路ごとに読む。各項目には実行した手順、レスポンスの証拠、対応するフレームワーク項目が並ぶ。
- 悪用できる箇所を直し、再テストで修正が効いていることを確かめ、同じテストをCI/CDに組み込む。次のモデル更新は会議なしで確認できる。
AIツール情報
AI Securedの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- LLM機能を本番に載せているAppSecチーム。プロンプトインジェクションへの漠然とした不安を、名前と証拠のある攻撃経路に変える。攻撃を許可されたエンドポイントと、結果を読める人材が前提だ。
- ツールを呼ぶエージェントを出すMLエンジニア。AIエージェントの安全性は権限とデータフローで決まる。Mindgardはチャットの返答だけでなく、その経路を試す。最初のスコープ打ち合わせには時間を取る。ツールの権限を正確に伝える必要がある。
- EU AI ActやNIST AI RMFのレビューを受けるコンプライアンス責任者。検出結果は見慣れたフレームワーク項目に対応づけられ、監査前の読み替え作業が減る。ただし業務上の重大性は人が判断する。
- ペネトレーションテスターやコンサルティング会社。CLIとBurp Suite拡張は進行中の案件に収まり、再テストも速い。顧客への説明と承認は自社の仕事として残る。ツールが渡すのは意見ではなく証拠だ。
タスク
- 公開前にチャットボットやコパイロットをレッドチーミングする。検証環境にライブラリを当て、悪用可能性で並べ、信頼されない深刻度スコアの代わりに優先順位付きの一覧を開発に渡す。
- モデルを差し替えた後の回帰テスト。既知の攻撃経路を基準として残し、ベンダーがバージョンを変えたら同じものを流す。機能テストでは見えないガードレールのずれが浮かぶ。
- 疑わしい欠陥を1つ追い込む。独自のプロンプトとデータセットを使えば、サポートbotのシステムプロンプト漏洩など特定のシナリオに照準を合わせられる。ライブラリ全体を流す必要はない。
- 監査用の証拠を揃える。結果をエクスポートし、リスク対応の記録に添付する。あくまで出発点であり、完成したコンプライアンス文書ではない。
シーン
- 返金を実行できるサポートエージェント。面白い失敗は無礼な返答ではない。攻撃者がエージェントを誘導し、承認すべきでない返金を通してしまうことだ。多段の攻撃がこの連鎖を覆う。
- 社内文書を引く検索アシスタント。プロンプトインジェクション検査は、汚染された文書が索引からデータを引き出せるか、モデルを方針外の回答へ押しやれるかを見る。
- 書類が機能より先に必要になる規制下のリリース。継続的にテストすれば、システムが変わるたびに新しい証拠が手に入る。8か月前の一度きりの評価より強い。
主な機能
エージェント前提の偵察
最初のペイロードを撃つ前に、Mindgardはシステムを把握する。どのモデルが答え、エージェントがどのツールとAPIに届き、ガードレールが奇妙な入力にどう反応するか。この輪郭が攻撃の向き先を決める。スキャナが項目を順に潰すやり方より、人が対象を絞る手順に近い。少ないリクエストで影響の大きい経路に届きやすい。
適応する攻撃経路
ライブラリにはジェイルブレイク、プロンプトインジェクション、データ抽出、ガードレール回避が入る。ただし単発のプロンプトで終わらせない。手順を繋ぎ、システムの返答に応じて次の手を変える。現実の攻撃者が無害な質問から結果を伴う操作へ進む流れを再現する形だ。攻撃は実行しながらMITRE ATLASの項目へ対応づけられる。範囲はLLMのセキュリティテストから、視覚、音声、マルチモーダルモデルまで広がる。
再現できる証拠
検出結果には、使ったプロンプト、返ってきた応答、両者を結ぶ経路が付く。エンジニアは同じ手順を再実行でき、管理者はリスクスコアを解読せずに影響の説明を読める。使えるレポートと警告の山を分けるのは、この部分だ。
修正案と再テスト
各検出には推奨する制御が付く。入力の前処理から出力フィルタ、ツール権限の絞り込みまで含む。修正を当てて同じ攻撃経路を流し直すと、きれいに通るか、まだ抜けられる別形が出る。この反復こそが目的である。単発のレポートではなく、繰り返しのテストのために作られている。
CI/CD、CLI、SDK、Burp Suite
GitHub Actionはワークフローを走らせるたびに最新のCLIを取得する。新しい攻撃手法が設定ファイルの編集なしで入る。Python SDKはネットワークにエンドポイントを出せないモデルを扱い、Burp Suite拡張はペネトレーションテスターが普段使う流れにAIのテストを差し込む。REST経由なら独自のパイプラインにも組み込める。
フレームワーク対応とレポート
結果はOWASP LLM Top 10、MITRE ATLAS、NIST AI RMF、EU AI Actの義務へ対応づけられ、レポートはSIEMやチケット管理に送れる。規制当局や顧客に「何を試したか」を示す必要があるチームにとって、この対応づけは読み替えの一手間を省く。その隙間が自社の事業にとって重大かどうかは判断しない。
テスト後の実行時保護
テストは隙間を見つけ、実行時保護はそこを使おうとする動きを監視する。Mindgardは本番のAI通信に対する検知と対応も提供する。欠陥の存在を証明した同じプラットフォームが、後から悪用の試行に印を付けられる。リリース前のテストだけを求めるチームはこの層を外してよい。
メリットとデメリット
メリット
- 検出結果に再現手順と応答の証拠が付く。深刻度スコアを巡って議論するより、選別と承認が速い。
- 攻撃の前に偵察を走らせるため、結果はツールやガードレールを含む実際のシステムを映す。切り離されたモデルエンドポイントを見ているわけではない。
- CLI、Python SDK、GitHub Action、Burp Suite拡張が既存のセキュリティと開発の流れに収まる。新しい運用を押し付けない。
- フレームワーク対応は監査で最も聞かれる4つを押さえる。OWASP LLM Top 10、MITRE ATLAS、NIST AI RMF、EU AI Act。
- 研究の裏付けは本物だ。150件を超えるAI脆弱性を公開し、AIセキュリティの博士号を持つ人材を抱える。攻撃の設計にそれが表れる。
デメリット
- 公開価格表も無料枠もセルフサービス登録もない。評価には営業との通話が要り、予算には範囲を定めた見積もりが要る。
- 最も簡単な経路には到達可能なJSONエンドポイントが必須だ。アプリの中に閉じたモデルは、テスト開始前にSDKの作業が発生する。
- 数千種類の攻撃シナリオといった網羅性の数字はベンダーの主張である。独立したベンチマークは確認していない。自分の実行結果が裏付けるまでは宣伝文句として扱いたい。
- 結果の読解には経験者が要る。悪用可能性は証明できても、自社のデータと利用者にとっての事業影響を測るのはチームの仕事だ。
よくある質問
AIシステムのセキュリティ欠陥を試すための製品だ。モデルやエージェントの構成を把握し、攻撃を実行し、実際に悪用できる弱点を確かめ、証拠と修正案をチームに渡す。セキュリティチームは公開前と、モデルや設定を変えるたびに使う。
関連コンテンツ
AI Securedに関連するツール、スキル、記事を探す。
AI Securedの代替ツール
Isgen AI
Isgen · AI検出Isgen AIは、テキストが機械によって書かれた可能性を採点し、どの文とフレーズがその数値を押し上げているかを示すウェブベースのAI検出ツールだ。教師、編集者、学生、ライター向けに作られている。問いは単純である。この下書きはChatGPT、GPT-5、Claude、Gemini、DeepSeek、あるいは別のモデルから出たものか。内容を貼り付けるかアップロードしてスキャンを実行すれば、数秒で人間・AI・混合の内訳が出る。書いている最中にテキストを採点する編集機能も備える。
Humanizeai Tools
Humanizeai Tools · ライティング · AI検出Humanizeai Toolsは、機械が生成した文章を人が書いたように聞こえる形へ書き換えるウェブベースのAIヒューマナイザーであり、これはこのカテゴリそのものの目的である。ChatGPT、Claude、Geminiの下書きを貼り付けてツールに通せば、AI検出ツールが引っかかる言い回しや文型を差し替えてくれる。公開前にAIテキストを人間らしくしたいなら、まさにそのために作られた種類のツールだ。自然に読めて、GPTZero、Copyleaks、Winston AIといったツールを一度で通過する必要がある学生、ブロガー、マーケターに向く。

Hidemyai
Hidemyai · ライティング · AI検出HidemyaiはAIコンテンツ専用のhumanizerだ。ChatGPTやJasperなどのツールが作った文章を、人間が書いたように読める形へ書き換える。下書きを貼り付け、文書タイプとトーンを選ぶと、Originality.ai、Turnitin、ZeroGPTといったAI検出ツールを回避することを狙った版が返ってくる。狙うのは、AIの下書きに頼りながらもロボットじみた文章を出せないライター、マーケター、学生。約束は単純で、AIコンテンツを検出不能にすることにある。