
StepFun
StepFun · その他 · 中国のAI
Step 3.5 FlashはStepFunのオープンソース基盤モデルで、スパースなMixture of Experts(MoE)方式として作られている。各トークンで196Bパラメータのうち11Bだけを有効化する。この設計により推論の強さを保ちながら、生成速度を毎秒100〜300トークンまで引き上げている。遅いモデルを待ちたい人などいるだろうか。いない。AIエージェントモデルとして、コーディング支援や長文コンテキストの作業に向く。そこで速度は、そのツールを実際に使うかどうかを決める。
StepFun について
StepFun Step 3.5 Flashとは何か
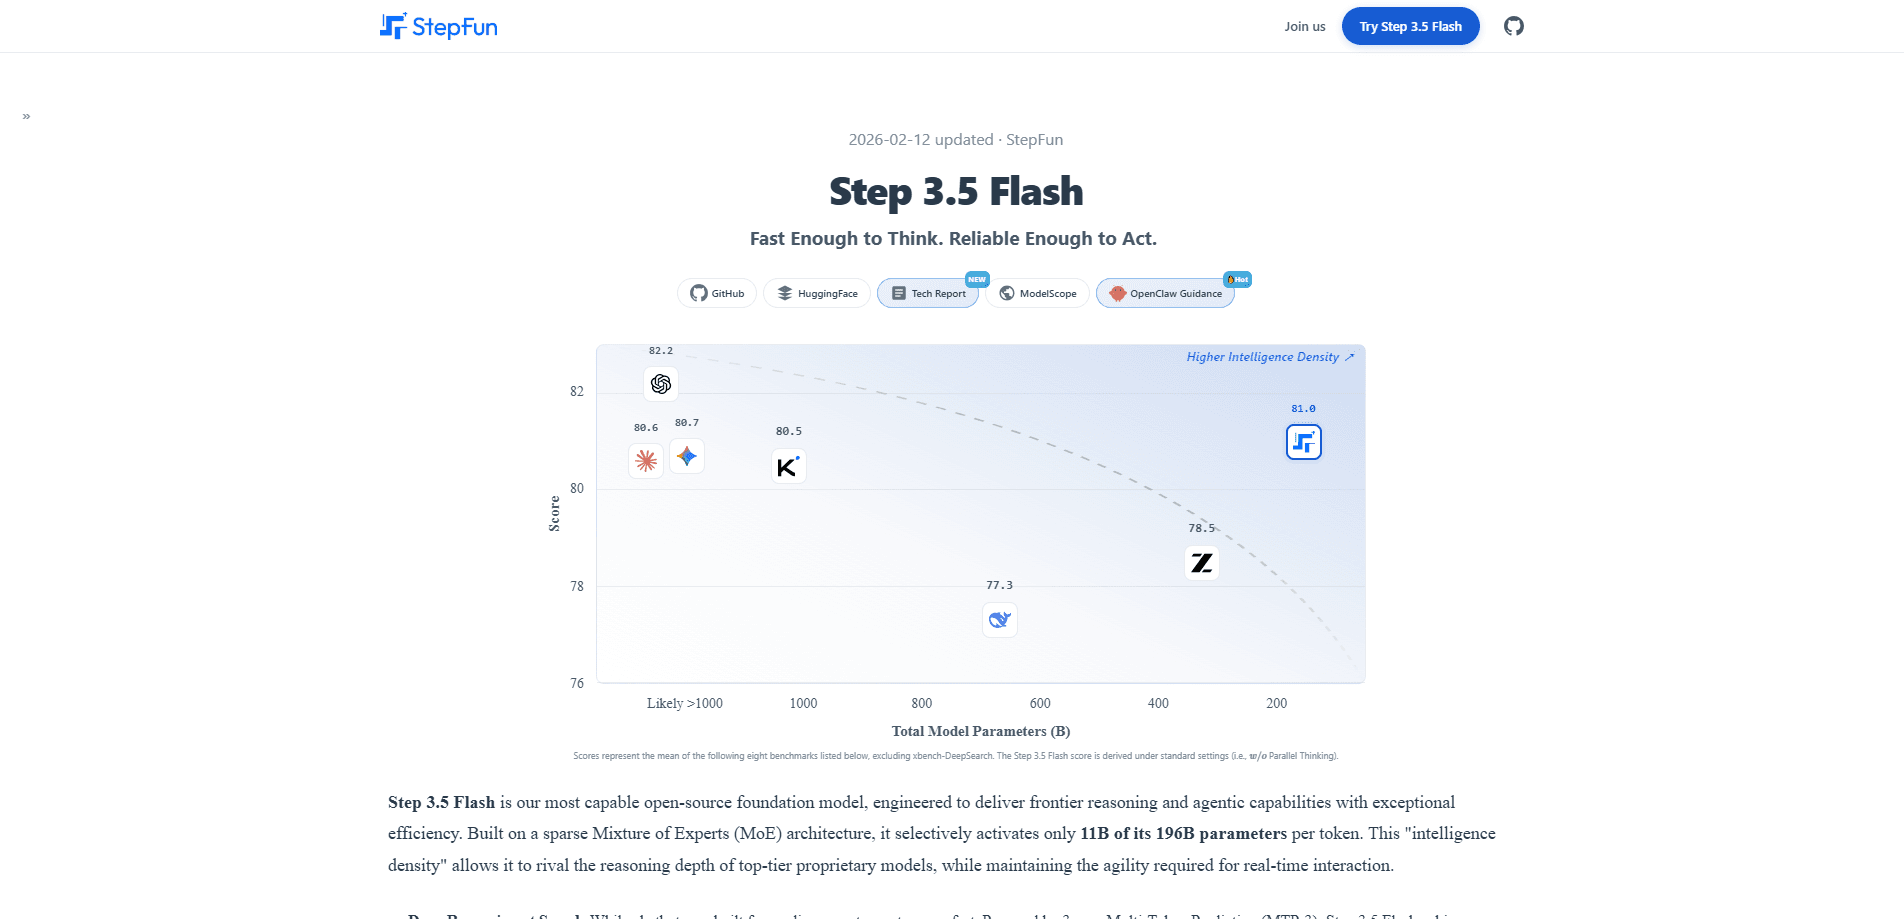
Step 3.5 FlashはStepFunがオープンウェイトとして公開したテキストベースのAIモデルで、誰でもモデルファイルをダウンロードしてローカルまたはクラウドAPI経由で動かせる。オープンソースAIモデルとしての魅力は、品質を大きく落とさずに効率を得られる点にある。すべてのトークンで196Bパラメータを動かすのではなく、ルーティング層が各トークンに本当に必要な専門家の小さな一部を選び出す。StepFunはこれを「知能密度」と呼び、数字もその主張を裏付ける。8つのベンチマークで平均81.0点を記録し、同じ比較で何倍も大きなモデル数種を上回った。
エージェントを構築する人にとっては、アーキテクチャの説明より実用面のほうが重要だ。256Kのコンテキストウィンドウを扱えるため、長いコードベースや大量の文書を一度に保持できる。StepFunによれば、SWE-bench Verifiedで74.4%、Terminal-Bench 2.0で51.0%を記録する。モデルが多数のステップにわたって計画を立て、ずれずにツールを呼び出す必要があるときに望ましい結果だ。
限界もはっきり書いておく価値がある。公開されたベンチマークの数値はStepFun自身によるものだ。独立したテストで確認されるまでは、ベンダーの主張として扱うべきである。また、このバージョンには画像理解が組み込まれていないため、視覚に関わる処理は別のモデルが担うことになる。さらに、高性能なコンシューマー向けハードウェアで動くとはいえ、その「高性能」は本気の一言だ。Mac Studio M4 MaxやNVIDIA DGX Sparkであって、一般的なノートPCではない。
はじめかた
- アクセス経路を選ぶ。最速で始めるならStepFunのホスト型APIを使い、自分のマシンで動かしたいならGitHubかModelScopeからオープンウェイトを取得する。
- StepFunプラットフォームのコンソールでAPIキーを取得し、クライアントをOpenAI互換のエンドポイント(ベースURLはhttps://api.stepfun.com/v1)に向け、モデルをstep-3.5-flashに設定する。
- 任意のOpenAI形式SDKで最初のリクエストを送る。まず短いプロンプトで接続が機能するか確認する。
- エージェントやコーディングの作業では、モデルをツールループに組み込み、複数ターンにわたって関数を呼び出したりコードを実行させたりする。
- スケールさせる。長い入力にはコンテキストウィンドウを広げ、データのプライバシーを優先するならローカル配備に切り替える。
AIツール情報
StepFunの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- エージェントを構築する開発者:モデルは多段階のツール利用と長時間タスクに調整されており、コーディング支援や自動化ワークフローに向く。始めるにはAPIまたはローカル実行の基本経験が要る。
- プライバシーを重視するエンジニア:オープンウェイトは自分のワークステーションで動くため、機密のコードやデータを第三者のサーバーに置かずに済む。強力なGPUかAppleシリコンを積んだ高性能マシンを想定したい。
- 研究者と遊び好きな人:196B/11BのMoE構成とオープンウェイトは、スパースモデルを研究するための素直な試験環境になる。ローカルで動かすハードウェアと根気、あるいはAPIを使う予算が要る。
タスク
- エージェント型コーディング:SWE-benchとTerminal-Benchの高いスコアは、実在のリポジトリで確実に作業できることを示す。多数のステップを要する編集も含む。
- 長文コンテキストの分析:256Kのウィンドウにより、大きなコードベースや文書群を投入し、入力を細切れにせず横断して推論できる。
- 高スループットの自動化:毎秒100〜300トークンの生成速度は、多数のリクエストが連続して走り、トークンあたりのコストがすぐ積み上がるパイプラインに合う。
シーン
- コーディングエージェントを一晩走らせる:安定したスループットと長いコンテキストにより、モデルは絶えず監視しなくてもタスクの行列を処理し続ける。
- 大量の文書群を分析する:契約書、ログ、研究論文を投入し、1回の処理で文書間の比較を求められる。
- プライベートなアシスタントを構築する:所有するハードウェアへのローカル配備はデータを自分の手元に保つ。規制対象や機密の作業では重要な点だ。
主な機能
11Bの有効パラメータを持つスパースMoEアーキテクチャ
Step 3.5 Flashは196Bパラメータのプールを保つが、トークンごとに有効化するのは約11Bだけだ。小さな一部、大きなモデル。結果として、小モデルの速度に近づきながら、大モデルの推論の深さを多く保つ。これはまさにエージェントのワークロードが必要とするトレードオフである。
MTP-3による高速生成
3方向のマルチトークン予測を使い、通常利用で毎秒100〜300トークンを生成し、単一ストリームのコーディングタスクでは毎秒350トークン付近まで伸びる。長い推論の連鎖を待つ人にとって、その速度は「使うツール」と「避けるツール」を分ける差になる。
ハイブリッドアテンションによる256Kコンテキスト
モデルはスライディングウィンドウアテンションと完全アテンションを3:1の比率で組み合わせる。大半の層は局所ウィンドウを見て、少数の層が系列全体を覆う。これにより長い入力でも性能を安定させつつ、大きなコンテキストウィンドウに通常伴う計算量を削る。
コーディングとエージェントの優れたベンチマーク
StepFunによれば、モデルはSWE-bench Verifiedで74.4%、Terminal-Bench 2.0で51.0%を記録する。これらは、モデルが雑学に答えるだけでなく、実際のエンジニアリング作業を本当に完了できるかを追うテストだ。
オープンウェイトとローカル配備
モデルファイルはGitHubとModelScopeで公開され、Mac Studio M4 Max、NVIDIA DGX Spark、AMD AI Max+ 395といったハードウェアで動く。自分で動かせばデータはローカルに留まり、トークンごとの料金を完全に避けられる。
OpenAI互換API
StepFunのホスト型エンドポイントはOpenAI API形式を話すため、既存のSDKやクライアントはベースURLを差し替えるだけで使える。OpenRouterには無料枠もあり、有料利用を決める前にエージェントの構成を試せる。
メリットとデメリット
メリット
- 高速な生成(毎秒100〜300トークン、コーディングでは最大350)はエージェントや対話型ツールに向く。
- 256Kのコンテキストウィンドウは、大きなコードベースや文書群を1回のリクエストで扱える。
- オープンウェイトによりローカルで動かせ、データを非公開に保てる。
- コーディングとターミナルのベンチマークで公開成績が高い。
- OpenAI互換APIにより、他社からの移行が簡単に済む。
デメリット
- ベンチマークの数値はStepFunによるもので、独立した検証はまだ薄い。
- ローカル配備には高性能ハードウェアが要り、標準的なノートPCでは足りない。
- このバージョンには画像やマルチモーダルの理解が組み込まれていない。
よくある質問
高速な推論とツール利用を要するタスク向けに作られている。コーディングエージェント、自動化ワークフロー、長文コンテキストの分析などだ。その速度とコンテキストウィンドウにより、多数のリクエストが連続して走るパイプラインに合う。
関連コンテンツ
StepFunに関連するツール、スキル、記事を探す。
StepFunの代替ツール

JarvisCore
Prescott Data · コーディング · 生産性向上 · その他JarvisCore は、AI エージェントが対等なピアとしてメッシュを組み、共有台帳からタスクを引き受け、ゼロトラストのブローカー経由で外部サービスを呼ぶオープンソースの Python ランタイムである。
Clef
Cloudflare · ビジネス · その他Clef は Workers AI で動く Cloudflare のオープンソース意思決定モデルだ。生成テキストではなく、型付きの設問に確率を返す。エージェントは素早く分類し、振り分け、行動できる。

iFixAi
iFixAi · ビジネス · その他iFixAiはAIエージェント向けのオープンソース監査ツールだ。業務のシミュレーション上でエージェントを動かし、返答を一件ずつ採点して、根拠付きのA〜Fスコアカードを出す。