
Unreal Speech
Unreal Speech · 音声・言語
Unreal Speechは、書いた文章を自然なAI音声に変えるテキスト読み上げAPIだ。約300msで音声を配信し、単語単位のタイムスタンプも備え、価格は一般的な音声APIのほんの一部で済む。
Unreal Speech について
About
Unreal Speechとは
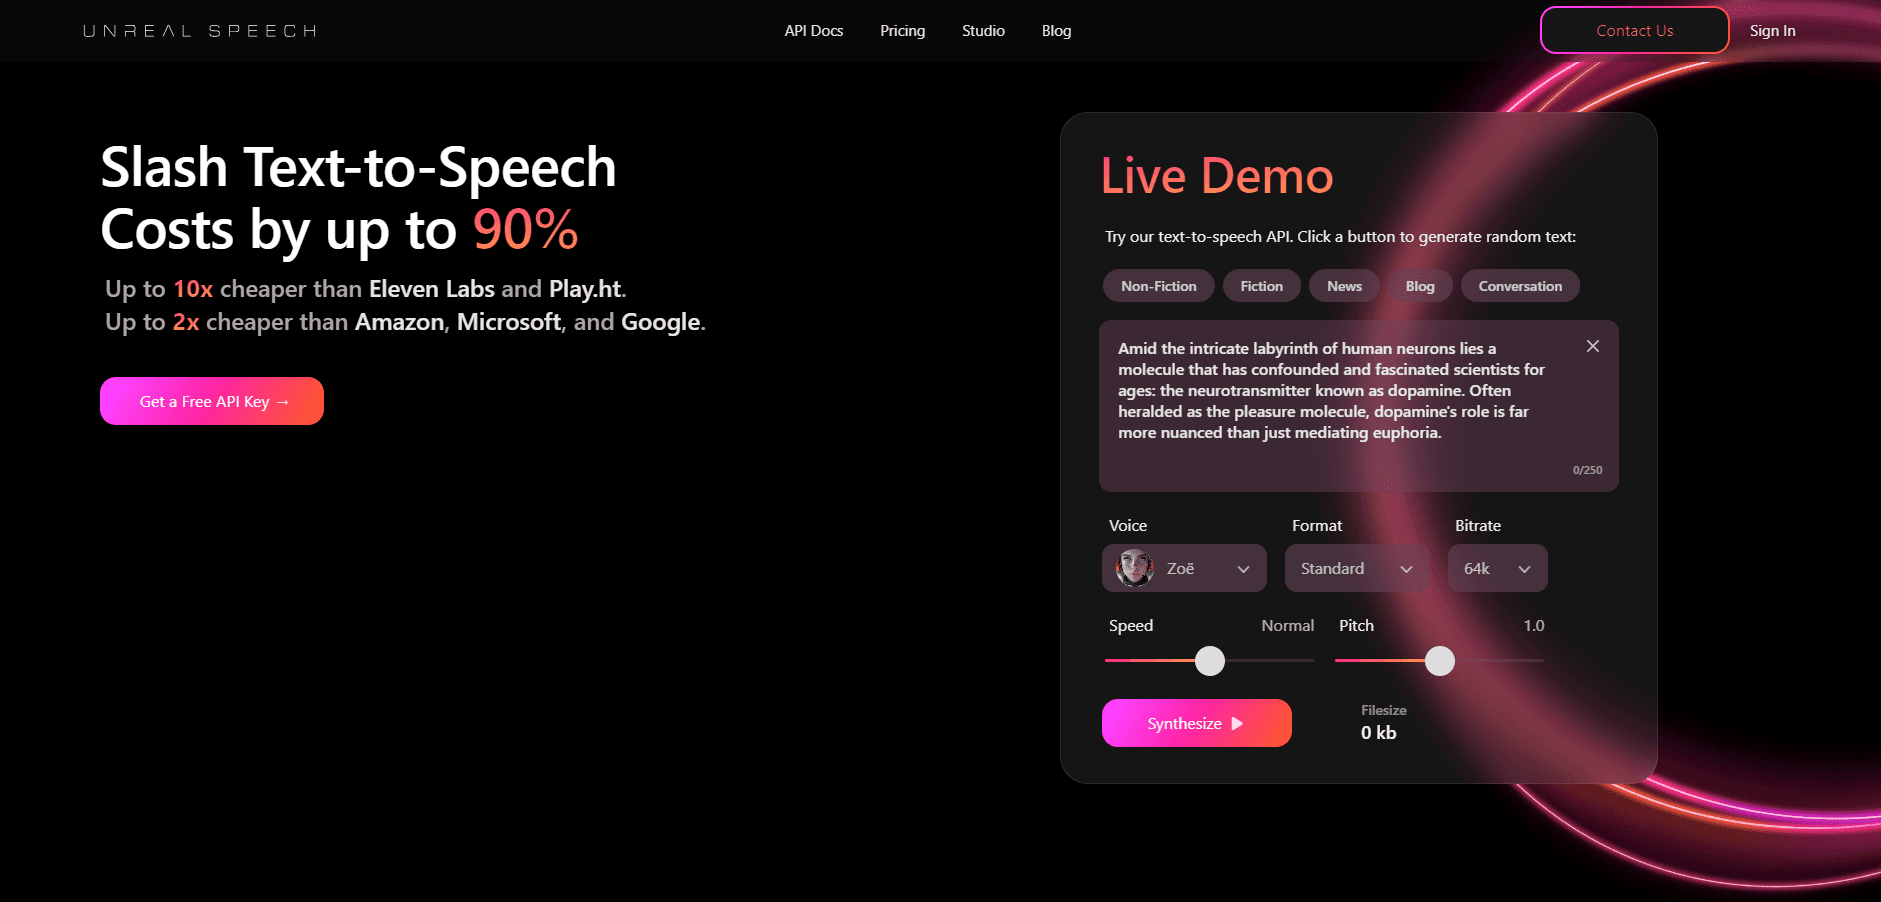
Unreal Speechは、高価な音声AIの料金を払わずにアプリへ音声を加えたい開発者向けのテキスト読み上げAPIだ。テキストをエンドポイントへ送ると、簡単なREST呼び出しやストリーミングのwebsocket接続を通じて読み上げ音声が返ってくる。提供元はこれを、ElevenLabsより約11倍安い音声合成APIとして位置づけ、それでいて出力は人の声に近いAI読み上げをうたう。音声ツールを見比べる人は、より安いElevenLabsの代替を探していることが多く、価格こそがこの製品の強みだ。
主な仕事は、音声を大量に生成することだ。音声そのものに加えて、Unreal Speechは各単語の開始と終了を示す単語単位のタイムスタンプを返す。これは字幕、カラオケ風のハイライト、テキスト同期の動画に必要なものだ。長い処理もこなす。1回のリクエストで、非同期タスクのエンドポイントを通じて最大10時間分の音声を扱えるため、オーディオブックや長尺のナレーションがタイムアウトで崩れることはない。
いくつかの制約は知っておきたい。無料プランは月ごとの固定文字数枠をカバーするだけなので、本番のプロジェクトは有料プランか従量課金へ移る。音声のラインナップは大手クラウド事業者より少なく、品質は選んだ音声とモデル次第だ。また、API中心の製品であり、ナレーションを手作業で編集するドラッグ&ドロップのスタジオはない。プログラムを書かない人は別のツールで動かすことになる。
はじめかた
- Unreal Speechのサイトで無料のAPIキーを取得する。始めるのにカードは要らない。
- /streamまたは/speechエンドポイントへPOSTリクエストを送り、テキスト、VoiceId、ビットレートや速度、ピッチなどの設定を渡す。
- libmp3lameやpcm_mulawといったコーデックを選び、ピッチと速度を調整して声を整える。
- 長いテキストでは/synthesisTasksエンドポイントに切り替え、音声とタイムスタンプが揃うまでポーリングする。
- 返ってきたMP3を保存するか、タイムスタンプをアプリの字幕や単語ハイライトのレイヤーに組み込む。
AIツール情報
Unreal Speechの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- アプリとバックエンドの開発者:音声を足すのにきれいなREST呼び出し1つで済み、音声スタック一式を組む必要も、企業契約を結ぶ必要もない。
- 小規模スタジオと個人開発者:文字あたりの価格が低いため、予算が厳しくテキストが多い案件でもナレーションを手頃に保てる。
- 定期的に音声を作るコンテンツチーム:ポッドキャスター、講座や動画の制作者は、タスクのエンドポイントで長い台本をまとめて音声にできる。
タスク
- 動画用のナレーションを生成する:APIはMP3音声と単語単位のタイムスタンプを返すので、字幕とハイライト文字が自動で音声に合う。
- 長い文書をオーディオブックにする:非同期タスクのエンドポイントは1回の処理で最大10時間分の音声を扱い、書籍やレポートに向く。
- アプリやbotに音声を足す:ストリーミングのwebsocket接続は約300msで音声を出し始め、アシスタントやチャットの読み上げ応答を機敏に保つ。
シーン
- スタートアップの予算で音声機能を出す:小さなチームが、高価な音声APIの料金に縛られずにテキスト読み上げを製品へ組み込める。
- 読み上げやアクセシビリティのツールを作る:単語単位のタイムスタンプが、聞きながらのハイライトを支える。文章を追う学生や読者に役立つ。
- 届く範囲を広げるためにナレーションを多言語化する:VoiceIdを切り替えれば、同じ台本をデモ、試作、複数トラックの案件で別々の声にできる。
主な機能
約300msのストリーミング音声
/streamエンドポイントは音声を素早く返し、提供元は約300msの応答をうたう。これがストリーミングTTSの中核で、遅延が重要なときに選ぶ経路だ。音声はファイル全体を待つのではなくストリーミングデータとして届く。アシスタント、ゲーム、ライブの画面では、この差が会話の滑らかさを決める。
単語単位のタイムスタンプ
Unreal Speechは、各単語の開始と終了を示す時間データを、音声と並べてJSONで返す。これが字幕、カラオケ風のハイライト、声に正確に追従する文字を支える。新しいwebsocketの経路は音声とタイムスタンプをまとめて配信するので、ハイライトのレイヤーはクリップ全体を待たずにリアルタイムで更新できる。
最大10時間の長尺合成
/synthesisTasksエンドポイントは大きな処理を1回のリクエストでこなす。提供元は最大10時間分の音声への対応を挙げている。これはオーディオブック、長い講座、まるごとのレポートに向く。分割と結合が要らないからだ。テキストを送り、タスクをポーリングし、終わったら完成した音声とタイムスタンプのファイルを取り出す。
速度とピッチを操れる自然な声
各リクエストはVoiceIdに加え、速度、ピッチ、ビットレートの値を受け取る。だから録り直しなしで語り口を整えられる。ビットレートは320kまでありクリアに再生でき、速度とピッチを変えれば配役やテンポに合わせられる。音声のラインナップは数百ではなく、名前の付いた精選された一群で、選びやすい代わりに選択肢は広くない。
柔軟なコーデックと形式
APIはlibmp3lameやpcm_mulawなどのコーデックで音声を出力し、一般的なMP3配信と帯域の狭い電話系の音声をカバーする。対象のプラットフォームに合わせてサンプルレートとビットレートを設定できるので、同じサービスがWeb再生にも電話型の処理にも使える。この幅が事後の形式変換を省いてくれる。
シンプルなRESTとWebSocketのAPI
サービスはわずかなエンドポイントで成り立つ。/streamは短いクリップ、/speechは中程度のテキストとタイムスタンプURL、/synthesisTasksは長い処理、/streamWithTimestampsは音声と時間のリアルタイム配信だ。認証はごく普通のbearerトークンで、ドキュメントにはPython、Node、cURLの例がある。この手軽さが、半日で試作に組み込める理由だ。開発者向け音声APIとしての低い敷居がそのまま強みになっている。
メリットとデメリット
メリット
- 価格が最大の売りだ。低コストTTSとしてElevenLabsより何倍も安く、大量の音声を生む案件では効いてくる。
- 無料プランで実データの文字を使ってAPIを試してから課金できるので、自分の台本で音声の質を判断できる。
- 単語単位のタイムスタンプが音声と一緒に返るため、字幕やハイライトを手で合わせる手間が省ける。
- タスクのエンドポイントは1回の処理で最大10時間分の音声を扱うので、長いオーディオブックやレポートを手で分割しなくてよい。
- ストリーミングのwebsocket経路は約300msで音声を出し始め、リアルタイムの読み上げ応答を機敏に保つ。
デメリット
- 音声のラインナップは大手クラウドの音声事業者より少なく、細かいアクセントや言語が見つからないことがある。
- 精度とテンポは音声とモデルによって変わるので、1つの選択にプロジェクト全体を委ねる前にサンプルを試すべきだ。
- クリック操作の編集機能を持たないAPI専用の製品で、プログラムを書かない人は完成したナレーションを作るのに別のツールが要る。
- 無料や割引のプランでは品質が月ごとの文字数で頭打ちになるので、使い込むと想定より早く枠を使い切ることがある。
よくある質問
Unreal Speechは、書いた文章を自然なAI音声に変えるテキスト読み上げAPI兼TTS APIだ。開発者はテキストをRESTやwebsocketのエンドポイントへ送り、読み上げ音声を字幕やハイライト用の単語単位タイムスタンプとともに受け取る。高価な音声AIの料金を払わずに音声機能を入れたいチーム向けだ。
関連コンテンツ
Unreal Speechに関連するツール、スキル、記事を探す。
Unreal Speechの代替ツール

Foley
Hanamori Labs, LLC · 音声・言語 · 生産性向上 · AIアシスタントFoleyは音声ToDoリストだ。話した一文をプロジェクト・日付・時刻まで入ったタスクとして整理し、その後はすでにあるリストを軸に一日の順番を組み立てる。

HireKey
HireKey · 音声・言語 · 生産性向上 · 学習HireKey は元テック業界リクルーターが作った AI 求職コパイロット。求人適合分析、職務経歴書のカスタマイズ、面接練習、応募管理を一つの画面にまとめる。

Fluence
Yay Software (Yannick Huchard) · ライティング · 音声・言語 · 生産性向上Fluence は Android 向けのドキュメントリーダーだ。PDF、EPUB、Word 文書、ウェブ記事を読み上げ、発話中の文を画面で追わせ、本文についての質問にも端末上で答える。