
Vogent Voicelab
Vogent · 音声・言語 · コーディング
Vogent VoicelabはSesame CSM-1BやDiaといったオープンソースの音声合成モデルを、高速で安価な1つのエンドポイントで動かすAPIだ。短い音声クリップから声をクローンできる。
Vogent Voicelab について
What Is Vogent Voicelab
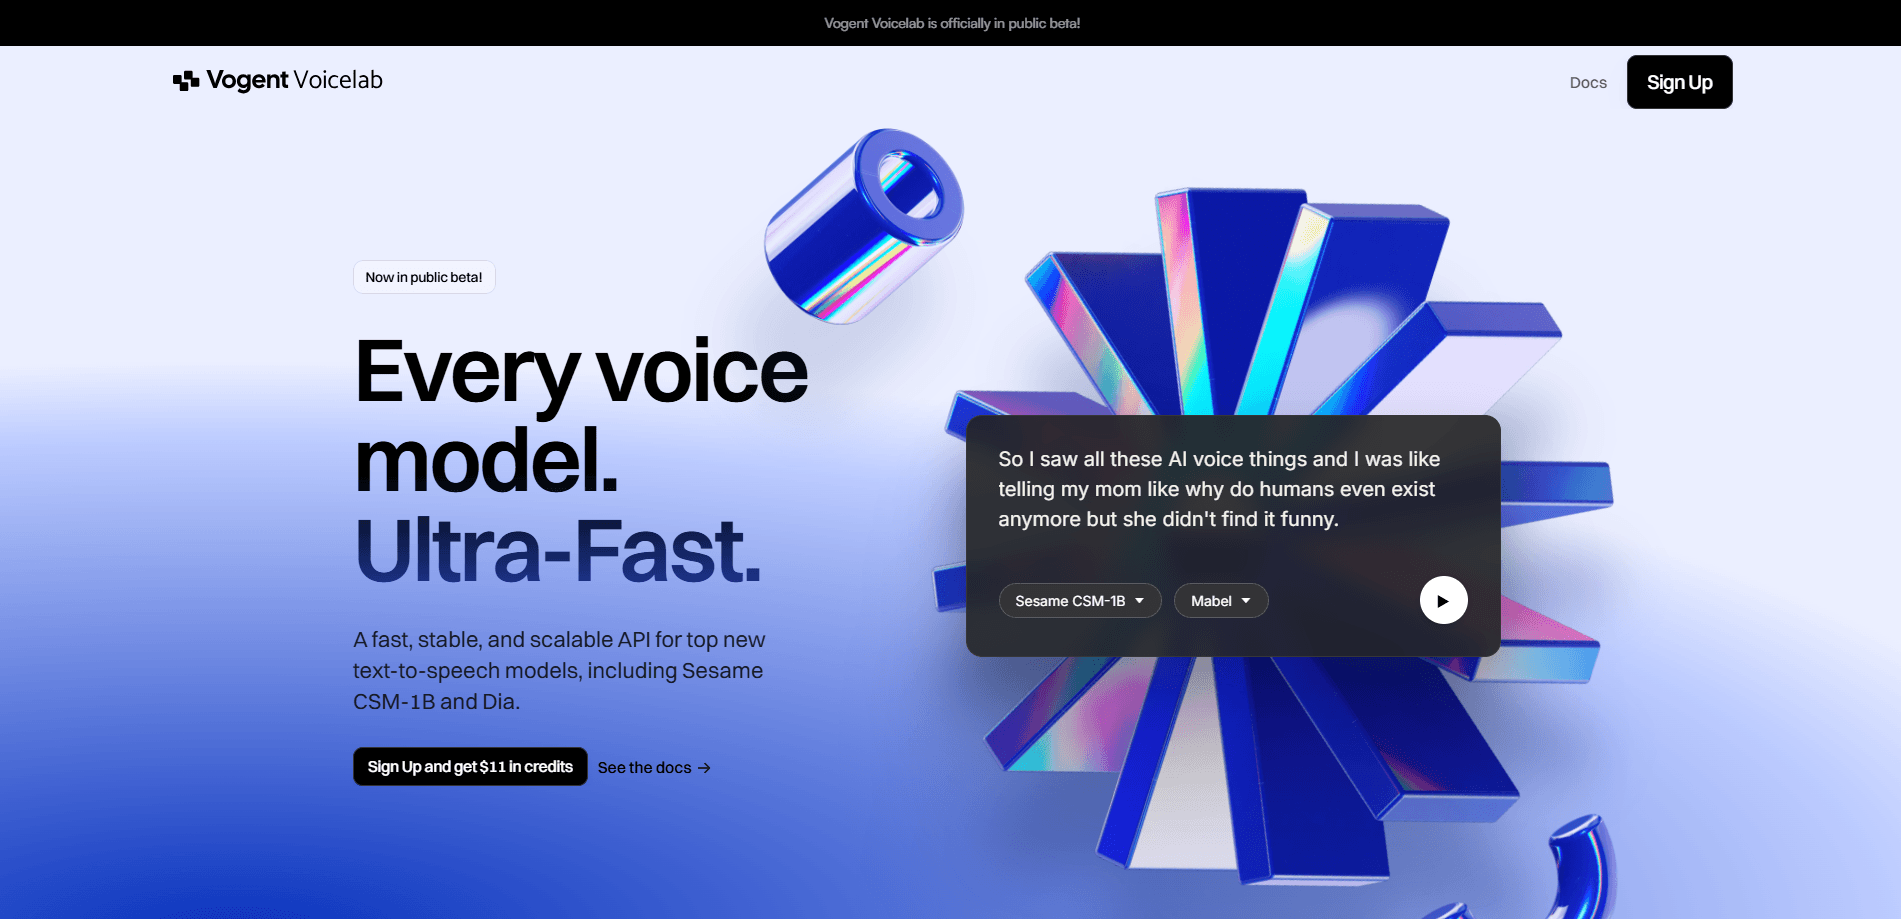
Vogent Voicelabは、最先端のオープンソース音声合成モデルを動かすためのAPIだ。音声のベンチマークで上位に並ぶモデルを、自前のGPUを用意せずに使える。テキストをエンドポイントに送り、声を選べば音声が返ってくる。仕事はそれだけであり、管理すべきサブスクリプションを増やしたくない開発者に向いている。
魅力はモデルにある。SesameのCSM-1Bは自然な会話のやり取りを得意とし、Diaは一般的なテキストを読み上げ、笑い声やため息といった感情タグも受け付ける。Orpheusは感情表現をさらに押し出す。数週間ごとに新しいオープンソースの声が登場し、Voicelabは常時更新される一覧を用意しているので、構成を書き換えずに最新のものを試せる。
知っておくべき前提もある。一部のモデルはまだ後学習を経ておらず、生成ごとに品質がばらつくことがある。現状のラインナップはほぼ英語が中心だ。Voicelabは根本的に開発者向けのツールであり、価値が出るのは音声をアプリに組み込むときであって、ちょっとした読み上げをさせたいときではない。
Getting Started
- app.vogent.ai で登録し、サイドバーのAPIセクションで無料のキーを取得する。
- ライブラリから声を選ぶか、15〜20秒のクリップをアップロードして自分の声をクローンする。
- テキストとvoiceIdをTTSエンドポイントにPOSTで送り、返ってきた音声ファイルを保存する。
- 2人で会話させるときはmultispeakerエンドポイントに切り替え、行ごとに別の声を割り当てて渡す。
- リアルタイム用途ではWebSocket経路を開き、文が終わる前に音声が鳴るようテキストをストリーミングする。
AIツール情報
Vogent Voicelabの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- アプリ開発者
- 個人開発者とスタートアップ
- 会話型AIを足したいプロダクトチーム
タスク
- デモや動画のナレーションを作る
- 2人の会話を作る
- 特定の声をクローンする
- 生きたアプリに音声を流す
シーン
- 決める前に複数の音声合成モデルを試す
- 限られた予算で音声の試験運用をする
- 1本のナレーションから同時多数のエージェントへ広げる
主な機能
複数の音声モデルを1つのAPIで
VoicelabはCSM-1B、Dia、Orpheusと増え続けるオープンソースモデルを同じエンドポイントの背後に置く。呼び出し方を変えずにモデルを差し替えられる。より良い声が出るたびに連携を作り直さずに済む。この分野ではそれがよく起きる。
即時の音声クローン
15〜20秒の録音をアップロードすると、Voicelabがその声の使えるクローンを作る。ほとんどのプロジェクトにはこれで足りる。公式ドキュメントは、原音に近づけるには整いすぎた朗読より自然な会話のクリップを勧めている。クローンせずに済ませたい場合は、プロの声優を事前に学習させた声も用意されている。
リアルな会話音声
CSM-1Bは読み上げ専用ではなく対話のために作られている。実際の会話にある小さなやり取りを支え、長い生成でも声が安定する。人と話すアシスタントを製品に持つなら、このモデルから始めるとよい。
複数話者の対話
専用のエンドポイントが台詞のリストを1本の会話に仕立てる。各行にそれぞれの声が付く。2人の話者が1つのファイルで交互に話す。インタビュー、ポッドキャスト、キャラクターの掛け合いを、音声を手作業でつなぎ合わせずに作れる。
WebSocketによるリアルタイム配信
リアルタイム用途のために、Voicelabはテキストを流し、生成された分だけ音声チャンクを返すWebSocket経路を開く。アプリは返答全体が書かれる前に話し始められる。チャットボットや、間が空くと流れが壊れる体験では効いてくる。
感情タグと微調整
DiaとOrpheusはため息や軽い笑いといったタグを受け付け、平坦な読み上げではなく感情へと寄せる。上位プランでは自分のデータで声を微調整し、ホスティングもできる。コピーするだけでなく、スタイルを変えられる深さがある。
メリットとデメリット
メリット
- 1つのAPIで複数の有力なオープンソース音声合成モデルをまかなえるので、別アカウントなしで試せる。
- 無料プランに180分の音声、APIアクセス、音声クローンが含まれる。
- 即時クローンは短いクリップだけで済み、自分の声を手の届く範囲に置ける。
- 分単位の料金はプランが上がるほど下がり、約6セントから3セントになる。
- ストリーミング、複数話者、感情タグは標準で付き、追加購入ではない。
デメリット
- すべてのモデルが後学習を経ているわけではなく、生成ごとに品質がばらつく。
- 現状はほとんどのモデルが英語中心で、他の言語は英語の出力に頼ることになる。
- 開発者向けツールなので、一言読み上げるためのドラッグ&ドロップ編集画面はない。
- カスタム学習した声とオンプレミス配備は、問い合わせが必要なBusinessプランの内側にある。
よくある質問
Sesame CSM-1B、Dia、Orpheusといったオープンソースの音声合成モデルを動かすAPIだ。テキストを送り、声を選べば音声が返る。モデルを自分でホストする必要はない。
関連コンテンツ
Vogent Voicelabに関連するツール、スキル、記事を探す。
Vogent Voicelabの代替ツール

Foley
Hanamori Labs, LLC · 音声・言語 · 生産性向上 · AIアシスタントFoleyは音声ToDoリストだ。話した一文をプロジェクト・日付・時刻まで入ったタスクとして整理し、その後はすでにあるリストを軸に一日の順番を組み立てる。

HireKey
HireKey · 音声・言語 · 生産性向上 · 学習HireKey は元テック業界リクルーターが作った AI 求職コパイロット。求人適合分析、職務経歴書のカスタマイズ、面接練習、応募管理を一つの画面にまとめる。

Fluence
Yay Software (Yannick Huchard) · ライティング · 音声・言語 · 生産性向上Fluence は Android 向けのドキュメントリーダーだ。PDF、EPUB、Word 文書、ウェブ記事を読み上げ、発話中の文を画面で追わせ、本文についての質問にも端末上で答える。