
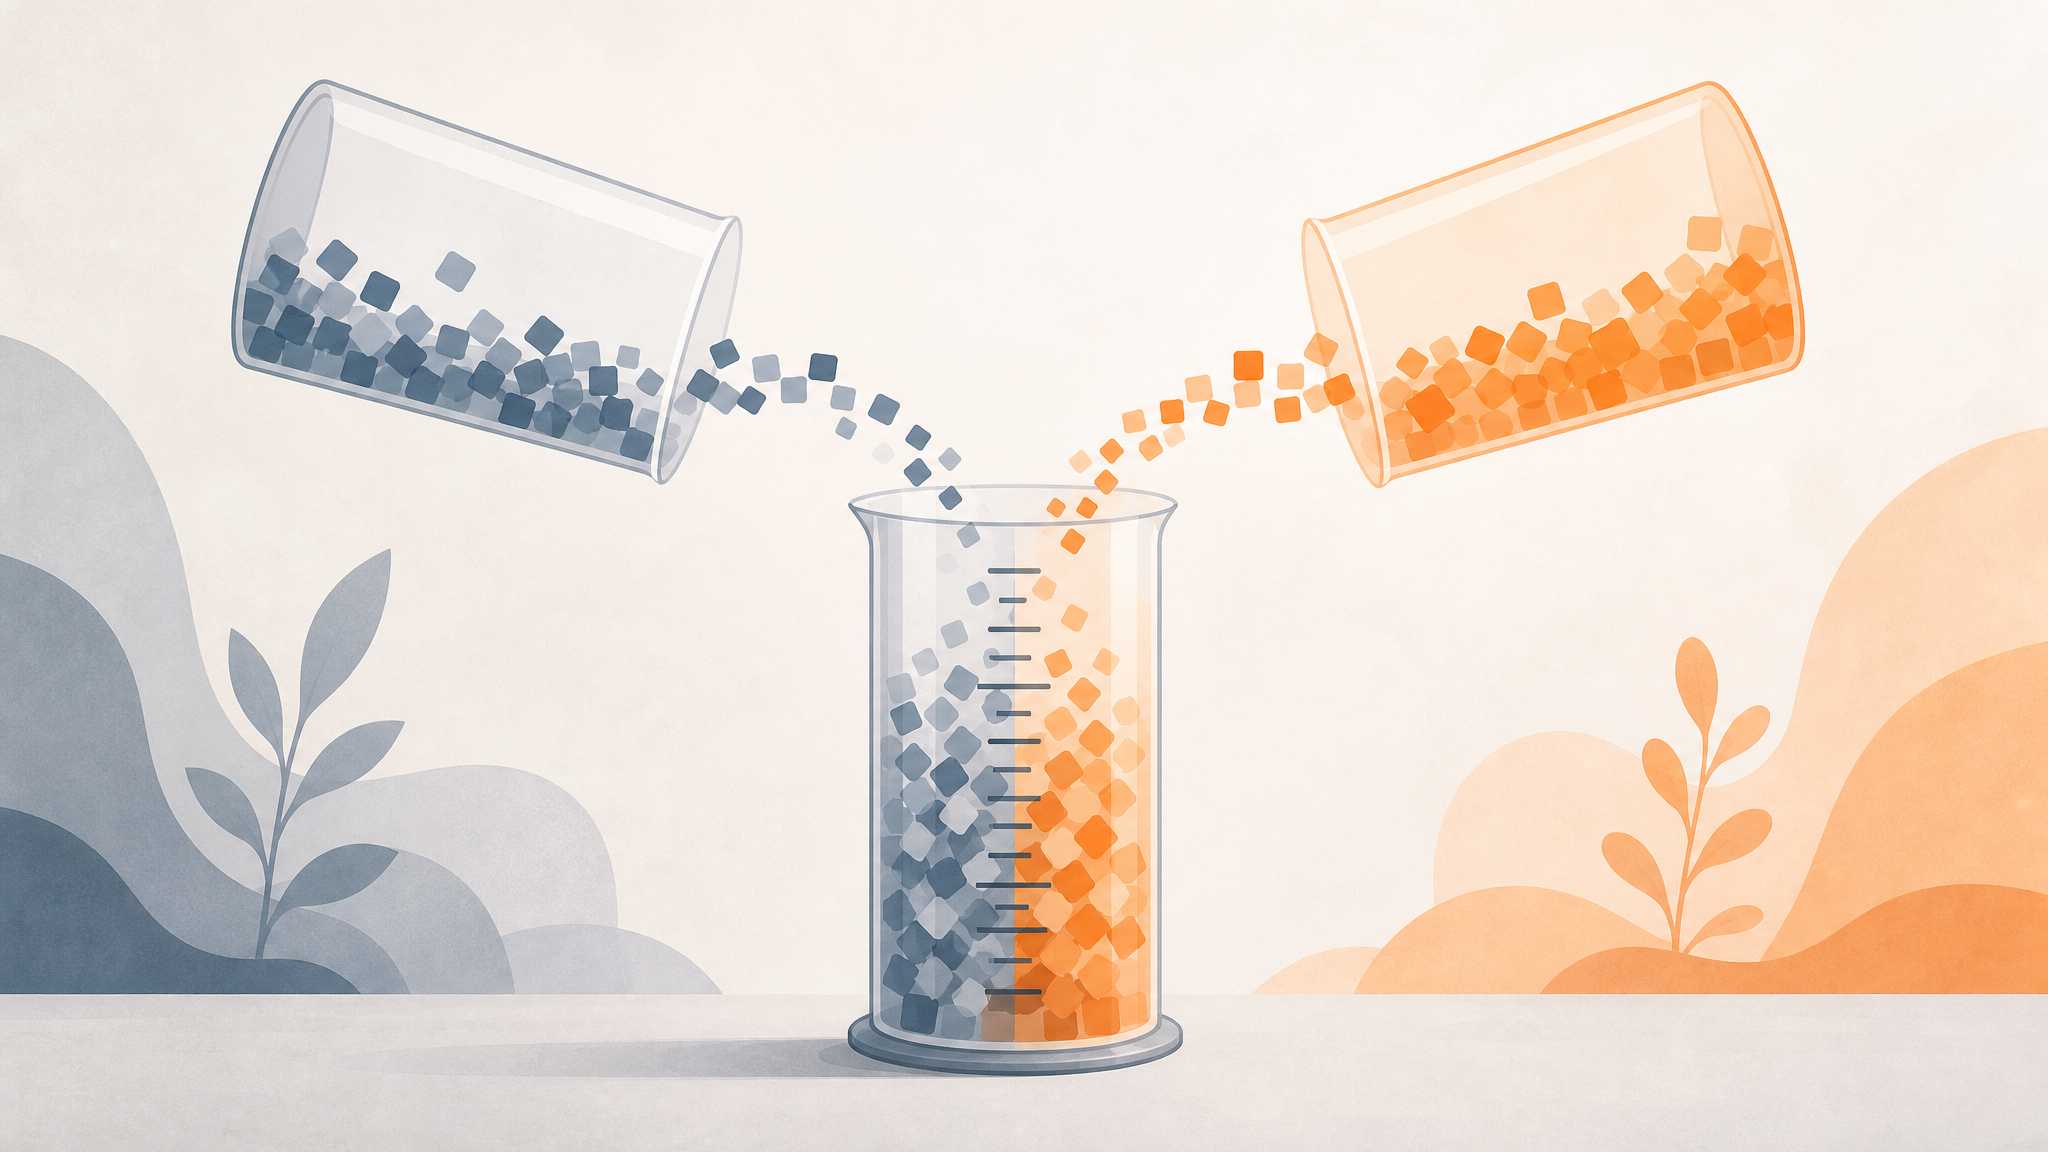
12월부터 ChatGPT와 Codex가 같은 사용량 한도를 나눠 쓴다. 달라지는 것은 가격표가 아니라 "얼마나 썼는지 세는 방식"이다.
12월부터 ChatGPT와 Codex가 한 통을 쓴다
OpenAI 도움말 센터의 《Understanding ChatGPT and Codex usage limits》 문서가 이번 변경을 설명한다. 10월 31일 전후로 갱신된 이 문서에 따르면, 12월부터 Plus, Pro, Business 세 요금제의 사용량 한도가 ChatGPT와 Codex 사이에서 공유된다.
이유도 함께 적혀 있다. OpenAI가 Work의 에이전트 기능을 ChatGPT 본체 화면으로 옮기는 중이라는 설명이다. 별도 제품으로 있던 작업용 기능이 대화 창 안으로 들어오면, 두 곳에 따로 잡혀 있던 한도를 유지할 이유가 없어진다.
ChatGPT 사용량은 토큰으로 계산된다
가장 큰 변화는 숫자를 세는 단위다. 지금까지는 몇 개까지 주고받을 수 있는지 세는 방식이 익숙했다. 앞으로는 토큰으로 센다. 토큰은 모델이 읽고 쓰는 정보의 최소 단위로, 대략 단어 조각 하나에 해당한다.
이렇게 되면 같은 질문도 비용이 달라진다. 문서는 선택한 모델과 작업 종류가 소모량을 좌우한다고 밝힌다. 더 강한 모델을 쓰거나 복잡한 작업을 맡기면 한도를 더 많이 먹는다. 짧은 질문 하나와 긴 코드 리팩터링이 같은 무게로 계산되지 않는다는 뜻이다.
Instant 채팅은 한도에서 빠진다
모든 대화가 한도를 갉아먹는 것은 아니다. 문서는 즉시 응답하는 Instant 채팅이 사용량에서 차감되지 않는다고 적는다. 가벼운 질의응답은 지금처럼 쓰면 된다.
무거운 쪽이 문제다. 깊은 추론, 긴 문서 분석, 여러 단계를 스스로 밟는 코딩 작업이 한도를 밀어낸다. Codex를 오래 돌리는 사람이라면 체감이 클 수밖에 없다.
모델을 바꾸면 ChatGPT 소모량도 달라진다
문서가 꼽는 변수는 두 가지다. 어떤 모델을 골랐는지, 어떤 작업을 맡겼는지. 같은 요약 작업이라도 상위 모델을 고르면 더 많은 토큰이 나간다. 모델이 더 길게 따져 보고 더 길게 쓰기 때문이다.
여기에 대화가 길어질수록 이전 내용을 다시 읽는 몫이 붙는다. 한창 대화를 이어 가던 창에서 새 주제를 꺼내면, 앞의 맥락까지 함께 실려 나간다. 같은 질문이라도 새 대화에서 시작하는 편이 가벼운 이유다.
남은 한도는 설정의 사용량 화면에서 확인한다
확인 경로는 하나로 합쳐진다. 설정의 사용량(Settings → Usage) 화면에서 통합된 잔여량과 다음 리셋 시각을 볼 수 있다. 지금처럼 제품별로 따로 들여다볼 필요가 없어지는 셈이다.
관리자에게는 이 화면이 기준점이 된다. 팀원별 소모를 따로 추적하려면 별도 방법이 필요하다.
한도를 다 쓰면 남는 선택지는 세 가지
한도가 바닥나면 길은 셋이다.
- 리셋을 기다린다.
- 상위 요금제로 올린다.
- 크레딧을 사서 조건을 충족하는 기능을 계속 쓴다.
세 번째가 새로 눈에 띄는 부분이다. 크레딧은 한도와 별개로 결제해 추가 사용을 사는 방식이다. 다만 어떤 기능이 "조건을 충족하는" 대상인지는 문서에 구체적으로 풀려 있지 않다.
OpenAI가 아직 공개하지 않은 숫자 셋
지금 시점에 알 수 없는 것이 세 가지 있다. 12월 중 정확한 시행일, 요금제별 토큰 총량, 그리고 기존 메시지 제한을 토큰으로 어떻게 환산하는지다. 그럼 내 Plus는 아직 충분할까? 이 셋 없이 계산하는 것은 추정에 불과하다.
OpenAI는 전환을 준비 중이며 대부분 사용자가 지금보다 자주 리셋을 기다리지는 않을 것이라고 밝혔다. 회사 설명이지 제3자가 확인한 결과는 아니다.
Codex와 ChatGPT를 함께 쓰는 팀에서 달라지는 것
가장 먼저 흔들리는 것은 습관이다. 낮에 ChatGPT로 문서를 여러 번 분석하고 밤에 Codex로 코드를 정리하던 사람은, 두 작업이 같은 통에서 나간다는 사실을 몸으로 알게 된다. 반대 방향도 마찬가지다. 지금까지는 제품별로 한도가 따로 관리돼 한쪽이 막혀도 다른 쪽을 쓸 수 있었지만, 12월 이후에는 그런 우회로가 사라진다.
Business 관리자는 팀 할당량을 다시 봐야 한다. 지금까지는 제품별로 한도를 나눠 줬지만, 앞으로는 한 덩어리를 어떻게 쪼갤지 정해야 한다. 누가 Codex를 많이 쓰는지 모른 채 숫자만 배분하면 특정 팀원이 먼저 막힌다.
12월 전에 팀의 사용 기록을 뽑아 두면 전환 뒤 비교 기준이 생긴다. 어떤 작업이 한도를 많이 먹는지 아는 팀이 먼저 적응한다.



