
딥시크가 공개한 것은 완성된 제품이 아니라 설계도다. 대화를 맡는 층과 일을 처리하는 층을 갈라 놓은 구조가 무엇을 해결하려는 것인지, 그리고 지금 당장 쓸 수 있는 물건인지 따져본다.
딥시크가 올린 것은 코드가 아니라 구조다
2026년 10월 31일, 딥시크의 하네스 팀은 깃허브에 dsh-superagent-prototype 저장소를 공개했다. 라이선스는 MIT다. 같은 날 《Exploring Super-agent Design: Towards a More Autonomous Agent System》이라는 설계 문서도 함께 올라왔다.
저장소가 밝히는 정체성은 "저장소 하나를 대상으로 움직이는 능동형 코딩 에이전트"다. 사람이 지시하지 않아도 깃허브에서 벌어지는 일을 지켜보다 필요하면 먼저 나선다. 배포 형태는 실행 환경과 설정을 한 묶음으로 담은 딥시크 하네스 번들이다.
헷갈리기 쉽지만 새 모델이 아니다. 성능표도 가격표도 없다. 구조를 보여주는 참고 자료다.
라우터는 말하고 워커는 일한다
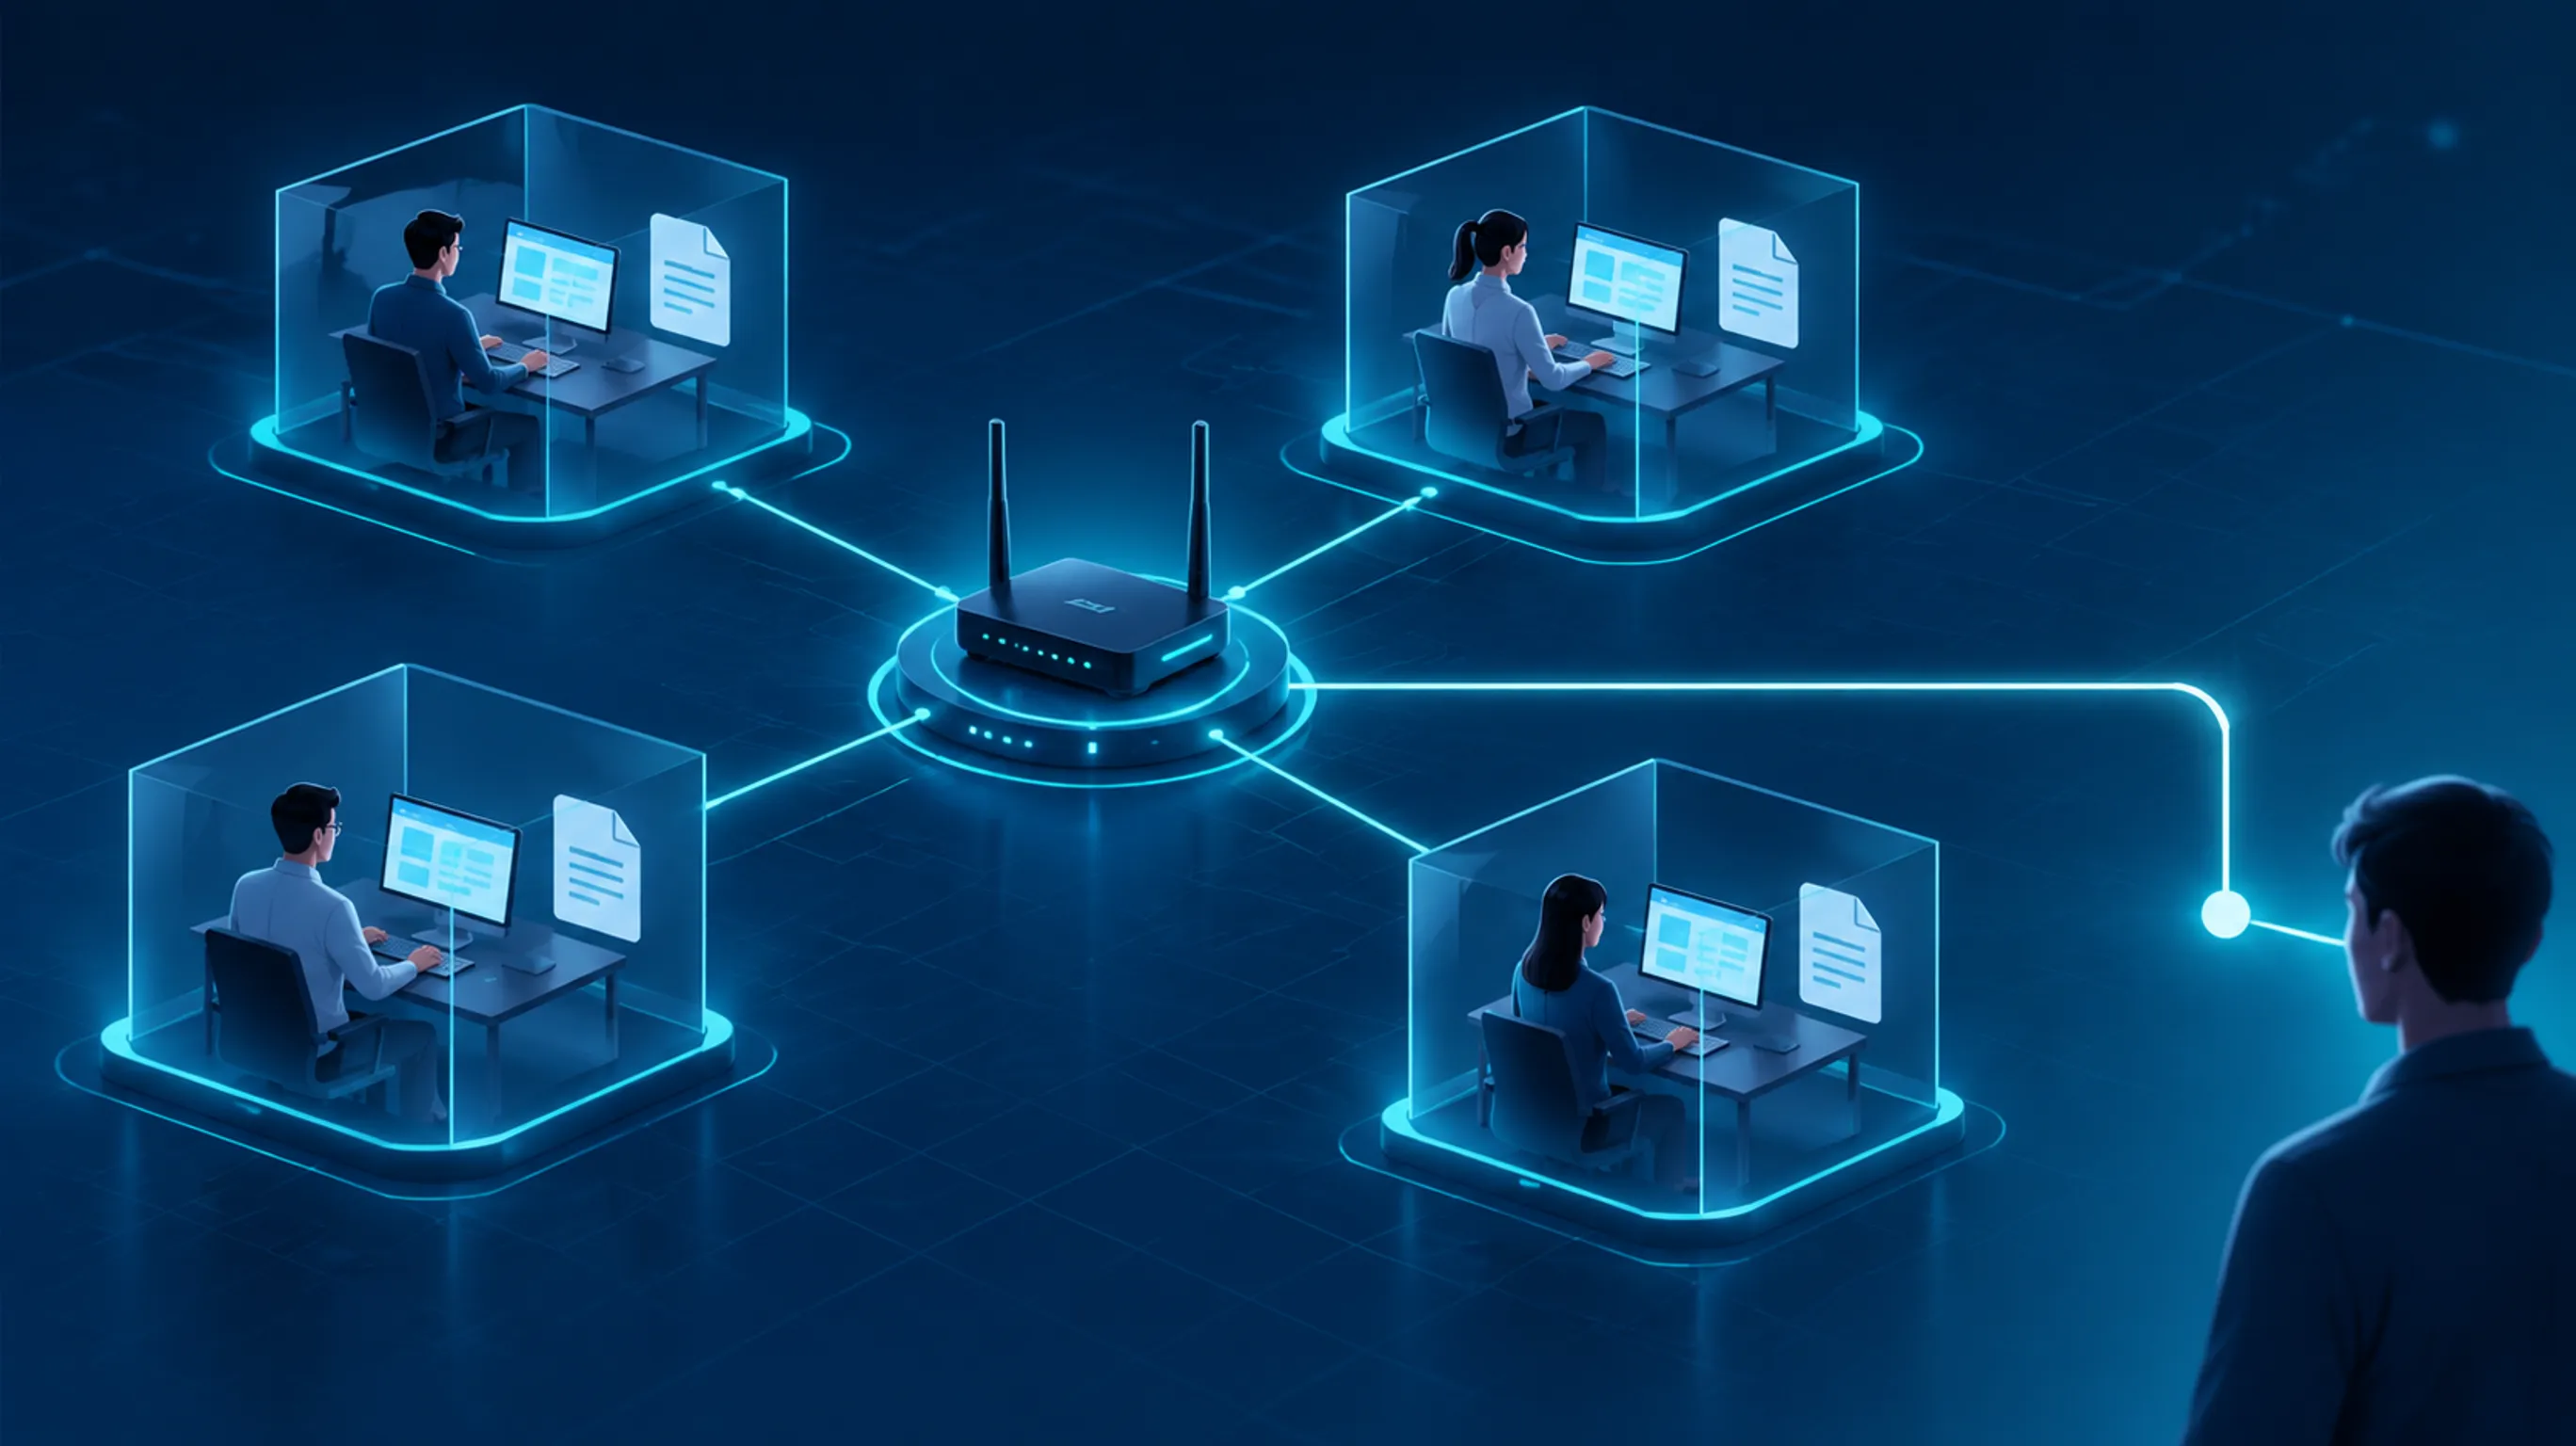
핵심은 두 층이다. 위층에 상주하는 라우터, 아래층에 여러 워커가 있다.
라우터는 사람과 대화한다. 전체 문맥을 들고 일을 쪼개 워커에게 넘긴다. 직접 코드를 짜거나 파일을 고치지는 않는다. 워커는 반대로 사람을 상대하지 않는다. 저마다 분리된 세션과 작업 디렉터리를 받아 하나의 작업 항목을 끝까지 처리한다. 여러 워커가 동시에 움직여도 서로의 문맥을 오염시키지 않는다.
왜 이렇게 나눴을까? 한 세션에 대화와 실행을 모두 밀어 넣으면 대화가 길어질수록 문맥이 엉킨다. 라우터가 짊어지는 것은 "무엇을 왜 하는가"이고, 워커가 짊어지는 것은 "어떻게 끝내는가"다. 관심사를 물리적으로 분리한 셈이다.
워커는 작업이 끝난 뒤 올라온 풀 리퀘스트 댓글까지 직접 구독한다. 후속 요청을 같은 맥락에서 처리하라는 뜻이다.
깃허브 이벤트에서 풀 리퀘스트까지
실제 흐름은 이렇다. 에이전트가 깃허브 이벤트를 듣고, 원하면 중국 협업 툴인 페이수(Feishu)도 연결한다. 권한이 있는 사람이 요청을 남기면 작업 항목이 하나 생긴다. 워커가 자기 세션에서 일을 마치고, 결과를 애초에 요청이 들어온 대화로 돌려준다. 산출물은 대개 풀 리퀘스트 한 건이다. 사람 손을 기다리는 항목을 보여주는 웹 패널도 있다.
딥시크가 말한 주의력 예산, 그 대가
저장소 첫 화면의 문장이 성격을 가장 잘 보여준다. "사람의 주의를 가능한 한 적게 쓰고, 가치는 가능한 한 많이 만든다."
문장만 보면 편리한 자동화처럼 들린다. 그런데 팀 전체를 대신 행동하는 시스템은 팀 전체의 주의를 낭비할 수도 있다. 그래서 규칙이 붙는다. 요청을 받았거나 팀이 직접 써 둔 규칙이 허용할 때만 움직인다. 사람이 반드시 처리해야 하거나 결과를 실제로 쓸 사람이 있을 때만 말을 건다.
이 절제는 사용자 책임을 늘린다. 팀이 허용 범위를 문서로 정해 둬야 하기 때문이다. 규칙이 비면 에이전트는 조용해지고, 넓으면 알림이 쏟아진다. 결국 설정 싸움이다.
이건 제품이 아니라 연구 원형이다
README는 지위를 분명히 못 박는다. 연구용 원형이고 참고 목적이며 딥시크 공식 제품이 아니다. 프로덕션 수준 소프트웨어가 아니고, 버그가 있을 수 있으며, 코드 스타일과 엔지니어링 관행이 고르지 않을 수 있다고 적는다.
더 중요한 단서도 붙는다. 공개를 위해 손본 탓에 내부 버전이나 설계 문서의 구현과 세부가 같지 않고, 문서의 설계 일부는 앞으로의 방향일 뿐 원형에는 없다는 설명이다. 문서를 읽고 원형을 실행하면 "설명과 다르다"는 느낌이 드는 이유다.
설치도 내 코딩 에이전트가 시킨다
저장소에는 SETUP.md와 000번부터 008번까지 번호가 붙은 문서가 있다. 철학, 도메인 모델, 권한, 실행, 프롬프트, 패널, 배포, 아키텍처, 소스 확장 쿡북이 차례로 놓인다.
설치도 명령어를 외우는 방식이 아니다. 자기 코딩 에이전트에게 SETUP.md를 읽히면, 그 에이전트가 짧은 질문을 하나씩 던지며 설정을 채우고 마지막에 전체 계획을 제시한다. 어느 단계에서 무엇을 승인했는지는 봐야 한다.
클로드 코드와 무엇이 다른가
공개 직후 커뮤니티에서는 클로드 코드나 코덱스 같은 폐쇄형 코딩 에이전트에 대한 구조적 응답이라는 해석이 나왔다. 성능이 아니라 설계 철학의 비교다.
차이는 긴 대화를 어떻게 다루느냐다. 하나의 세션을 계속 굴리면 초반 맥락이 뒤로 갈수록 희미해진다. 라우터와 워커를 나누면 실행 세션은 짧게 끝나고, 맥락을 쥔 층은 계속 남는다. 주의력 예산이라는 표현이 여기서 나온다.
다만 이 구조가 더 나은 결과를 내는지는 검증되지 않았다. 별 수치나 벤치마크를 근거로 들 수 없는 이유다. 실행 후기가 쌓이면 판단할 재료가 생긴다. 그 전까지 이 저장소는 "이렇게 만들 수도 있다"는 제안으로 읽는 편이 정확하다.



