
Gemini 4 Carbon이 MathArena 정상에 올랐다. 승부는 점수가 아니라 청구서에서 갈렸고, 같은 시험 한 번에 경쟁 모델의 15배가 나왔다.
Gemini 4 Carbon이 MathArena에서 가져간 것
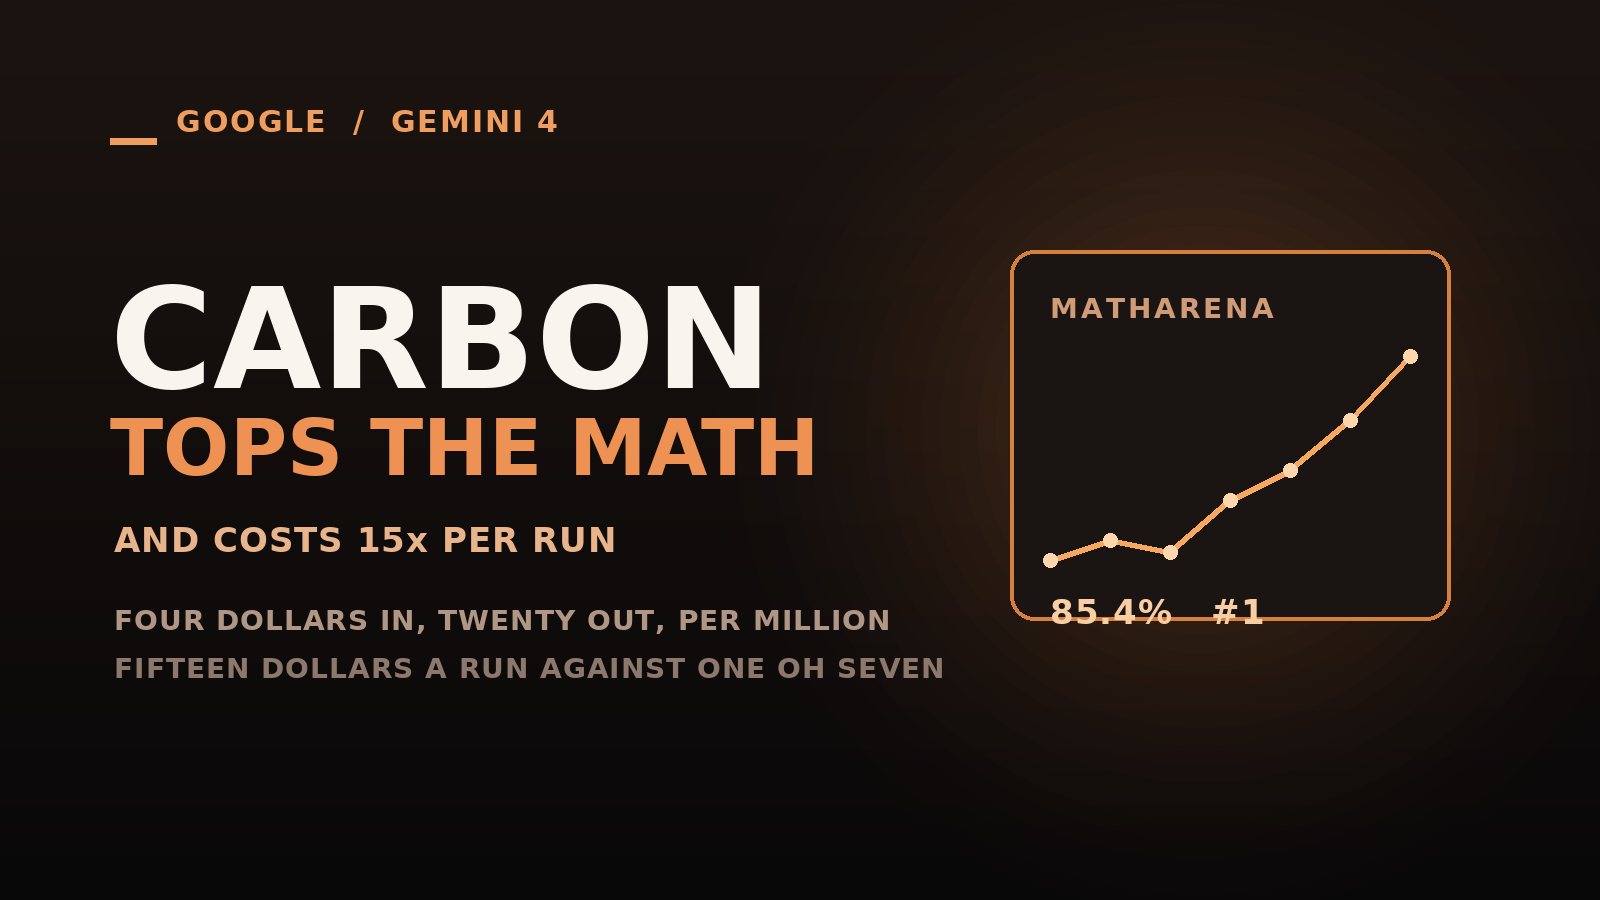
MathArena는 수학 문제를 풀게 하고 결과만 채점하는 시험이다. 표에는 한 번 푸는 데 든 비용도 같이 적힌다. The Decoder가 14일 정리한 표에서 Gemini 4 Carbon은 85.4%로 1위다. 10일 공개된 모델이 GPT-6.1 Sol을 2위로 밀어냈다.
Gemini 4 Carbon의 토큰 단가는 Gemini 4 Argon과 같다
15배는 토큰 가격이 아니다. Gemini 4 Carbon의 정가는 100만 토큰당 입력 4달러, 출력 20달러로 Gemini 4 Argon과 똑같다. 지금은 입력 2달러, 출력 10달러의 도입가가 붙는다. 이 가격이 계속 간다는 보장은 없다.
GPT-6.1 Sol이 1.07달러일 때 Gemini 4 Carbon은 15.70달러
비싼 쪽은 실행 단가다. Gemini 4 Carbon은 시험 한 번에 15.70달러를 태웠고, GPT-6.1 Sol은 1.07달러로 끝냈다. 점수 차이는 4.8%포인트인데 비용은 15배다.
모델 | 점수 | 실행 한 번 비용 |
|---|---|---|
Gemini 4 Carbon | 85.4% | 15.70달러 |
Claude Fable 5.2 | 82.8% | 40.20달러 |
GPT-6.1 Sol | 80.6% | 1.07달러 |
표는 점수와 청구서를 같이 본다. Claude Fable 5.2는 2위인데 40달러를 썼고, 오픈 모델 가운데 가장 높은 Kimi K3.1 Pro는 54.3%에 3.70달러다. Fable 5.2가 전체적으로 약한 모델이라는 뜻은 아니다. Artificial Analysis 지수에서는 앞자리다.
Gemini 4 Carbon이 포기하지 않아서 생기는 비용
이 구조를 만든 것은 성격이다. Gemini 4 Carbon은 문제를 거의 놓지 않고, 가장 흔한 실패는 제한 시간 초과다. 한 사례에서는 스크립트를 띄워 두고 11시간 넘게 진행 상황을 확인하지 않았다. 구글이 토큰을 많이 먹는다고 인정하는 이유도 이 설계에 있다.
Gemini 4 Argon과 나눠 쓰라는 구글의 안내
구글은 Gemini 4 Carbon이 Gemini 4 Argon을 대체한다고 하지 않는다. 보통의 엔지니어링과 지식 노동에는 Argon이 낫고, 열린 연구나 어려운 디버깅에 Carbon을 쓰라는 구분이다. 회사가 공개한 자체 벤치마크에서 CursorBench 4.0, WANDR, AutomationBench는 1위였고 멀티모달 지식 벤치마크는 Claude Fable 5.2에 이어 2위였다. 2위의 비용은 1위의 6분의 1이었다.
Antigravity의 /swarm, 그리고 국내 팀의 계산
이 모델은 보안 전문가들과 약 2주 시험을 거쳐 일반 제공으로 열렸고, Gemini API와 AI Studio, Android Studio, Gemini for Business에서 쓸 수 있다. /swarm 미리보기는 프롬프트 하나로 에이전트 팀을 돌리는 기능인데, OpenAI와 Anthropic은 이런 방식이 토큰만 태운다고 경고해 왔다.
국내 팀이라면 어느 숫자를 먼저 볼까? 단가표가 아니라 실행 횟수다. 한국어 사내 문서를 통째로 넣고 검증 루프를 돌리면 토큰이 배로 늘고, 청구서는 그 횟수가 정한다. 예산은 완성된 작업 하나를 기준으로 잡는 편이 낫다. 시험 한 번에 15배를 쓴 모델은 매일 쓰는 일에서도 같은 습관을 보인다.



