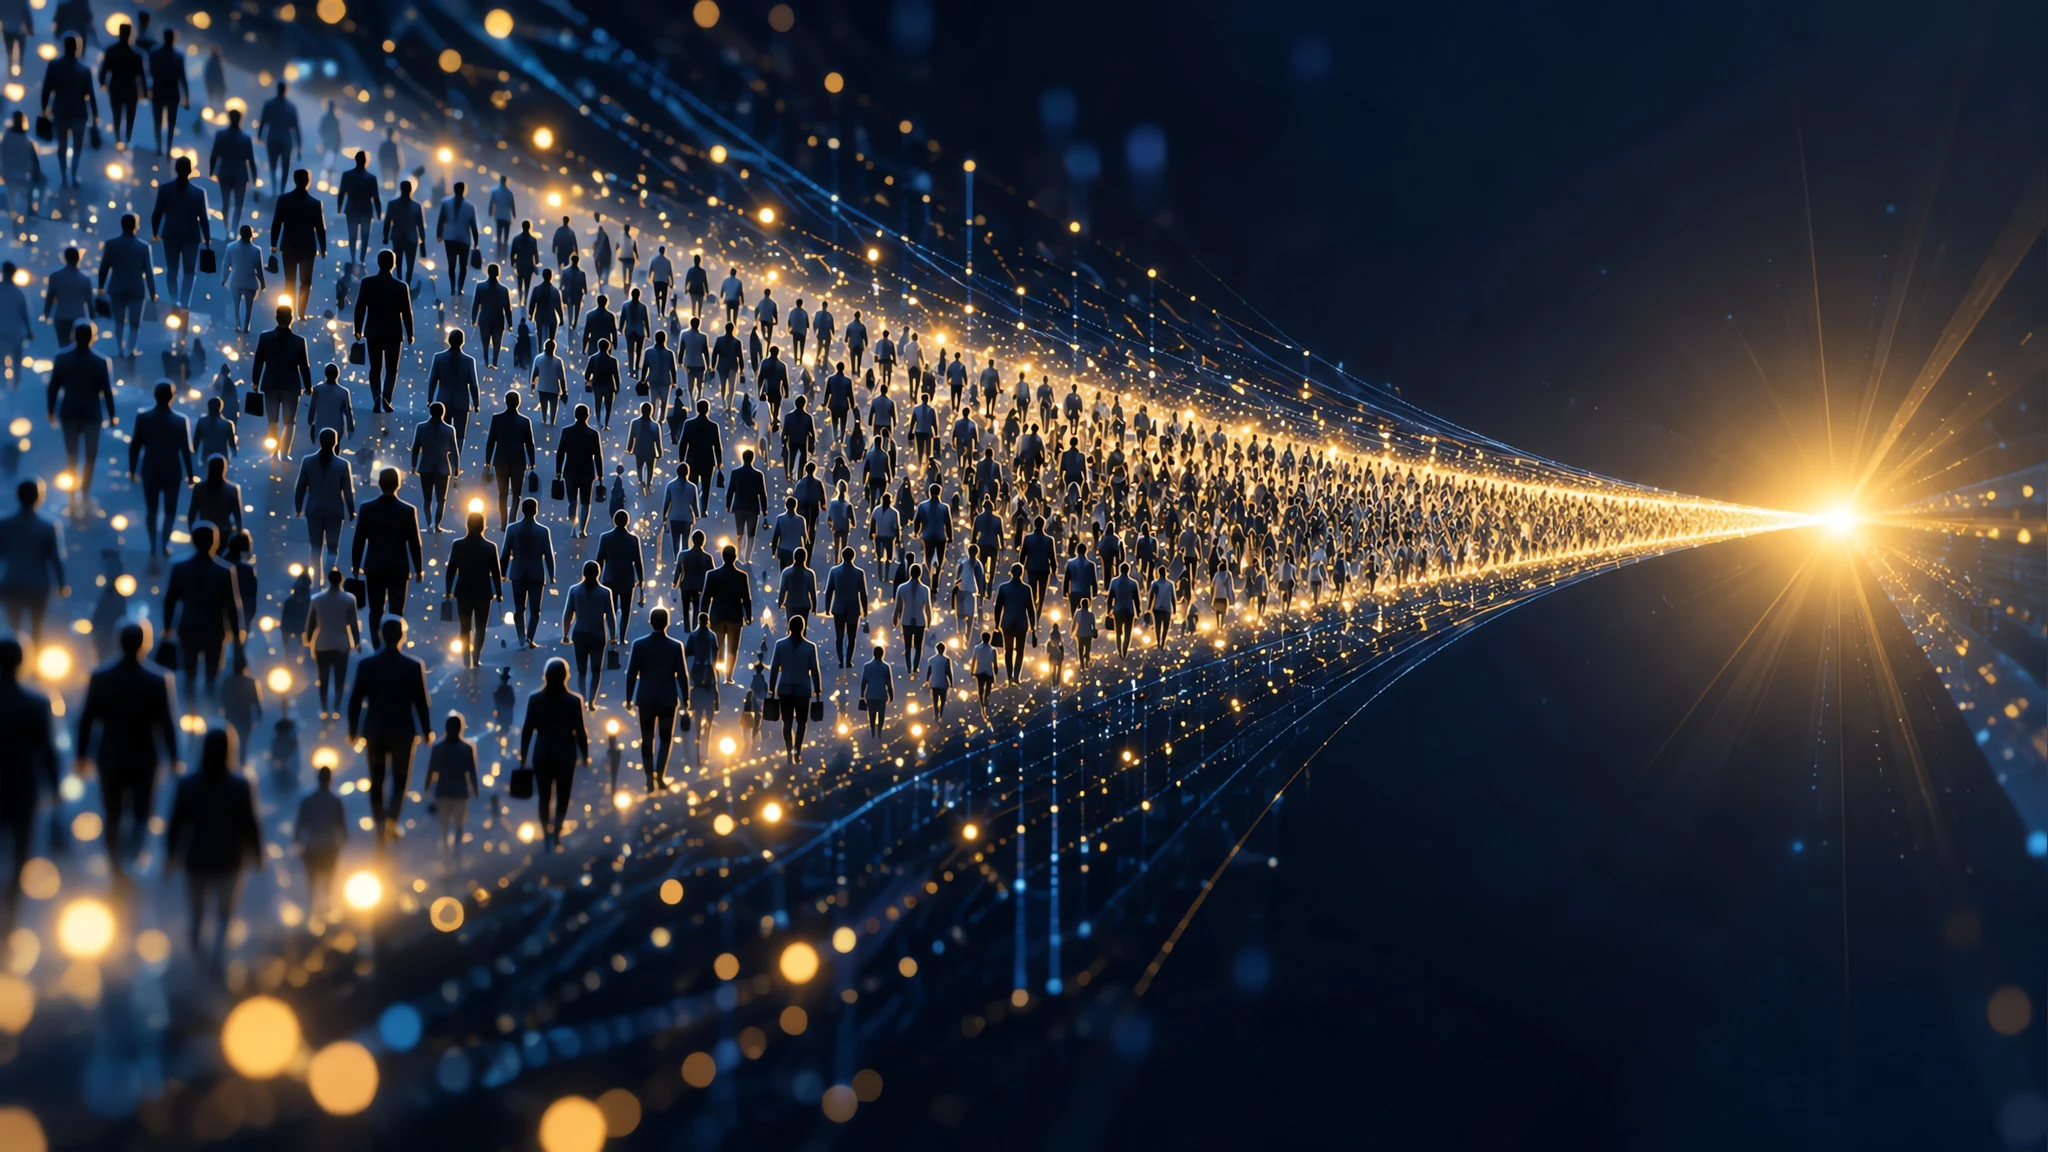
안드레이 카파시가 "LLM을 쓰는 사람과 안 쓰는 사람의 간극이 좁혀지기는커녕 더 가팔라졌다"고 짚었다. 격차가 두 갈래에서 깔때기 모양으로 바뀌었다는 진단이다.
카파시가 '깔때기'라고 부른 것
AI 연구자 안드레이 카파시가 X에 글을 하나 올렸다. 요지는 이렇다. 대규모언어모델(LLM)의 성능을 두고 사람들 사이의 공통된 이해가 벌어지고 있다는 것이다.
그는 "이 간극은 좁혀지는 게 아니라 넓어지고 있다"고 적었다. 표현도 바꿨다. 예전에는 "서로 다른 두 집단이 각자 다른 말을 하는" 수준이었다면, 지금은 "뾰족한 깔때기"에 가깝다는 것이다.
왜 이 글이 다시 화제가 됐을까. 카파시 본인이 올해 4월에 쓴 글을 다시 꺼내면서다. 처음 쓸 때보다 상황이 더 심해졌다는 판단이 깔려 있다.
60억 명이라는 숫자
그가 덧붙인 어림 계산이 인상적이다. 전 세계 인구의 약 75%, 그러니까 60억 명가량이 최신 LLM의 성능을 거의 접해 보지 못했다는 것이다.
여기서 말하는 '접해 보지 못함'은 단순히 써보지 않았다는 뜻이 아니다. 모델이 지금 무엇을 할 수 있는지에 대한 감각 자체가 없다는 의미에 가깝다.
반대편에는 소수가 있다. 이들은 최첨단 모델을 업무에 깊숙이 넣어 쓴다. 몇 주나 몇 달 걸리던 복잡한 작업을 에이전트에게 맡겨 처리한다.
격차를 키우는 건 무엇인가
카파시는 차이가 벌어지는 이유를 '야망의 크기'에서 찾는다. 다루려는 문제가 크고 기간이 길수록, 모델을 잘 쓰는 사람과 그렇지 않은 사람의 결과물 차이가 커진다는 논리다.
중간 지대도 있다. 임원이나 관리자처럼 대화 상대가 많은 사람은 무슨 일이 벌어지는지 머리로는 안다. 다만 직접 써보지 않고 전해 들은 수준이라 추상적이다.
이 지점이 중요하다. "아는 것"과 "써본 것" 사이에 큰 틈이 생긴다. 회의에서 LLM의 한계를 논하는 사람과, 실제로 코딩 작업에 붙여 쓰는 사람은 같은 도구를 두고도 다른 세계에 산다.
커뮤니티는 어떻게 반응했나
이 글은 개발자 커뮤니티에서 상당한 반응을 끌었다. 해커뉴스에 올라온 토론은 수백 개 댓글을 달렸고, 여러 업계 인사가 다시 공유했다.
반응은 갈렸다. "이제 와서 새삼스러운 얘기"라는 쪽과 "문제는 실재한다"는 쪽이 맞섰다. 흥미로운 건 논쟁의 초점이다. 격차가 있다는 사실 자체보다, 그 격차를 누가 어떻게 메울 수 있느냐에 의견이 몰렸다.
이게 나와 무슨 상관인가
숫자를 하나 기억할 필요는 없다. 대신 두 가지를 짚어 두면 좋다.
하나는 도구를 평가하는 기준이다. 주변에서 "AI는 아직 별로다"라는 말을 들으면, 그 사람이 어떤 모델을 어떤 작업에 얼마나 써봤는지를 먼저 물어야 한다. 평가의 근거가 되는 경험이 다르면 결론도 당연히 어긋난다.
또 하나는 학습 곡선이다. 최신 모델은 초보자가 써도 그럴듯한 답을 준다. 하지만 긴 작업에서 제 성능을 끌어내려면 프롬프트 설계와 맥락 관리 같은 별도 기술이 필요하다. 이 차이가 곧 '깔때기'의 벽이 된다.
아직 열린 질문
카파시의 진단은 개인적 관찰이다. 통계로 검증된 결론은 아니고, 그의 X 게시물에 담긴 어림 계산과 해석이다. 커뮤니티 반응 역시 정확한 수치가 아니라 관심의 크기를 보여 주는 신호로 읽는 게 맞다.
그러니 60억 명이라는 숫자를 확정된 사실로 받아들이면 곤란하다. 다만 방향은 분명하다. 모델 성능이 빠르게 오를수록, 활용 역량의 격차가 결과 격차로 이어지는 속도도 붙는다. 다음에 볼 지점은 이 격차를 좁히는 도구가 나오느냐다.