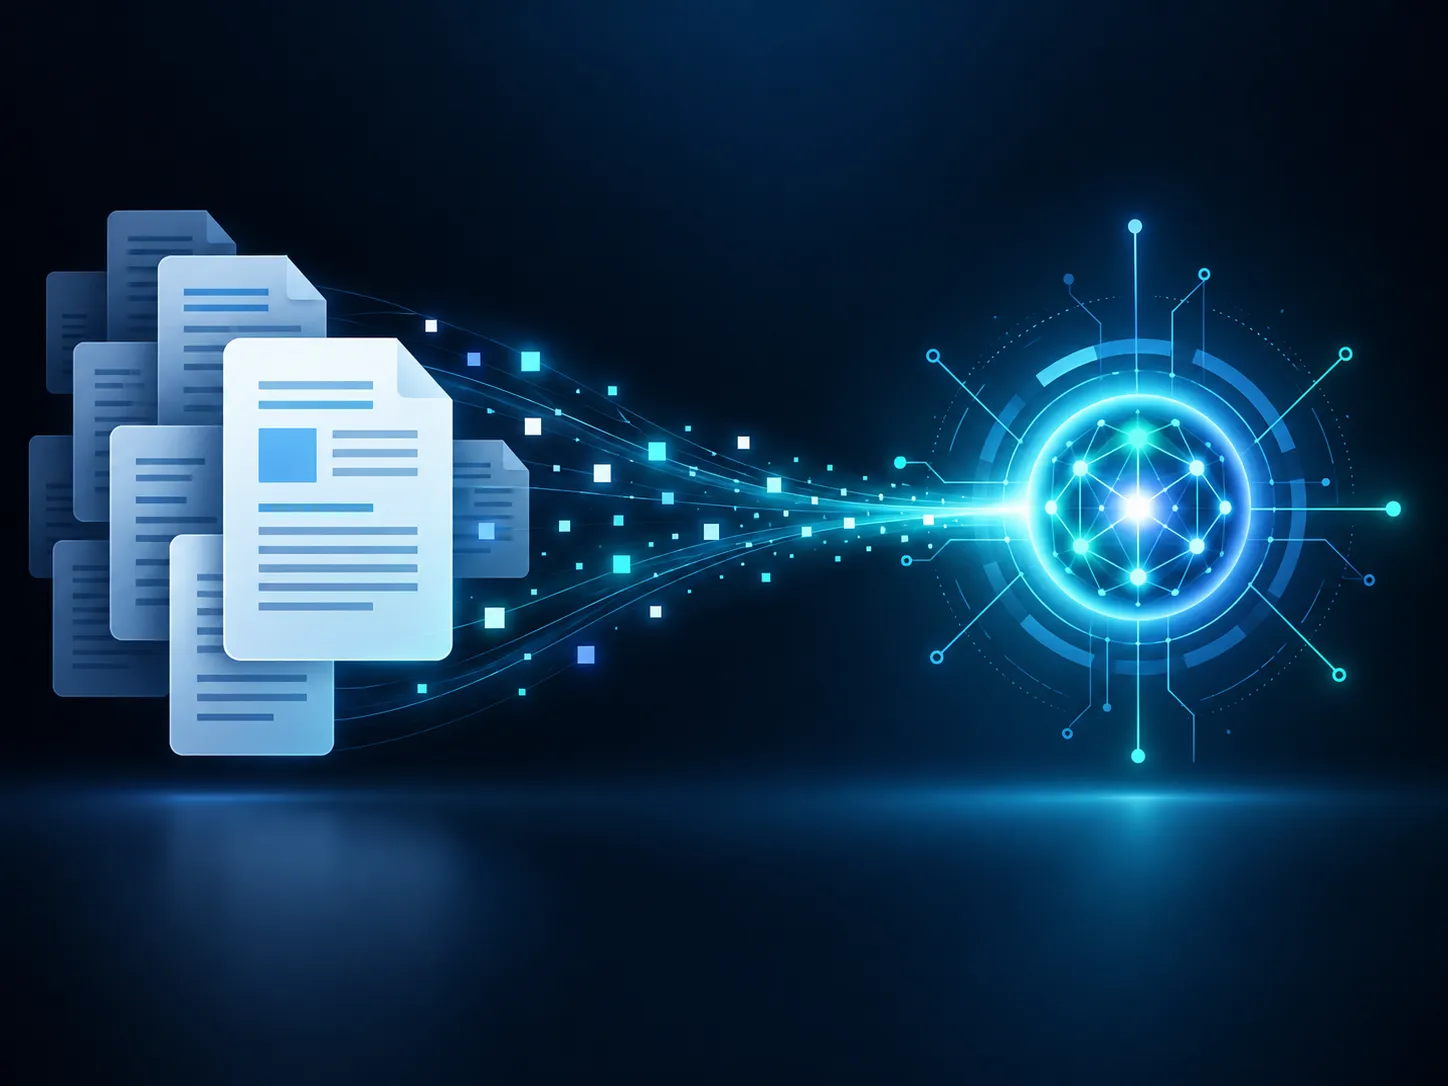
RAG는 모델이 답을 지어내기 전에 먼저 자료를 찾아 읽게 만드는 방식이다. 검색 증강 생성이라는 이름 그대로, 검색과 생성을 붙여 놓은 구조다.
RAG란 무엇이고 왜 등장했나
RAG는 검색 증강 생성(Retrieval-Augmented Generation)의 줄임말이다. 언어 모델이 답을 만들기 전에 외부 지식 소스에서 관련 문서를 먼저 가져오고, 그 내용을 참고해 답을 쓰게 하는 구조다.
등장한 이유는 모델의 한계를 우회하기 위해서다. 언어 모델은 학습된 시점까지의 지식만 갖는다. 학습이 끝난 뒤 생긴 정보는 모른다. 게다가 모르는 것을 물으면 그럴듯하게 지어내는 환각 현상이 있다.
모델을 다시 학습시키면 지식을 새로 넣을 수 있다. 하지만 그건 느리고 비싸다. 사내 문서처럼 자주 바뀌는 자료에는 맞지 않는다. RAG는 학습 대신 검색으로 이 문제를 푼다.
모델에 지식을 넣는 두 가지 길
지식을 새로 넣는 방법은 크게 둘이다. 두 방법은 비용과 속도에서 갈린다.
구분 | 파인튜닝 | RAG |
|---|---|---|
지식 반영 | 모델 가중치를 다시 학습 | 외부 문서를 매번 검색 |
갱신 속도 | 느림, 재학습 필요 | 빠름, 문서만 바꾸면 됨 |
비용 | GPU 학습 비용 큼 | 검색 인프라 비용 |
출처 표시 | 어려움 | 인용 가능 |
환각 억제 | 제한적 | 근거 문서로 억제 |
파인튜닝은 모델 자체를 특정 업무에 맞게 다듬는 데 강하다. 반면 최신 사실을 계속 반영해야 하는 일에는 RAG가 유리하다. 문서를 바꾸면 다음 질문부터 바로 반영되기 때문이다.
검색하고 생성하는 흐름
RAG는 이름 그대로 두 단계를 거친다.
먼저 검색 단계다. 사용자의 질문을 벡터로 바꾸고, 사전에 색인해 둔 문서 조각 중 의미가 가까운 것을 찾아낸다. 단어가 정확히 일치하지 않아도 의미가 비슷하면 찾을 수 있는 게 벡터 검색의 장점이다.
다음은 생성 단계다. 찾아낸 문서 조각을 질문과 함께 모델에 넘긴다. 모델은 이 자료를 참고해서 답을 쓴다. 이때 검색 결과에 근거하지 않은 내용을 지어내지 않도록 프롬프트로 지시하는 경우가 많다.
이 흐름이 갖는 의미는 명확하다. 모델의 답에 출처를 붙일 수 있게 된다. 어떤 문서를 보고 답했는지 사용자가 확인할 수 있으니, 잘못된 답을 걸러내기도 쉬워진다.
색인 단계가 품질을 좌우한다
RAG의 성능은 검색 단계에서 대부분 결정된다. 아무리 좋은 모델이라도 엉뚱한 문서를 받으면 엉뚱한 답을 낸다.
여기서 중요한 것이 문서를 잘게 나누는 작업, 즉 청킹이다. 문서를 너무 크게 자르면 필요한 부분이 묻히고, 너무 작게 자르면 문맥이 끊긴다. 적당한 크기로 나누고 겹치게 잘라 문맥을 이어 주는 식으로 조정한다.
색인을 만들 때는 문서를 벡터로 변환해 저장한다. 이때 쓰는 것이 임베딩 모델이다. 질문을 벡터로 바꿀 때와 같은 모델을 써야 검색이 제대로 동작한다.
RAG가 특히 맞는 상황
모든 질문에 RAG가 필요한 건 아니다. 최신 정보나 사내 자료처럼 모델이 모르는 내용을 다룰 때 효율이 크다.
사내 문서 검색이 대표적이다. 사규, 매뉴얼, 과거 티켓처럼 외부에 없는 자료를 근거로 답하게 할 수 있다.
고객 지원도 자주 쓰인다. 제품 문서와 FAQ를 색인해 두면, 상담원이 일일이 찾지 않아도 근거 있는 답을 얻는다.
법률이나 의료처럼 출처가 중요한 분야에도 맞는다. 답과 함께 참고 문서를 제시할 수 있기 때문이다. 다만 이런 분야에서는 RAG가 사람의 최종 검토를 대체하지는 못한다.
RAG에도 한계는 있다
RAG가 환각을 없애 주는 만능 도구는 아니다.
검색이 실패하면 답도 무너진다. 질문과 관련된 문서를 찾지 못하면 모델은 여전히 지어내거나, 엉뚱한 자료에 기대 답한다.
색인된 문서 자체가 틀렸거나 오래됐으면 답도 그대로 틀린다. RAG는 지식의 정확성이 아니라, 지식을 가져오는 경로를 보장할 뿐이다.
여러 단계를 거치는 질문에도 약하다. 한 번 검색한 자료로 답할 수 없는 복합 질문은 여러 번 검색하고 중간 결과를 엮는 추가 설계가 필요하다.
정리: 찾고 나서 답한다
RAG는 모델이 답하기 전에 자료를 먼저 찾게 만드는 구조다. 지식을 학습으로 넣는 대신 검색으로 가져오니, 최신 정보를 빠르게 반영하고 출처를 붙일 수 있다.
지금 사내 자료를 근거로 답하는 챗봇을 만들려 한다면 RAG가 좋은 출발점이다. 다만 검색 품질과 문서 상태가 결과를 좌우한다는 점은 처음부터 염두에 둬야 한다.