
Bright Data
Bright Data · 코딩
Bright Data는 웹 데이터 플랫폼이다. 프록시, 스크레이퍼, 기성 데이터셋을 팀에 제공해 공개 웹 데이터를 대규모로 수집한다.
Bright Data 소개
Bright Data란 무엇인가
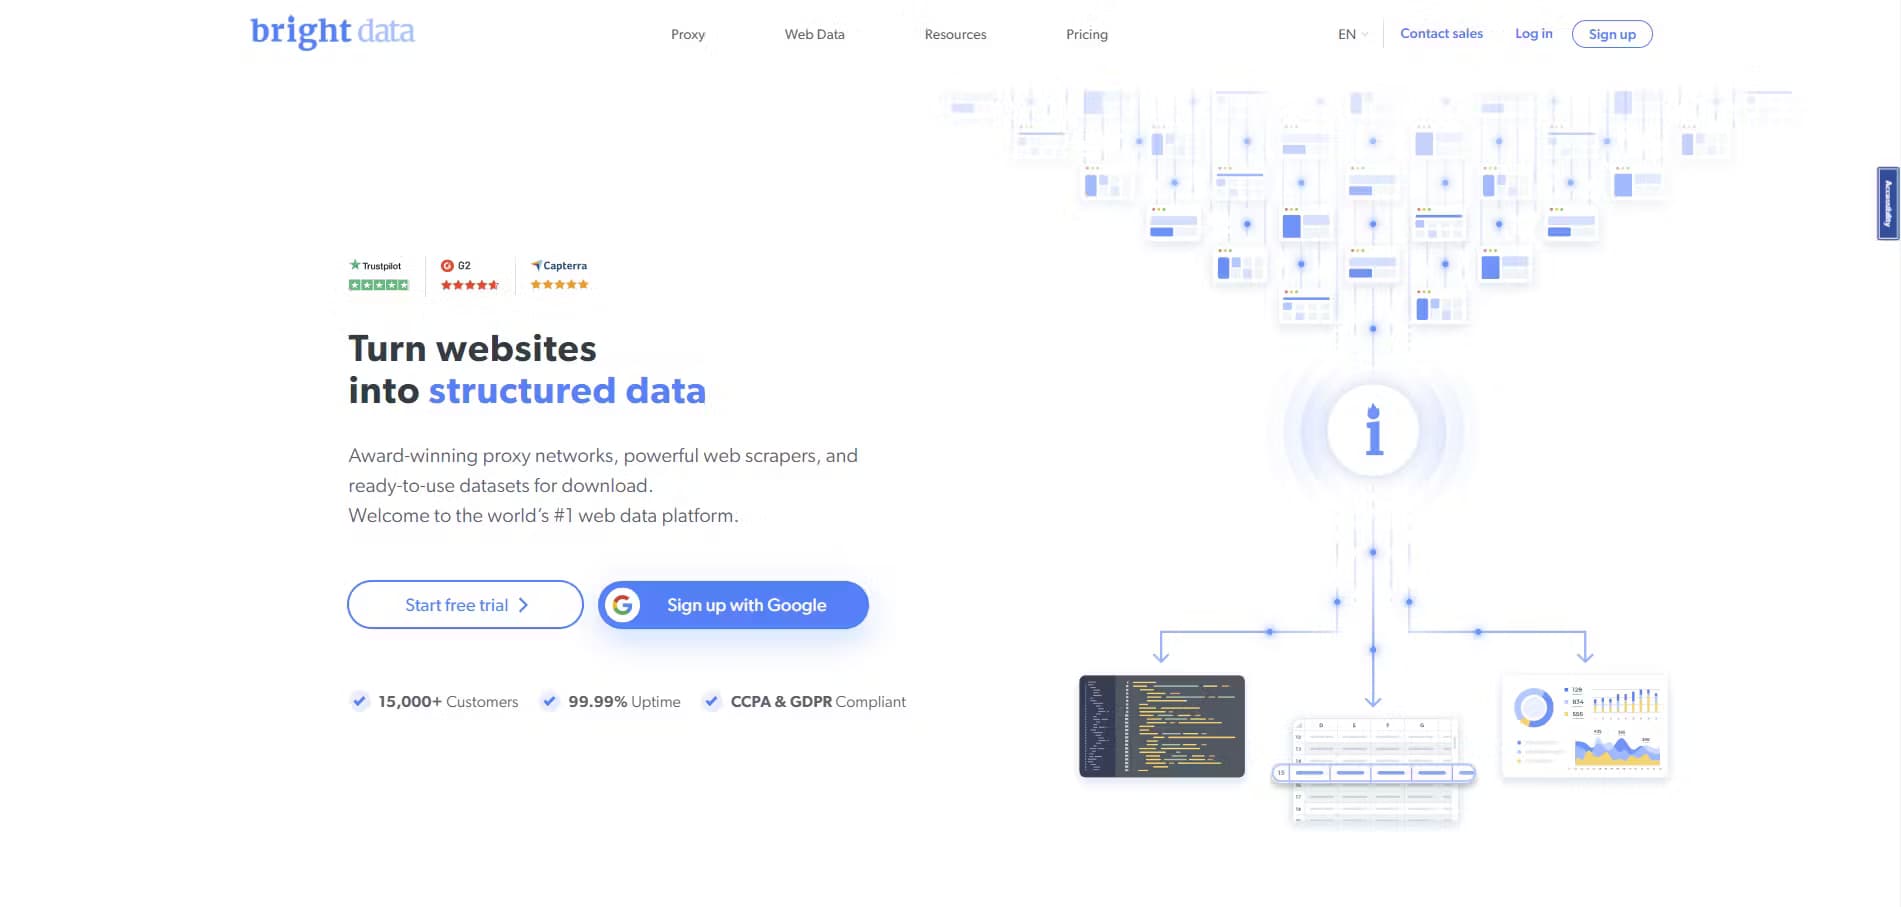
Bright Data는 차단당하지 않고 인터넷에서 공개 정보를 끌어내야 하는 기업을 위해 만들어진 웹 데이터 플랫폼이다. 프록시 네트워크, 웹 스크레이핑 도구, 미리 만들어진 데이터셋을 하나의 계정에 묶는다. 이 회사는 5만 개 이상 조직에 서비스를 제공한다고 밝힌다. 그 범위는 혼자 일하는 개발자부터 대기업까지 이어진다.
이것이 푸는 근본 문제는 접근이다. 웹사이트는 IP 차단, CAPTCHA, 핑거프린팅으로 봇을 막는다. 그 방어를 피해 직접 만드는 일은 느리고 고된 작업이다. Bright Data가 그 층을 대신 처리한다. 그러면 팀은 배관이 아니라 데이터에 시간을 쓴다.
저렴한 도구는 아니다. 프록시 종량제 가격은 GB당 약 4달러부터 시작하고, 무거운 요금제는 월 수백에서 수천 달러에 이른다. 몇백 건의 레코드를 한 번만 원한다면 더 싼 선택지가 있다. 규모, 안정성, 지역 커버리지가 최저가보다 중요할 때 Bright Data가 의미를 갖는다. 그게 전부다.
시작하기
- Bright Data 사이트에서 계정을 만들고 이메일을 인증한다. 시작하는 데 신용카드는 필요 없다.
- 프록시 네트워크, Web Scraper API, 기성 데이터셋 등 필요한 제품을 고른다.
- 대시보드에서 자격 증명을 가져와 API, SDK, 노코드 스크레이퍼로 연결한다.
- 작은 테스트 작업을 돌려 요청이 기대한 데이터를 반환하는지 확인한다.
- 규모를 키우고 지출 한도를 설정해 사용량을 예산 안에 유지한다.
제품 정보
Bright Data의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- 데이터 엔지니어
- 전자상거래 분석가
- AI 및 ML 팀
- 성장 및 마케팅 팀
작업
- 소매 사이트에서 상품 가격과 재고 상황을 대규모로 수집한다.
- SEO와 브랜드 모니터링을 위해 검색 엔진 결과를 스크레이핑한다.
- 공개 웹 페이지에서 언어 모델용 학습 데이터셋을 구축한다.
- 감정 분석을 위해 소셜 미디어와 리뷰 데이터를 모은다.
- 수동 내보내기 대신 webhook으로 정기 데이터 피드를 자동화한다.
활용 상황
- 여러 상점에 걸쳐 매일 가격 모니터링 파이프라인을 돌린다.
- 스크레이핑 스택을 처음부터 만들지 않고 새 시장을 조사한다.
- 신선한 공개 데이터를 사내 대시보드나 BI 도구에 공급한다.
- 예산을 확정하기 전에 무료 등급에서 스크레이퍼 아이디어를 테스트한다.
주요 기능
프록시 네트워크
Bright Data는 195개국에 4억 개 이상의 레지덴셜 IP를 갖춘, 가장 큰 축에 드는 프록시 네트워크를 운영한다. 국가, 주, 도시, 우편번호로 추가 비용 없이 타깃할 수 있다. 레지덴셜, ISP, 데이터센터, 모바일 프록시가 모두 있다. 공략할 사이트에 맞는 유형을 고르면 된다.
Web Scraper API
미리 만들어진 스크레이퍼가 LinkedIn, Amazon, Instagram 같은 주요 도메인을 커버한다. 성공적으로 반환된 레코드에만 비용을 낸다. 무료 등급은 월 5,000건의 레코드를 테스트용으로 준다. JSON이나 CSV로의 파싱이 포함되어 직접 추출 코드를 짤 필요가 없다.
Web Unlocker
차단을 우회하는 부품이 이것이다. IP를 돌리고, CAPTCHA를 풀며, 헤더와 사용자 에이전트, cookie를 자동으로 관리한다. 보호된 사이트에 자꾸 부딪히는 팀에게 스크레이핑에서 가장 지루한 부분을 덜어 준다. 마법은 아니다. 그래도 흔한 방어는 처리한다.
Scraping Browser
Puppeteer나 Playwright로 구동할 수 있는 원격 브라우저를 언락 기능과 함께 쓴다. 워크플로가 이미 그 도구를 쓴다면 Bright Data를 가리키기만 하면 인프라 구성을 건너뛸 수 있다. JavaScript에 크게 기대는 페이지에서 유용하다.
기성 데이터셋
처음부터 스크레이핑하는 대신 800개 이상 도메인을 커버하는 데이터셋을 살 수 있다. 정기적으로 갱신되고 API나 webhook으로 전달된다. 50억 건 이상의 레코드가 준비되어 있다. 데이터가 당장 필요하고 수집 방식은 상관없는 팀에 맞는다.
SERP API
여러 엔진의 실시간 검색 결과를 JSON이나 HTML로 끌어올 수 있다. 순위 추적, 광고 리서치, 사용자가 검색에서 무엇을 보는지 파악하는 데 유용하다. 이쪽에서 브라우저 자동화는 필요 없다. 브라우저 쪽 설정은 없다.
AI Scraper Studio
AI 지원 스크레이퍼 구축으로 웹사이트를 데이터 파이프라인으로 바꿀 수 있다. 사이트마다 선택자를 손으로 짜지 않아도 된다. 여러 다른 사이트를 스크레이핑하고 각각의 설정 시간을 줄이고 싶은 팀을 겨냥한다. 큰 시간 절약이다.
장단점
장점
- 4억 개 이상의 IP와 우편번호까지 세밀한 지역 타깃을 갖춘 프록시 네트워크.
- Web Scraper API에서는 성공적으로 전달된 레코드에만 비용을 내므로 실패한 요청에 돈이 들지 않는다.
- 월 5,000건 레코드의 무료 등급이 있고 카드도 필요 없어, 본격 도입 전 테스트에 좋다.
- 기성 데이터셋과 AI 스크레이퍼 빌더가 흔한 대상의 개발 공수를 줄인다.
- 폭넓은 도구 라인업이 프록시, 스크레이핑, 언락, 전달을 한곳에서 커버한다.
단점
- 가격이 빠르게 쌓인다. GB당 4~8달러의 프록시 대역폭은 대량 작업에 부담스럽다.
- 선택지의 깊이가 단순한 스크레이퍼를 원하는 초보자에게는 벅찰 수 있다.
- 대역폭과 레코드 사용량이 대상 사이트에 따라 달라져 비용 예측이 까다롭다.
- 법적·규정 준수 책임의 일부는 플랫폼이 아니라 이용자에게 남는다.
자주 묻는 질문
Bright Data는 공개 웹 데이터를 대규모로 수집하는 데 쓴다. 주 용도는 가격 모니터링, 검색 데이터, 시장 조사, AI 모델용 데이터셋 구축이다. 프록시와 스크레이퍼, 전달 도구를 제공해 그 인프라를 직접 만들지 않아도 된다.
관련 콘텐츠
Bright Data와 관련된 도구, 스킬, 아티클을 살펴보세요.
Bright Data 대안
Forefront
Forefront · 코딩Forefront는 오픈소스 AI로 무언가를 만드는 웹 플랫폼이다. 대표적인 오픈소스 언어 모델을 자신의 데이터로 미세 조정하고, 성능을 평가하고, API로 실행하거나 내보내 직접 호스팅할 수 있다. 폐쇄형 플랫폼의 편의를 원하면서도 모델과 데이터의 소유권은 놓지 않으려는 개발자가 대상이다.

Startkit
StartKit.AI · 코딩Startkit은 AI SaaS와 AI 래퍼 제품을 만들기 위한 보일러플레이트다. 지루한 부분을 미리 연결해 둔 AI 스타트업 보일러플레이트라고 생각하면 된다. 인증, Stripe와 Lemon Squeezy 결제, 사용량 제한, 트랜잭션 이메일, 그리고 OpenAI, Anthropic, Groq, Llama와 통신하는 AI API 스타터 키트가 포함된다. 저장소를 복제하고 가격을 정한 뒤 사용자가 실제로 돈을 내는 부분에 착수하면 된다. React와 Tailwind 위의 Next.js로 만들어졌기 때문에 보일러플레이트 코드의 상당 부분이 이미 익숙하게 느껴진다.
Testim
Tricentis · 코딩Testim은 웹, 모바일, Salesforce 애플리케이션 전반에 걸쳐 엔드투엔드 테스트를 만들고 실행하는 AI 기반 테스트 자동화 플랫폼이다. 머신러닝에 기대어 인터페이스가 바뀌어도 테스트를 안정적으로 유지하므로, 팀은 깨진 셀렉터를 고치는 데 쓰는 시간을 줄인다. 오늘부터 쓸 수 있는 자동화 테스트 도구치고 나쁘지 않다. 브라우저에서 동작을 녹화해 테스트를 만들고, 더 세밀한 제어가 필요하면 JavaScript를 더한다. 바쁜 QA 팀에게 탄탄한 선택이다.