

Confident AI
Confident AI · 기타
Confident AI는 오픈소스 DeepEval을 기반으로 한 LLM 평가 플랫폼이다. 출시 전 AI 앱을 테스트하고 연구 기반 지표로 응답을 채점하며, 출시 후에는 실제 트래픽을 관측한다.
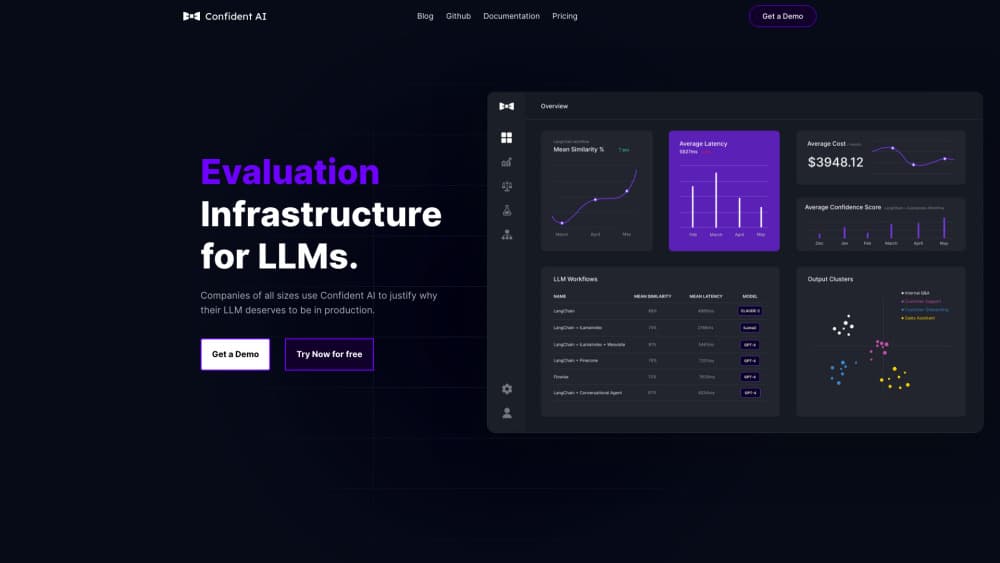
Confident AI 소개
About
Confident AI란
Confident AI는 대규모 언어 모델 기반 앱을 테스트하고 관측하는 웹 플랫폼이다. 대부분의 팀이 막히는 지점은 프롬프트를 고치거나 모델을 바꾼 뒤에도 챗봇, RAG 파이프라인, 에이전트가 여전히 제대로 작동한다는 사실을 증명하는 일이다. 테스트 케이스는 파이썬으로도, 브라우저에서도 작성한다. 앱에 대해 실행하면 지표별 점수와 그 근거가 함께 돌아온다.
회사는 플랫폼 지표를 떠받치는 오픈소스 평가 프레임워크 DeepEval도 유지한다. 이 점이 실무에서 중요하다. 같은 검사를 로컬 DeepEval로 돌리고 결과만 Confident AI로 보내 팀이 함께 볼 수 있다. 품질 판단이 특정 업체의 블랙박스에 갇히지 않는다.
가장 큰 제약은 가격이다. 무료 플랜은 프로젝트 1개, 사용자 2석, 주 5회 실행까지다. 본격적인 사용은 월 200달러의 Starter부터 시작한다. 가끔 확인만 하는 용도라면 이 비용을 정당화하기 어렵다.
시작하는 방법
- confident-ai.com에서 무료 계정을 만들고 프로젝트 설정에서 API 키를 복사한다.
pip install -U deepeval로 SDK를 설치하고deepeval login을 실행해 로컬 프레임워크를 클라우드 프로젝트에 연결한다.- 파이썬 파일에 지표와 테스트 케이스를 정의한다. 유료 플랜이라면 브라우저의 노코드 화면에서 만들어도 된다.
- 테스트를 실행하고 대시보드에서 지표별 점수를 확인한 뒤 보고서 링크를 팀에 공유한다.
제품 정보
Confident AI의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- RAG 파이프라인이나 에이전트를 만드는 AI 엔지니어
- AI 기능을 맡은 프로덕트 매니저
- LLM 테스트로 넘어오는 QA 팀
작업
- 출시 전 환각 잡기
- 모델이나 프롬프트 설정 두 가지 비교
- 실서비스 장애를 테스트 케이스로 전환
- 고객용 챗봇 레드팀
활용 상황
- 매주 모델을 갈아끼우는 스타트업
- 여러 프로덕트 팀의 평가 기준을 통일하려는 기업
- 이미 실서비스 중인 지원 봇
주요 기능
연구 기반 지표 라이브러리
DeepEval로 만든 50개 이상의 AI 평가 지표를 담고 있으며 단일 턴과 멀티 턴을 모두 다룬다. 응답 관련성, 충실성, 컨텍스트 정밀도와 리콜, 환각, 편향, 유해성, 그리고 도구 호출 정확성 같은 에이전트 전용 검사가 포함된다. 표준 지표가 맞지 않으면 커스텀 G-Eval로 판단 기준을 자연어로 적을 수 있다.
멀티 턴 대화 시뮬레이션
응답 하나만 채점하지 않는다. 시뮬레이터가 앱을 상대로 대화를 끝까지 진행하고 전체 흐름을 평가한다. 몇 번 주고받은 뒤에야 드러나는 문제, 예컨대 앞서 받아들인 조건을 잊는 봇 같은 결함이 여기서 잡힌다. 페르소나와 목표를 정하면 발화는 플랫폼이 생성한다.
CI/CD 회귀 테스트
LLM 회귀 테스트는 GitHub Actions, GitLab CI, Jenkins, API를 호출할 수 있는 아무 파이프라인에서나 돈다. 지표가 떨어지면 깨진 단위 테스트처럼 머지를 막을 수 있다. 실행은 모두 저장되므로 버전마다 비교하며 점수가 꺾인 시점을 정확히 짚을 수 있다.
실서비스 트래픽의 AI 옵저버빌리티
트레이싱이 프로덕션 앱의 요청, 스팬, 스레드를 기록하고 각각에 지표 점수를 붙인다. 낮은 점수로 트레이스를 걸러내고, 시간에 따른 드리프트를 살피고, 반복 출력이나 사용자 불만 신호에 경보를 걸 수 있다. 다른 도구에서 옮겨와도 OpenTelemetry 스팬은 그대로 살아 있다.
사람 주석과 지표 정합성
주석 큐를 쓰면 도메인 전문가가 자체 기준으로 출력을 검토한다. 이어서 플랫폼이 사람 라벨과 지표 점수를 나란히 놓고 어긋나는 지점을 보여준다. 이 간극이 쓸모 있다. 릴리스 게이트로 쓰기 전에 그 지표가 지나치게 관대한지 판단할 수 있다.
노코드 워크플로와 MCP 접근
유료 플랜에서는 평가 대상을 실제 API 엔드포인트로 지정하고 응답을 가공하며 정기 실행을 예약할 수 있다. 코드는 필요 없다. MCP 서버를 쓰면 Cursor나 Claude Code의 코딩 에이전트가 에디터 안에서 평가를 돌리고 결과를 가져온다.
장단점
장점
- DeepEval이 오픈소스라 검사를 로컬에서 돌리고 지표 코드를 직접 읽을 수 있다. 닫힌 채점 엔진을 믿을 필요가 없다.
- 점수마다 설명이 붙어 테스트를 쓰지 않은 사람도 실패 원인을 따라갈 수 있다.
- 트레이싱과 평가가 한곳에 있어 프로덕션 데이터가 곧바로 새 테스트 케이스가 된다.
- 연동이 흔한 스택을 덮는다. OpenAI, Claude, Gemini, Bedrock, LangChain, LlamaIndex, CrewAI, OpenTelemetry.
- 기업용 통제로 SSO, 커스텀 RBAC, SOC 2, HIPAA, 온프레미스 배포를 제공한다.
단점
- 무료 플랜은 프로젝트 1개, 2석, 주 5회 실행까지다. 제품을 맛보는 데는 충분하고 그 이상은 어렵다.
- 팀 단위 실사용은 월 200달러부터라 개인 개발자나 작은 프로젝트에는 부담이 크다.
- 노코드 평가, 온라인 평가, 경보는 유료 기능이라 무료 티어는 여전히 파이썬을 다룰 줄 안다고 가정한다.
- 판정 모델 호출 비용은 직접 부담한다. 데이터셋이 크고 판정 모델이 강할수록 청구서가 빠르게 불어난다.
자주 묻는 질문
LLM 앱을 테스트하고 관측한다. 테스트 케이스와 지표를 정의해 앱에 실행하면 설명이 붙은 점수가 나온다. 같은 플랫폼이 이후 실서비스 트래픽을 지켜보며 들어오는 요청을 채점한다.
관련 콘텐츠
Confident AI와 관련된 도구, 스킬, 아티클을 살펴보세요.
Confident AI 대안

JarvisCore
Prescott Data · 코딩 · 생산성 · 기타JarvisCore는 AI 에이전트가 대등한 피어로 메시를 이루고 공유 원장에서 작업을 가져가며 제로트러스트 브로커를 통해 외부 서비스를 호출하는 오픈소스 Python 런타임이다.
Clef
Cloudflare · 비즈니스 · 기타Clef는 Workers AI에서 도는 Cloudflare의 오픈소스 의사결정 모델이다. 생성된 문장 대신 정해진 질문에 확률을 돌려주므로, 에이전트가 빠르게 분류하고 라우팅하고 행동한다.

iFixAi
iFixAi · 비즈니스 · 기타iFixAi는 AI 에이전트를 위한 오픈소스 감사 도구다. 업무 시뮬레이션 위에서 에이전트를 돌리고 응답을 하나씩 채점해 근거가 붙은 A~F 스코어카드를 내놓는다.