
DreamActor-M1 From ByteDance
ByteDance · 동영상
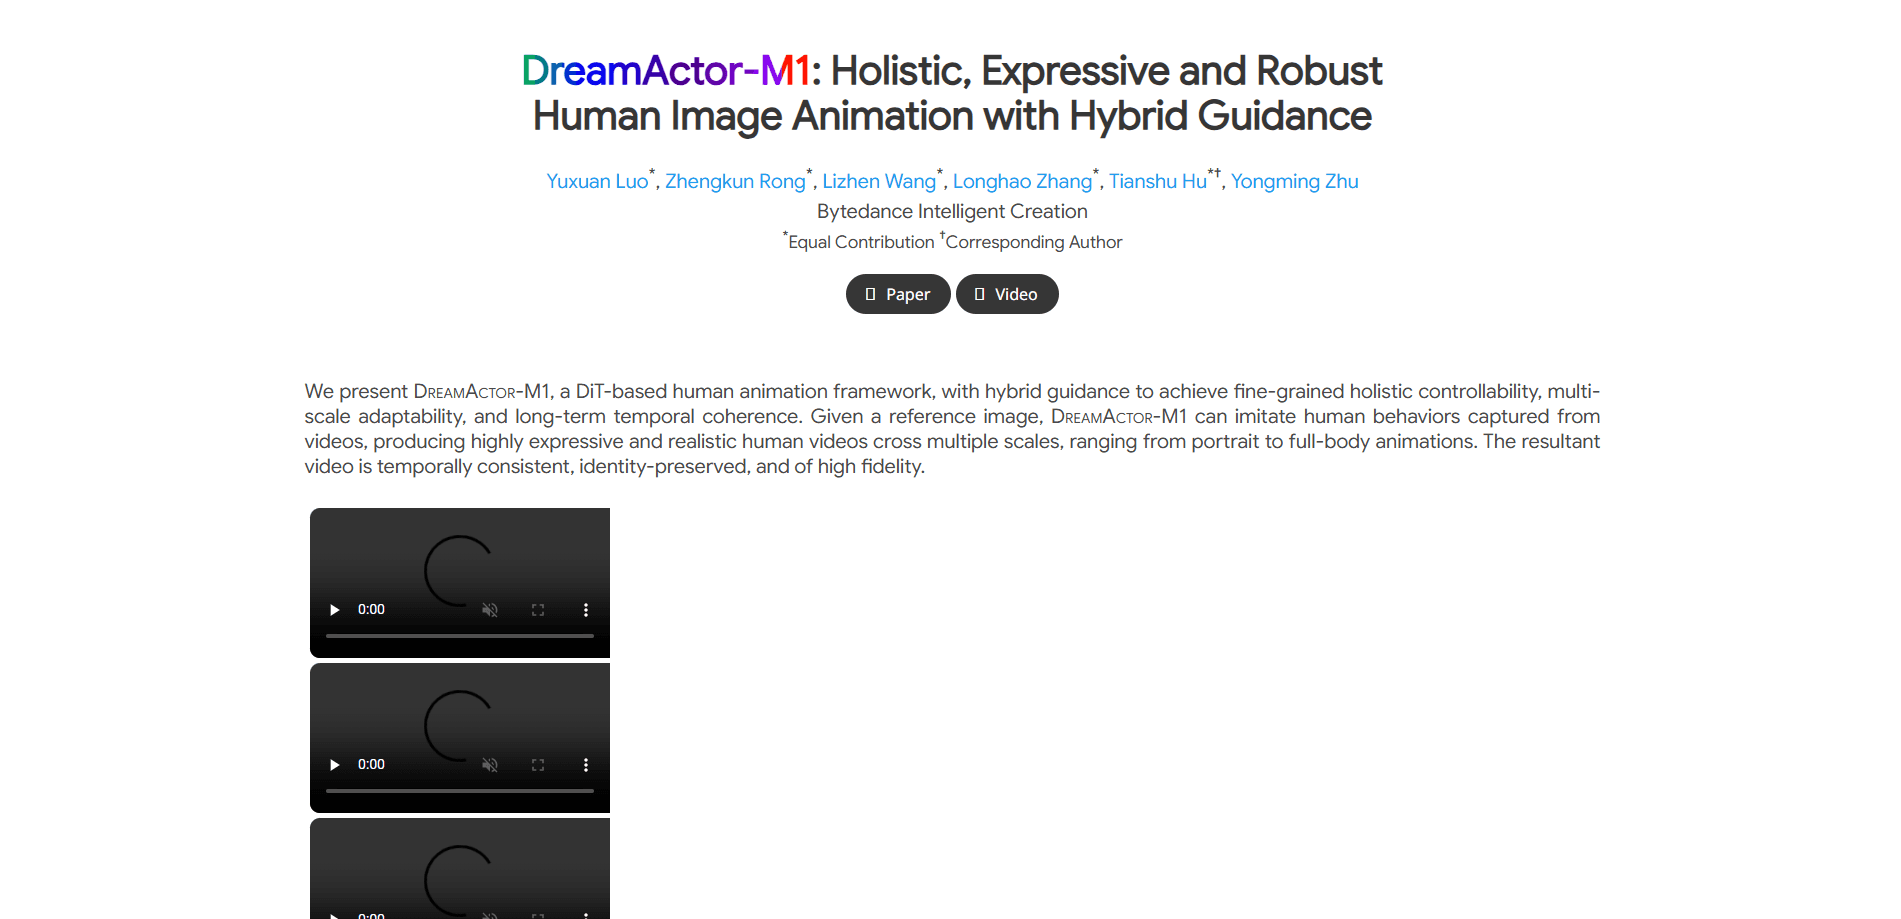
DreamActor-M1은 ByteDance의 AI 인간 애니메이션 모델이다. 참조 사진 한 장에서 구동 영상의 동작을 그대로 옮겨 인물을 움직이게 만든다.
DreamActor-M1 From ByteDance 소개
About
DreamActor-M1이란
DreamActor-M1은 ByteDance Intelligent Creation이 만든 인물 이미지 애니메이션 모델이다. 이 회사의 생성 미디어 연구를 맡은 팀의 결과물이다. 인물 참조 사진 한 장과 구동 영상을 넣으면, 그 인물이 영상처럼 움직이는 장면을 다시 세운다. 결과물은 얼굴과 몸, 그리고 인물의 정체성을 그대로 지키면서 포즈와 표정, 카메라 각도만 바꾼다.
이 모델이 메우는 것은 기존 도구가 남겨 둔 틈이다. 대부분의 시스템은 얼굴 클로즈업이나 전신 가운데 하나만 다루고, 팔다리가 화면 밖으로 나가거나 영상이 길어지면 무너진다. DreamActor-M1은 그 둘을 모두 아우른다고 내세운다. 머리와 어깨가 꽉 찬 구도부터 전신 화면까지 대응하고, 긴 영상에서도 일관성을 유지한다. 이건 연구로 공개된 것으로, 논문과 프로젝트 페이지 형태다. 일반 사용자를 위한 앱이 아니다. ByteDance 인간 애니메이션의 방향을 가늠하는 자료이며, Dreamina나 CapCut 같은 제품에 들어간 애니메이션 기능과 견줘 볼 수 있는 결과물 묶음이다. AI 인물 사진 애니메이션을 지켜보던 사람이라면 더 닫힌 도구를 가리키는 여러 발상을 알아볼 것이다.
도구를 찾는 쪽이라면 이 차이가 크다. 가입도, 가격 페이지도, 다운로드 링크도 없어서 지금 당장 DreamActor-M1을 직접 돌릴 수는 없다. ByteDance의 애니메이션 기술이 어디로 향하는지를 보여 주는 것이고, Dreamina나 CapCut 같은 제품에 들어간 애니메이션 기능과 견줘 볼 수 있는 결과물 묶음이다.
시작하는 방법
- 공식 프로젝트 페이지를 열고 구동 영상과 생성 결과를 나란히 놓은 비교 데모를 본다
- 논문(arXiv:2504.01724)을 읽고 방법과 학습 단계, 다른 모델과의 비교표를 확인한다
- 호스팅된 데모도, API도, 저장소도 공개되지 않아서 자기 사진과 영상을 올릴 공개 경로가 없다는 점을 기억한다
- 인간 애니메이션이 당장 필요하면 Dreamina나 CapCut처럼 이미 나온 ByteDance 도구나, 공개 접근이 되는 경쟁 모델을 본다
제품 정보
DreamActor-M1 From ByteDance의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- AI 연구자와 학생
- 영상 제작자와 애니메이터
- 애니메이션 구성을 검토하는 개발자
- 미디어와 이커머스의 제품 담당자
작업
- 멈춰 있는 인물 사진을 말하거나 움직이는 클립으로 바꾸기
- 포즈 전이
- 부분 동작 제어
- 오디오 기반 얼굴 애니메이션
- 애니메이션 품질 비교
활용 상황
- 단편이나 광고 소재를 찾을 때
- 오래된 사진을 되살릴 때
- 아바타 제작 흐름을 시험할 때
- 생성 영상 수업을 할 때
- 공급업체를 검토할 때
주요 기능
하이브리드 동작 유도
제어 시스템은 세 신호를 결합한다. 암묵적 얼굴 표현, 3D 머리 구체, 3D 신체 골격이다. 머리 구체는 머리의 위치와 방향을 따라가고, 골격은 몸의 움직임을 맡고, 얼굴 인코딩은 표정을 싣는다. ByteDance에 따르면 이 조합이 얼굴과 몸을 함께 움직인다. 한쪽을 희생하는 골격만의 애니메이션에서 흔한 약점을 피하려는 것이다.
다중 스케일 적응
DreamActor-M1은 어떤 구도에서도 작동하도록 만들어졌다. 꽉 찬 인물 사진부터 전신 화면까지, 피사체가 화면에서 작아져도 품질이 떨어지지 않는다. ByteDance는 해상도와 스케일이 다른 데이터로 단계를 밟아 학습시켰다. 모델 하나가 클로즈업과 댄스 클립을 모두 감당할지, 둘 중 하나를 골라야 할지를 가르는 부분이 여기다.
장시간 일관성
긴 클립에서는 연속 프레임에서 동작 패턴을 끌어오고 시각 참조를 더한다. 참조 이미지에 없는 부위는 이 방식이 처리를 대부분 떠맡는다. 프로젝트 데모는 이 점에 기대어 손이나 등이 화면에 들어오고 나가도 안정적으로 유지한다. 많은 애니메이션 도구가 깜빡이거나 일그러지기 시작하는 지점이다.
부분 동작 전이
동작의 일부만 옮길 수 있다. 프로젝트는 얼굴과 머리만 옮기고 몸은 원래 자세에 두는 결과를 보여 주며, 뼈 길이를 조정해 키가 큰 피사체나 작은 피사체도 형태를 깨지 않고 움직이는 사례도 있다. 전신 재현이 아니라 표정 변화만 얹고 싶을 때 쓸모가 있다.
오디오 기반 얼굴 애니메이션
영상으로 움직임을 유도하는 것에서 더 나아가 음성으로도 확장된다. 여러 언어의 오디오에서 입 모양 동기화를 생성하며, 더빙과 가상 진행자를 겨냥한다. 데모에서는 입이 오디오에 맞고 나머지 연기는 일관되게 유지된다.
확산 트랜스포머 기반
엔진은 확산 트랜스포머(DiT)다. 지금의 많은 이미지와 영상 모델이 쓰는 것과 같은 계열의 구조다. 이 확산 트랜스포머 애니메이션 방식에서는 3D VAE가 클립을 인코딩하고, 포즈 인코더가 골격과 머리 구체를 맡고, 얼굴 동작 인코더가 교차 주의를 통해 표정을 더한다. AI 포즈 전이의 핵심인 골격 처리를 여기서 담당한다. 참조 이미지는 노이즈가 낀 영상과 같은 트랜스포머 가중치를 거친다. 결과물에서 정체성이 유지되는 이유다.
장단점
장점
- 모델 하나로 인물 사진, 상반신, 전신 애니메이션을 아우르므로 구도마다 도구를 바꾸지 않아도 된다
- 긴 클립에서도 정체성과 세부를 지키며, 참조 이미지에 없는 부위까지 다룬다
- 부분 전이를 지원해서 전신이 필요 없을 때 얼굴과 머리만 움직일 수 있다
- 여러 언어의 오디오 기반 입 모양 동기화를 더해 영상 대 영상이라는 틀을 넘는다
- 방법과 비교를 담은 논문이 있어 주장을 확인할 수 있다
단점
- 공개 데모도 API도 코드도 없어서 자기 사진과 영상으로 지금 당장 돌릴 수 없다
- 가격도 가입도 최종 사용자용 문서도 없어서 바로 사는 도구로는 쓸 수 없다
- 품질을 판단하려면 자기 테스트가 아니라 프로젝트 자체의 데모와 표에 기대야 한다
- 이런 연구 결과는 제품이 되기 전에 멈출 수도 있어서 계획할 일정이 없다
자주 묻는 질문
DreamActor-M1은 ByteDance의 인물 이미지 애니메이션 모델이다. 참조 사진과 구동 영상이 있으면 그 인물이 영상처럼 움직이는 장면을 만들어 내고, 얼굴과 정체성을 그대로 지킨다. ByteDance Intelligent Creation 팀이 ICCV 2025에서 발표했다.
관련 콘텐츠
DreamActor-M1 From ByteDance와 관련된 도구, 스킬, 아티클을 살펴보세요.
DreamActor-M1 From ByteDance 대안

Skreno
Skreno · 동영상 · 생산성Skreno는 브라우저 화면 녹화 도구다. 탭, 창, 전체 화면을 그대로 담고 AI 스크립트와 요약, 콘솔 로그를 하나의 공유 링크에 붙인다.
Onepin
Podonos · 음성 및 언어 · 동영상Onepin은 대본의 각 문장을 가장 알맞은 TTS 모델로 보내고, 테이크마다 점수를 매기며, 잘못 읽은 이름과 숫자를 고쳐 내보내는 AI 음성 제작 에이전트다.
OpenVids
bazodev · 동영상OpenVids는 macOS와 Windows에서 쓰는 무료 오픈소스 영상 편집 소프트웨어다. AI 에이전트 네 개가 타임라인을 자르고 모션과 사운드를 더하고 렌더를 점검하지만, 최종 판단은 편집자에게 남는다.