
EnergeticAI
EnergeticAI open-source project · 코딩
EnergeticAI는 서버리스 함수에 맞춰 다듬은 TensorFlow.js 오픈소스 배포판으로, Node.js 앱에서 임베딩 모델이나 텍스트 분류기를 약 50ms 콜드 스타트로 돌린다.
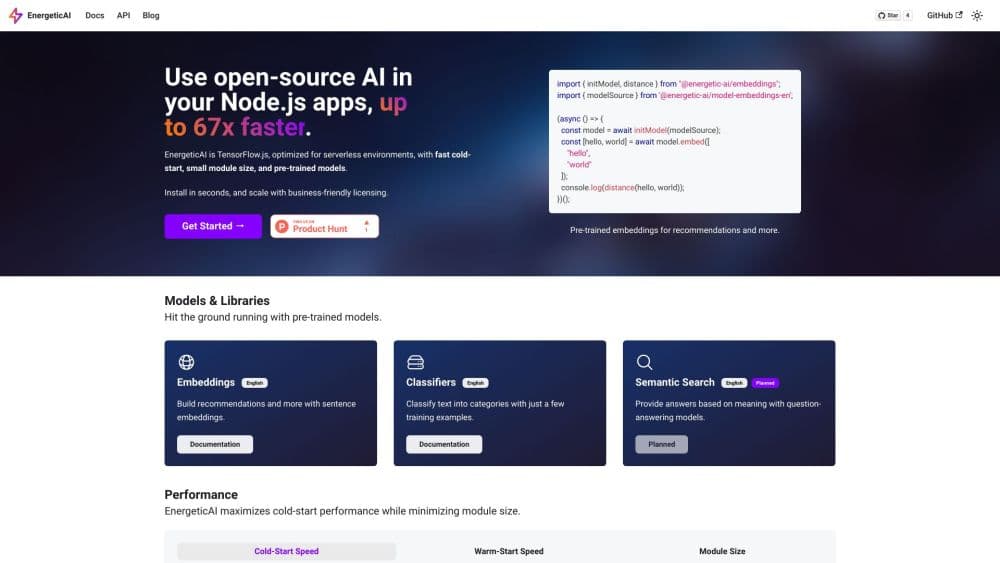
EnergeticAI 소개
What Is EnergeticAI
EnergeticAI는 AWS Lambda, Vercel Functions, Netlify Functions 같은 서버리스 함수를 위해 TensorFlow.js를 덜어내고 다시 포장한 것이다. 해결하는 문제는 배포 단계에서 아주 구체적으로 나타난다. 원본 TensorFlow.js는 압축하지 않은 상태에서 146MB에서 513MB에 이르기 때문에 코드가 실행되기도 전에 번들 크기 한도에 걸린다. 게다가 모델 가중치를 첫 호출 때 내려받기 때문에 콜드 스타트가 2초를 넘긴다.
이 프로젝트는 추론에 필요한 부분만 남긴다. 모듈은 약 3MB로 줄고, 제공처가 직접 잰 콜드 스타트 추론은 50ms 안팎이며, 코어 패키지는 @tensorflow/tfjs-core를 그대로 대체한다. 이미 쓰던 코드와 모델은 대개 손대지 않고 돌아간다.
제약도 장점만큼 크다. 사전 학습 모델은 영어 임베딩과 텍스트 분류만 담당하고, 시맨틱 검색은 여전히 계획 중으로 표시되며, 연산은 WebAssembly로만 돌아가 GPU는 쓰지 않는다. npm 버전은 2023년 6월에 나온 0.2.0이니, 계속 커지는 플랫폼이 아니라 안정적이지만 조용한 프로젝트로 보는 편이 맞다.
Getting Started
- Node 18 이상을 준비하고 코어 패키지와 쓸 모델 라이브러리를 설치한다.
npm install @energetic-ai/core @energetic-ai/embeddings @energetic-ai/model-embeddings-en - 모델 라이브러리에서
initModel과 해당 모델 소스를 불러오고, 함수 인스턴스마다 가중치를 한 번만 로드한다. - 문자열 배열에
model.embed()를 호출하면 벡터가 나온다. 분류기 패키지를 쓴다면 라벨이 붙은 예시 수십 개로 학습시킨다. - 함께 들어 있는
distance로 벡터를 비교하고, 그 점수를 정렬, 필터링, 라우팅 로직에 연결한다. - 서버리스 호스팅에 배포한 뒤 번들 크기를 확인한다. 그 한도가 바로 EnergeticAI로 갈아타는 이유다.
제품 정보
EnergeticAI의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- 서버리스로 배포하는 Node.js 개발자. TensorFlow.js가 통과하지 못하는 번들 한도를 넘으라고 만든 라이브러리이므로, 시간은 기능에 쓰고 패키징 꼼수에는 쓰지 않는다.
- 개인 개발자와 작은 팀. 추론 요금도 API 키도 없어서 트래픽이 실제로 붙기 전까지 사이드 프로젝트 비용은 0이다.
- 데이터 규칙이 엄격한 팀. 추론이 자기 함수 안에서 끝나고 텍스트가 인프라 밖으로 나가지 않으며, 개인정보 문서에 처리 업체를 한 줄 더 추가할 필요도 없다.
- 첫 AI 기능을 붙이는 백엔드 엔지니어. 사전 학습 모델이 흔한 경우를 덮어 주므로 학습 파이프라인도, GPU도, 대기 중인 머신러닝 전문가도 필요 없다.
작업
- 임베딩 모델로 상품 추천을 만든다. 카탈로그를 한 번 색인하고, 요청마다 페이지 맥락 벡터를 만들어 거리순으로 정렬한다.
- 라벨 붙은 예시 수십 개로 텍스트 분류기를 학습시켜 지원 티켓이나 폼 내용을 분류한다.
- 리뷰, 피드백, 중복 매물을 벡터 거리로 묶는다. 키워드 규칙을 계속 써 내려갈 필요가 없다.
- 문서 수백 건에 가벼운 시맨틱 검색을 얹는다. 다만 전용 모델은 아직 계획 중이라는 점은 받아들여야 한다.
활용 상황
- 번들 상한이 빡빡한 무료나 저가 요금제에 올릴 때. 3MB 모듈이 배포 가능 여부를 가른다.
- 외부 API로 보낼 수 없는 텍스트를 다룰 때. 사내 티켓, 진료 메모, 계약 아래 있는 고객 데이터가 그렇다.
- 노트북에서 AI 기능을 프로토타입하고 같은 코드를 운영에 올릴 때. 벤더 SDK에 맞춰 모델 계층을 다시 쓰지 않아도 된다.
주요 기능
서버리스에 맞춘 패키징
프로젝트 전체가 함수 플랫폼의 제약을 기준으로 짜여 있다. 모듈은 약 3MB까지 줄어 Lambda와 엣지 환경의 일반적인 한도에 들어간다. 원본 TensorFlow.js는 그 지점에서 막힌다. 모델 가중치는 첫 호출 때 받는 대신 패키지에 함께 들어 있어서, 식은 컨테이너가 네트워크를 기다리지 않고 응답한다.
콜드 스타트
공식 사이트는 서버리스 함수에서 추론 속도가 TensorFlow.js보다 최대 67배 빠르다고 밝힌다. M1 Max 맥북 프로에서 모델을 초기화하고 다섯 문장짜리 문단을 임베딩하는 조건에서 잰 값이다. 실제 수치는 호스팅과 입력 길이에 따라 달라진다. 방향은 같다. 몇 초가 아니라 수십 밀리초이고, 요청이 시간 초과로 끊길지 여부가 여기서 갈린다.
사전 학습 임베딩 모델
임베딩 패키지는 문자열을 비교하고 묶고 정렬할 수 있는 벡터로 바꾼다. 영어 모델은 별도 가중치 패키지로 제공되므로 필요한 언어만 설치한다. 직접 학습하지 않고 추천과 유사도 검색에 도달하는 가장 짧은 길이다.
적은 예시로 배우는 텍스트 분류기
분류기 패키지는 실행 시점에 작은 라벨 집합으로 학습한다. 전체 데이터셋이 아니라 20개나 50개짜리 사례만 있는 라우팅과 태깅에 맞는다. 라벨은 저장소에 두고 배포할 때마다 다시 학습하므로, 동작이 코드와 함께 버전 관리된다.
TensorFlow.js와의 직접 호환
코어 모듈은 @tensorflow/tfjs-core의 API를 그대로 따르므로 기존 import와 모델 코드가 대개 그대로 돈다. 서비스 전체를 바꾸기 전에 엔드포인트 하나에서 시험할 수 있어 시도 비용이 낮다.
WebAssembly 백엔드
추론은 WebAssembly로 실행된다. 짧은 입력에는 충분히 빠르고 네이티브 빌드 없이 어떤 Node 호스트에서도 돌아간다. GPU 가속은 없어서 큰 배치와 긴 문서는 CUDA 장비보다 확실히 느리다.
장단점
장점
- 번들 크기가 수백 MB에서 약 3MB로 줄어든다. 서버리스 요금제에 모델을 올릴 수 있느냐는 대개 여기서 결정된다.
- 제공처 측정으로 콜드 스타트가 50ms 부근이라, 사용자 요청이 모델 로딩에 걸려 멈추지 않는다.
- Apache 2.0 라이선스에 사전 학습 모델도 비슷한 조건으로 골라 두어 상업적 사용 절차가 단순하다.
- 호출당 과금이 없고 데이터가 함수 밖으로 나가지 않는다. 호스팅형 임베딩 API와는 이 지점이 크게 다르다.
- 코어 패키지가 기존 TensorFlow.js 코드에 그대로 들어가므로 이전은 보통 의존성 교체로 끝난다.
단점
- 사전 학습 모델이 영어뿐이라 다국어 제품은 자체 가중치와 추가 검증이 필요하다.
- GPU를 지원하지 않아 큰 배치는 느리고, 문서가 많으면 작은 함수에서 요청당 몇 초가 걸릴 수 있다.
- 모델 종류가 적다. 지금은 임베딩과 분류기뿐이고 시맨틱 검색은 계획 중이다.
- npm에는 2023년 6월의 0.2.0에서 멈춰 있다. 업데이트가 느린 프로젝트를 받아들이는 셈이니 버전을 고정하고 문제가 생기면 소스를 읽어야 한다.
자주 묻는 질문
서버리스 함수 안에서 오픈소스 AI 모델을 돌린다. 상품 추천, 텍스트 분류, 중복 탐지, 시맨틱 검색처럼 머신러닝 스택 전체를 실을 수 없는 Node.js 백엔드에서 주로 쓴다.
관련 콘텐츠
EnergeticAI와 관련된 도구, 스킬, 아티클을 살펴보세요.
EnergeticAI 대안

Base Code
Base44 (Wix) · 코딩 · 생산성Base Code는 Base44가 만든 공유 클라우드 개발 환경이다. 팀은 기존 GitHub 저장소에 대한 변경을 채팅으로 설명하고, 미리보기로 확인한 뒤 풀 리퀘스트로 돌려보낸다.

Google EmbeddingGemma 2
Google DeepMind · 글쓰기 · 이미지 · 코딩Google EmbeddingGemma 2는 7억 4000만 파라미터의 오픈 모델로, 텍스트와 코드, 이미지, 오디오, 영상 프레임을 하나의 768차원 공간에 벡터로 바꿔 스마트폰과 노트북에서 실행한다.

GitGlow
GitGlow · 코딩 · 생산성GitGlow는 내 코드와 AI 에이전트의 변경을 한 리뷰에 모으는 데스크톱 Git 클라이언트다. 배포 전에 내 기계에서 무엇이 나가는지 확인할 수 있다.