
Entry Point AI - Fine-tuning Platform for Large Language Models
Entry Point AI Inc · 코딩 · 기타
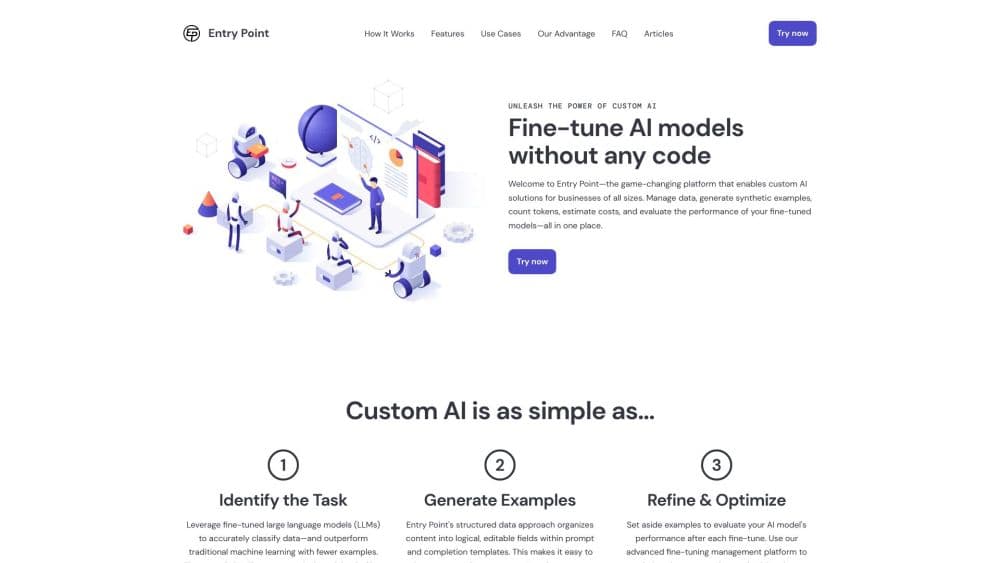
Entry Point AI는 학습 데이터를 정리하고 언어 모델을 특정 작업에 맞춰 다시 학습시키는 노코드 작업대다. 부족한 예시는 합성 데이터로 채우고, 그 데이터로 모델을 학습한다.
Entry Point AI - Fine-tuning Platform for Large Language Models 소개
About
Entry Point AI란
Entry Point AI는 범용 챗봇이 아니라 한 가지 일만 잘하는 모델이 필요한 사람을 위한 웹 플랫폼이다. 세 도구가 하나의 데이터셋을 함께 쓴다. Transforms는 스프레드시트에 AI 열을 붙여 행마다 라벨, 추출한 값, 짧은 요약을 채운다. 합성 데이터는 데이터가 모자랄 때 라벨이 붙은 예시를 더 만든다. 파인튜닝은 승인한 행만으로 모델을 학습시킨다.
출발점은 번거로운 현실이다. 이 작업은 대개 엔지니어 몫으로 넘어간다. JSONL을 만들고, 제공사 API를 연결하고, 어떤 하이퍼파라미터가 중요한지 감으로 찾는 데 며칠이 걸린다. Entry Point는 같은 단계를 브라우저로 옮기고 템플릿과 비용 추정을 붙인다. 제공사 계정도 직접 연결하므로 추론 비용은 OpenAI, Anthropic, Google AI, Groq에 그대로 청구된다. 학습용 파일을 직접 건드리지 않고 OpenAI 모델과 다른 회사 모델을 한 화면에서 조정할 수 있다.
제약은 요금 구조에 있다. 행 수 한도는 작업 공간의 모든 프로젝트가 나눠 쓰고, 제공사 사용료는 구독과 별도로 청구된다. 데이터가 적으면 부담이 작다. 운영 규모로 커지면 Pro 플랜이나 별도 협의가 필요한 Enterprise로 옮겨가게 된다.
시작하는 방법
- app.entrypointai.com에서 계정을 만든다. 가입 과정에 카드 정보는 필요 없고 무료 한도로 300행까지 시험할 수 있다.
- 자기 API 키로 제공사를 연결하고 프롬프트와 학습을 맡을 모델을 고른다.
- CSV로 데이터셋을 가져오거나, 열마다 변수를 쓰는 템플릿으로 프롬프트와 응답을 편집기에 작성한다.
- 변환을 실행해 표를 채우거나, 모든 라벨에 예시가 충분해질 때까지 합성 행을 생성한다.
- 정확 일치나 채점 프롬프트로 품질을 확인하고 학습을 시작한 뒤, 자기 API의 주소를 그 모델로 바꾼다.
제품 정보
Entry Point AI - Fine-tuning Platform for Large Language Models의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- 머신러닝 전담 인력이 없는 제품팀
- 데이터와 운영 분석 담당자
- 예산이 빠듯한 1인 창업자
작업
- 문의 분류와 게시물 관리
- 구조화 데이터 추출
- 프롬프트를 모델로 바꾸기
활용 상황
- 수십 개 예시로 데이터셋을 시작
- 제공사를 정하기 전에 비교
- 검토용 데모 내놓기
주요 기능
행마다 돌아가는 Transforms
변환이란 데이터셋의 각 행에서 실행되는 프롬프트다. 열을 변수로 참조하고 몇 행에서 결과를 본 뒤 표 전체로 넓힌다. 라벨링, 분류, 항목 추출, 정보 보강을 모두 처리하고, 프롬프트나 학습 데이터가 바뀌어도 다시 돌리는 비용이 적다.
합성 데이터 생성
어떤 라벨에 예시가 90개뿐인데 400개가 필요하면 Entry Point가 실제 행에서 더 만든다. 각 배치는 평범한 문장으로 적은 부족분을 겨냥하고, 후보에는 출처가 붙는다. 합성 행과 실제 행은 끝까지 구분된다. 손으로 라벨 작업을 해 본 사람은 마지막 몇백 개가 얼마나 고된지 안다.
여러 제공사에서의 파인튜닝
학습 작업은 OpenAI, Anthropic, Google AI, Groq로 한 화면에서 보낼 수 있다. 키는 자기 것을 쓰므로 각 회사가 직접 청구하고 중간에 붙는 마진은 없다. 제공사를 바꾸는 일은 드롭다운에서 고르는 것으로 끝나고, 프로젝트를 다시 쓸 필요가 없다.
템플릿과 JSONL 편집기
템플릿 엔진으로 각 학습 예시의 모양을 정한다. 시스템 메시지, 사용자 발화, 기대 응답이다. 파인튜닝에서는 데이터 구조가 생각보다 결과를 크게 좌우한다. 여기서는 몇 분 만에 다른 구조를 시험할 수 있다.
품질 검증과 놀이터
학습에 돈을 쓰기 전에 알려진 정답과의 정확 일치로 프롬프트를 채점하거나, 채점 프롬프트로 주관적인 출력을 평가한다. 놀이터에서는 기본 모델과 후보 모델을 나란히 비교한다. 토큰 수와 비용 추정치는 작업을 시작하기 전에 표시된다.
한 번의 클릭으로 모델 공유
학습이 끝난 모델은 클릭 한 번으로 공유 가능한 프런트엔드에 배포된다. 시험한 사람의 응답이 모두 저장되므로 실패한 사례가 다음 학습에 쓸 행이 된다.
장단점
장점
- 세 도구가 하나의 데이터셋을 공유한다. 변환, 합성 예시, 학습이 같은 순환 안에서 움직인다.
- 자기 키를 쓰는 요금제라 비용이 투명하다. 할증된 크레딧이 아니라 제공사의 정가를 낸다.
- 템플릿 편집기에서 하이퍼파라미터를 다룰 수 있다. 코드를 열지 않고 값을 조정하고 변경 내역을 남긴다.
- 합성 데이터가 빈 라벨을 메우고 행마다 출처를 붙인다. 실제 데이터와 섞인 데이터셋도 추적이 가능하다.
단점
- 제공사 사용료가 구독 위에 더해진다. 학습을 한 번 돌리면 월 요금제가 주는 인상보다 훨씬 비쌀 수 있다.
- 행 한도는 모든 프로젝트가 함께 쓴다. 작은 실험을 여러 개 돌리면 프로젝트별 한도보다 빨리 소진된다.
- 독립 평가 자료가 드물고, 회사가 출시일이나 모델 품질 수치를 공개하지 않는다.
- 채팅과 에이전트 구성은 범위 밖이다. 분류, 추출, 특정 작업용 생성에 집중한 제품이다.
자주 묻는 질문
언어 모델이 한 가지 일을 제대로 하게 만들 때 쓴다. 직접 행에 라벨을 붙이고, 부족한 부분을 합성 예시로 채운 뒤, 그 데이터로 모델을 파인튜닝하면 대량 처리에서도 출력이 흔들리지 않는다.
관련 콘텐츠
Entry Point AI - Fine-tuning Platform for Large Language Models와 관련된 도구, 스킬, 아티클을 살펴보세요.
Entry Point AI - Fine-tuning Platform for Large Language Models 대안
Velozity
Velozity Labs Inc · 코딩 · 생산성 · 비즈니스Velozity는 팀이 AI 에이전트와 대화를 함께 쓰고, 회의를 작업으로 바꾸며, 전용 클라우드 컴퓨터에서 움직이는 AI 팀원에게 일을 맡기는 AI 워크스페이스다.
Brnch
Vigilbase · 코딩Brnch는 사람과 코딩 에이전트가 같은 저장소를 쓰는 팀을 위한 Git 호스팅이다. 머지마다 누가 쓰고 누가 승인하고 무엇을 검증했는지 기록한 서명 영수증을 남긴다.
ruOS
Cognitum One · 코딩 · 생산성ruOS는 브라우저에서 열리는 Linux 데스크톱이다. AI 에이전트 팀이 조사와 글쓰기, 코드 실행을 맡고 프로젝트 기억을 유지하며, ChatGPT나 Claude가 MCP로 이 기계를 직접 조작할 수 있다.