
extract by Firecrawl
Firecrawl · 코딩
extract by Firecrawl은 어떤 URL이나 도메인 전체를 구조화 JSON으로 바꾸는 Firecrawl API 엔드포인트다. 링크와 프롬프트 또는 스키마를 주면 원하는 필드를 돌려준다.
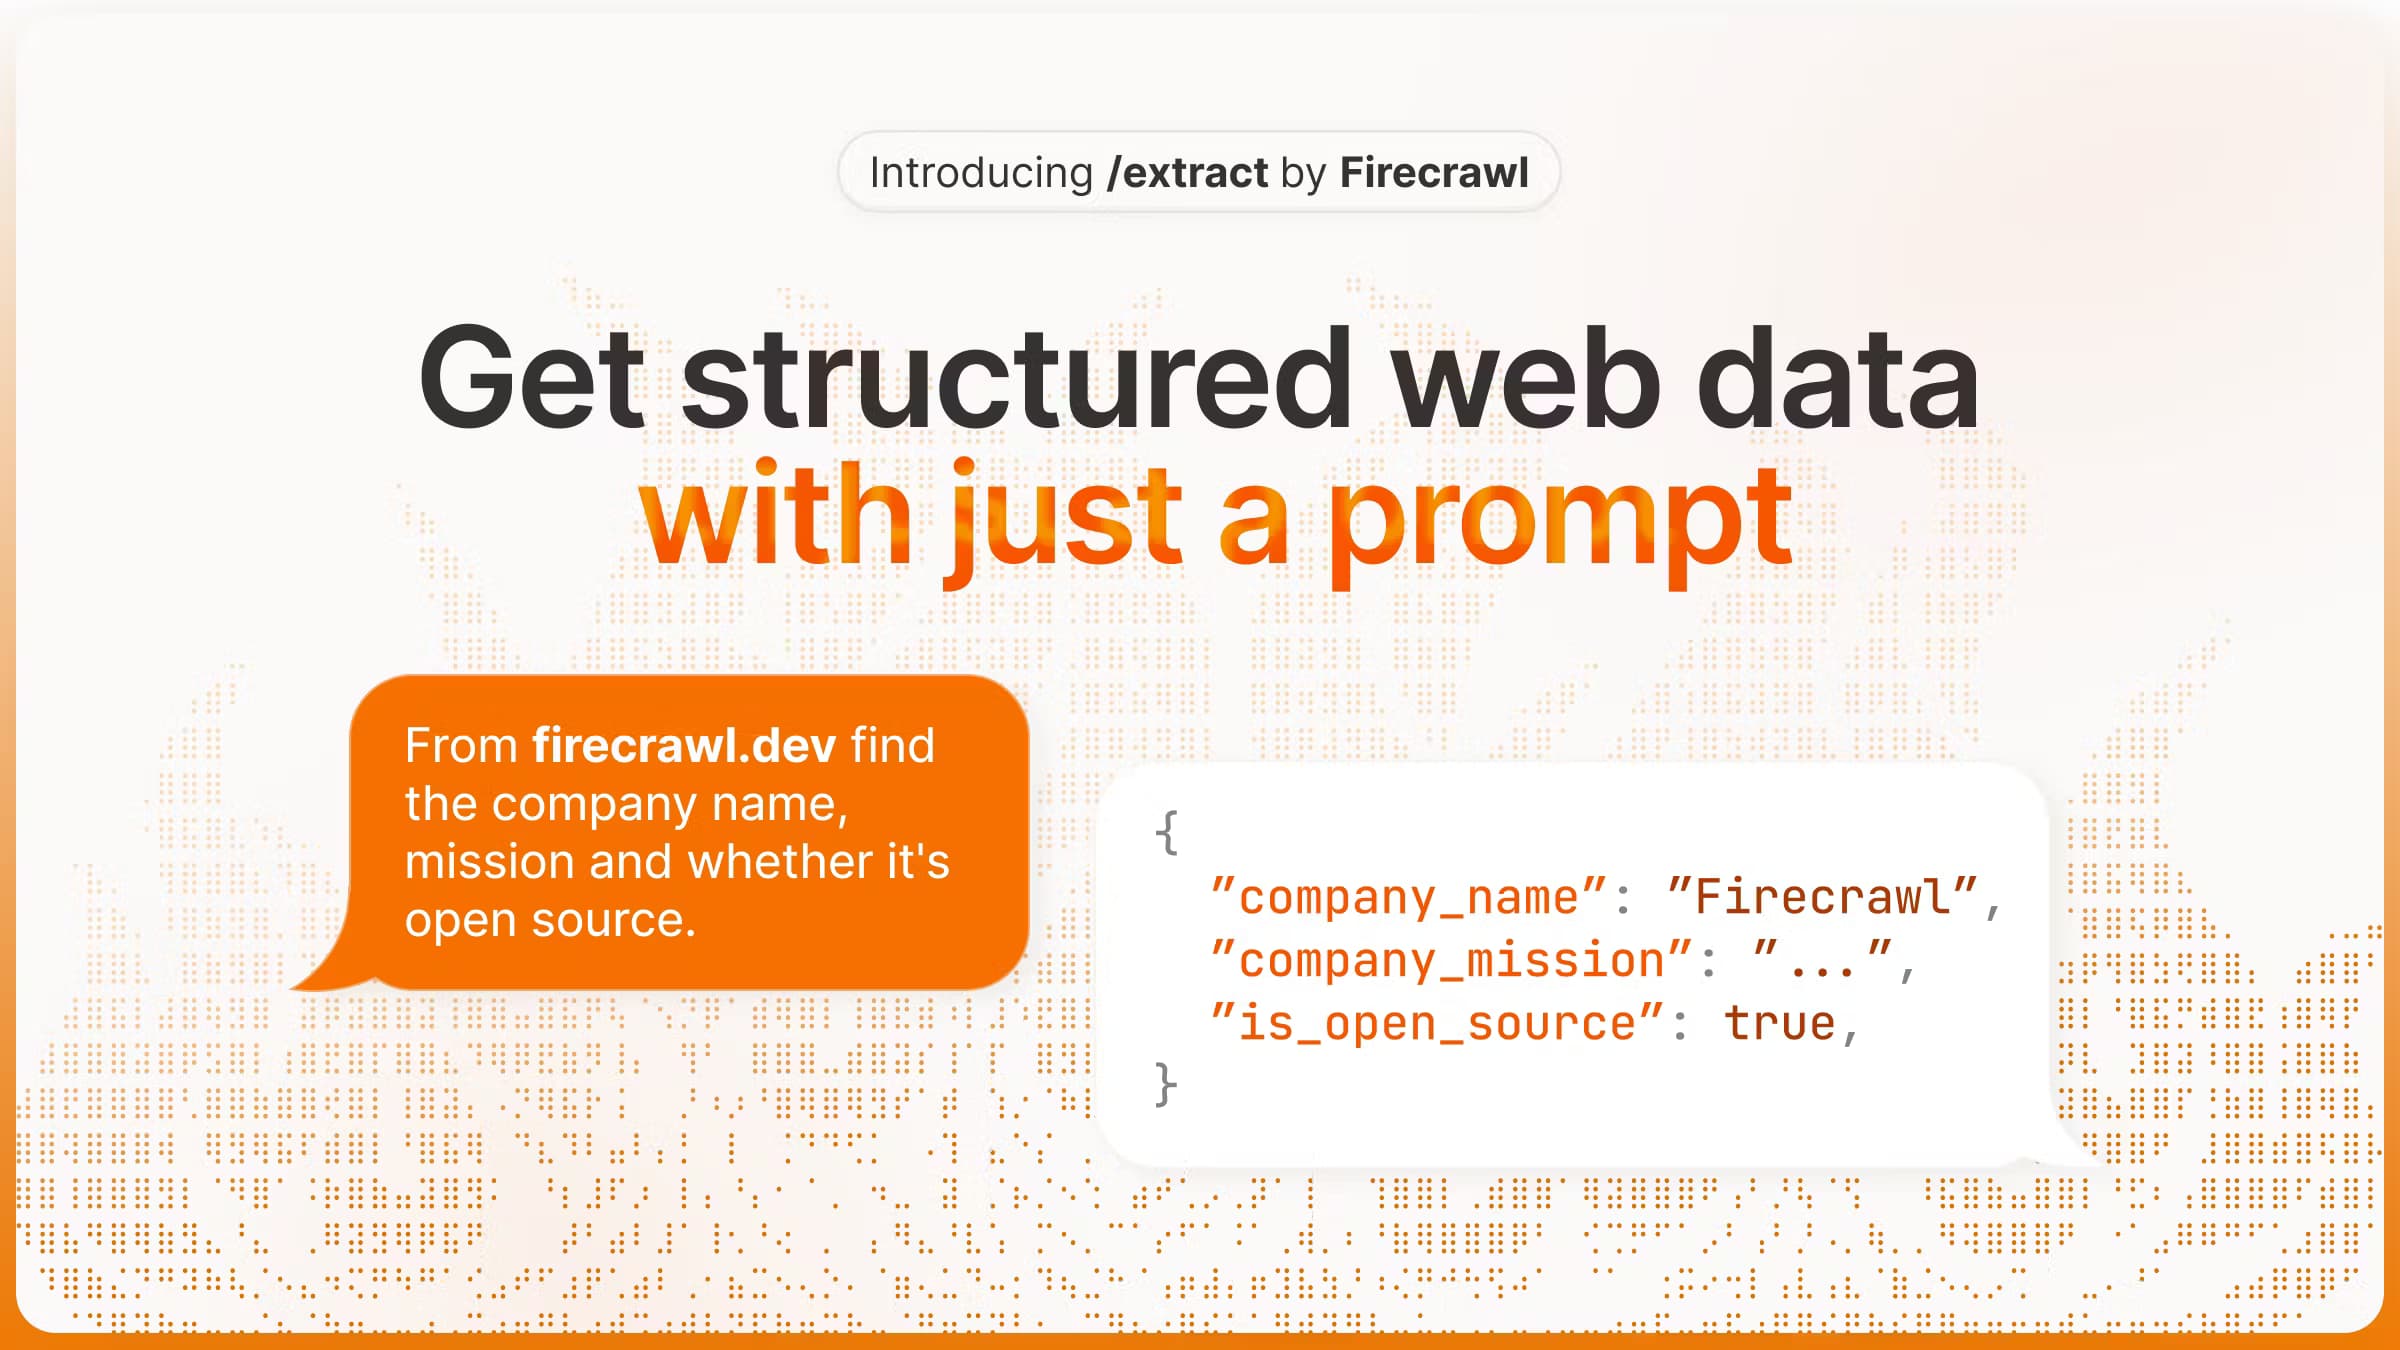
extract by Firecrawl 소개
What Is extract by Firecrawl
extract by Firecrawl은 AI 앱을 위한 웹 데이터 API인 Firecrawl의 /extract 엔드포인트다. 지정한 페이지를 스크래핑한 뒤 언어 모델로 특정 필드를 JSON으로 뽑아낸다. 사이트마다 셀렉터를 직접 쓰는 대신, 원하는 데이터를 말로 설명하거나 JSON 스키마를 넘기면 정리된 값을 받는다.
이 엔드포인트는 스크래핑의 까다로운 부분을 처리한다. 자바스크립트가 많은 페이지, 봇 차단, 사이트마다 다른 레이아웃이다. 페이지 하나, 목록, 또는 example.com/* 같은 와일드카드로 도메인 전체를 겨냥할 수 있고, Firecrawl은 찾은 페이지를 크롤한 뒤 추출한다. 반복해서 쓰는 레코드나 가격, 기업 정보를 데이터베이스나 후속 작업으로 바로 흘려보내야 하는 팀에 맞다.
사용법을 정하는 제약은 두 가지다. extract는 비동기 작업으로 돌아가므로 URL을 보내고 작업 ID로 결과를 조회하며, 즉시 응답은 받지 못한다. 또 Firecrawl은 새 작업을 후속 도구인 /agent로 유도한다. 그쪽은 URL을 스스로 찾는다. extract는 여전히 동작하지만 예전 경로다.
Getting Started
- firecrawl.dev에 가입하고 대시보드에서 API 키를 복사한다
- SDK를 설치하고(pip install firecrawl-py 또는 npm install firecrawl) 키로 클라이언트를 초기화한다
- extract를 호출한다. URL 목록, 필드를 설명하는 프롬프트, 고정된 형태가 필요하면 JSON 스키마를 넘긴다
- 돌려받은 데이터를 읽는다. 긴 실행에 start 메서드를 썼다면 작업 ID를 조회한다
제품 정보
extract by Firecrawl의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- AI 앱을 만드는 개발자
- 데이터와 분석 팀
- 시장을 조사하는 창업자
- 자동화를 짜는 사람
작업
- 여러 페이지에서 레코드 추출하기
- 어수선한 페이지를 JSON으로 바꾸기
- 가격과 재고 감시하기
- RAG용 지식 베이스 구축하기
- 여러 소스의 데이터 맞추기
활용 상황
- 조사 팀이 매주 경쟁사 가격을 추적한다
- 개발자가 AI 어시스턴트에 최신 웹 사실을 먹인다
- 창업자가 처음으로 시장을 훑는다
- 운영 팀이 디렉터리를 최신으로 유지한다
- 데이터 엔지니어가 흩어진 소스를 정리한다
주요 기능
프롬프트 또는 스키마로 구조화 데이터 추출
extract는 두 가지로 쓴다. 원하는 데이터를 자연어 프롬프트로 쓰면 모델이 알맞은 형태를 고른다. JSON 스키마를 넘기면 정의한 대로의 필드와 타입으로 레코드가 돌아온다. 데이터베이스용으로 안정된 형태가 필요한 팀은 스키마를, 낯선 사이트를 탐색하는 사람은 프롬프트로 시작해 나중에 다듬는다.
와일드카드로 도메인 전체 추출
extract는 페이지 하나, 짧은 목록, 사이트 전체 어디에나 겨눌 수 있다. example.com/* 같은 와일드카드 URL을 주면 Firecrawl이 도메인을 크롤해 찾은 페이지를 모두 읽은 뒤 필드를 추출한다. 사이트 전체 탐색이 호출 한 번으로 끝나고, URL 목록을 직접 짤 필요가 없다. 도메인 전체 모드는 실험적이라고 표시되어 있어 결과를 확인하는 편이 좋다.
웹 검색으로 보강
웹 검색 옵션을 켜면 추출이 넘겨준 URL 밖으로 나간다. Firecrawl이 관련 페이지를 따라가 빠진 맥락을 채우므로, 페이지 하나에 필요한 정보가 다 없을 때 도움이 된다. 공식 예시는 상품 페이지 하나에서 출발해 검색으로 그물을 넓혀 블랙박스의 가격과 기능, 후기를 끌어낸다.
비동기 작업과 상태 확인
extract는 호출을 막지 않고 작업으로 돈다. 요청을 보내면 작업 ID가 돌아오고, status 엔드포인트가 completed를 보고할 때까지 조회한다. 상태는 completed, processing, failed, cancelled 네 가지라 큐나 백그라운드 워커에 붙일 수 있다. 작업 결과는 끝난 뒤 24시간 동안 API에서 가져올 수 있다.
Python과 Node 공식 SDK
Firecrawl은 Python과 Node SDK를 내놓아 HTTP 호출을 직접 쓰지 않아도 된다. Python 클라이언트는 Pydantic 모델을 스키마로, Node 클라이언트는 Zod 객체를 받아 타입이 붙고 검증된 출력을 준다. 둘 다 작업 ID를 곧바로 주는 start 메서드와, 작업이 끝나면 결과를 가져오는 status 메서드를 갖췄다.
엔드포인트 간 공유되는 크레딧 과금
Firecrawl 요금제는 이제 extract도 다른 엔드포인트와 같은 크레딧으로 과금한다. extract에서는 1 크레딧이 15 토큰이고, 기본 scrape는 페이지당 1 크레딧이다. 크레딧은 모든 엔드포인트에서 공유되어 검색 결과도 크롤한 페이지도 같은 잔액에서 나간다. 추출과 크롤을 섞은 작업에서도 비용을 가늠하기 쉬워진다.
Agent로 가는 문서화된 이전 경로
Firecrawl은 extract를 예전 도구로 표시하고 새 작업을 후속 도구인 /agent로 보낸다. Agent는 프롬프트와 스키마 선택지를 유지하면서 URL 필수 조건을 없애 스스로 검색하고 탐색한다. "이 데이터를 웹 어딘가에서 찾고 싶다"면 Agent가 길이다. URL을 이미 안다면 extract가 여전히 제 몫을 한다.
장단점
장점
- 프롬프트나 JSON 스키마 출력 덕에 사이트마다 셀렉터를 손으로 쓰지 않아도 된다
- 와일드카드 URL이면 작업 하나로 도메인 전체를 덮어 페이지 목록을 직접 짜지 않아도 된다
- 공식 Python과 Node SDK가 Pydantic과 Zod를 지원해 타입이 붙고 검증된 결과를 준다
- 크레딧 과금이 엔드포인트 간 공유되어 여러 작업을 섞은 때도 비용이 읽힌다
- 매월 1,000 크레딧 무료 요금제가 있어 카드 없이 가볍게 시험할 수 있다
단점
- 추출이 비동기라 즉시 응답이 필요한 요청에는 끼워 넣을 수 없다
- Firecrawl이 신규 사용자를 Agent로 유도하므로 extract는 예전 경로이고 새 도구에 뒤진다
- 와일드카드 도메인 전체 추출은 실험적이라 넓은 크롤은 결과 확인이 필요하다
- 작업 결과가 24시간 뒤 API에서 사라져 장기 보관은 직접 해야 한다
- 403이나 404 같은 오류 상태를 돌려주는 페이지도 1 크레딧이 나간다
자주 묻는 질문
웹 데이터 API인 Firecrawl의 /extract 엔드포인트다. URL과 프롬프트 또는 JSON 스키마를 주면 언어 모델이 원하는 필드를 구조화 JSON으로 돌려준다. 레이아웃이 제각각인 페이지에서 반복해서 쓸 레코드를 뽑아내는 데 맞다.
관련 콘텐츠
extract by Firecrawl와 관련된 도구, 스킬, 아티클을 살펴보세요.
extract by Firecrawl 대안

Base Code
Base44 (Wix) · 코딩 · 생산성Base Code는 Base44가 만든 공유 클라우드 개발 환경이다. 팀은 기존 GitHub 저장소에 대한 변경을 채팅으로 설명하고, 미리보기로 확인한 뒤 풀 리퀘스트로 돌려보낸다.

Google EmbeddingGemma 2
Google DeepMind · 글쓰기 · 이미지 · 코딩Google EmbeddingGemma 2는 7억 4000만 파라미터의 오픈 모델로, 텍스트와 코드, 이미지, 오디오, 영상 프레임을 하나의 768차원 공간에 벡터로 바꿔 스마트폰과 노트북에서 실행한다.

GitGlow
GitGlow · 코딩 · 생산성GitGlow는 내 코드와 AI 에이전트의 변경을 한 리뷰에 모으는 데스크톱 Git 클라이언트다. 배포 전에 내 기계에서 무엇이 나가는지 확인할 수 있다.