
General Compute
General Compute · 코딩
General Compute는 단 하나의 임무를 위해 만들어진 AI 추론 클라우드다. GPU만 쓰는 공급자보다 빠르게 대규모 언어 모델을 제공한다. SambaNova, Cerebras, Positron, d-Matrix의 전용 디코딩 실리콘에서 OpenAI 호환 엔드포인트를 돌리고, 프리필은 NVIDIA B300 랙에 남긴다. 신규 계정에는 100달러 무료 크레딧이 주어지고, 예약 용량이나 사설 가중치가 필요한 팀은 전용 계약을 맺을 수 있다. 가격도 투명하다. 추론 API 가격은 백만 토큰당으로 청구되며, 셀프서비스 등급에는 월별 좌석 요금이 없다. 숨은 플랫폼 비용도 없다.
General Compute 소개
General Compute란 무엇인가
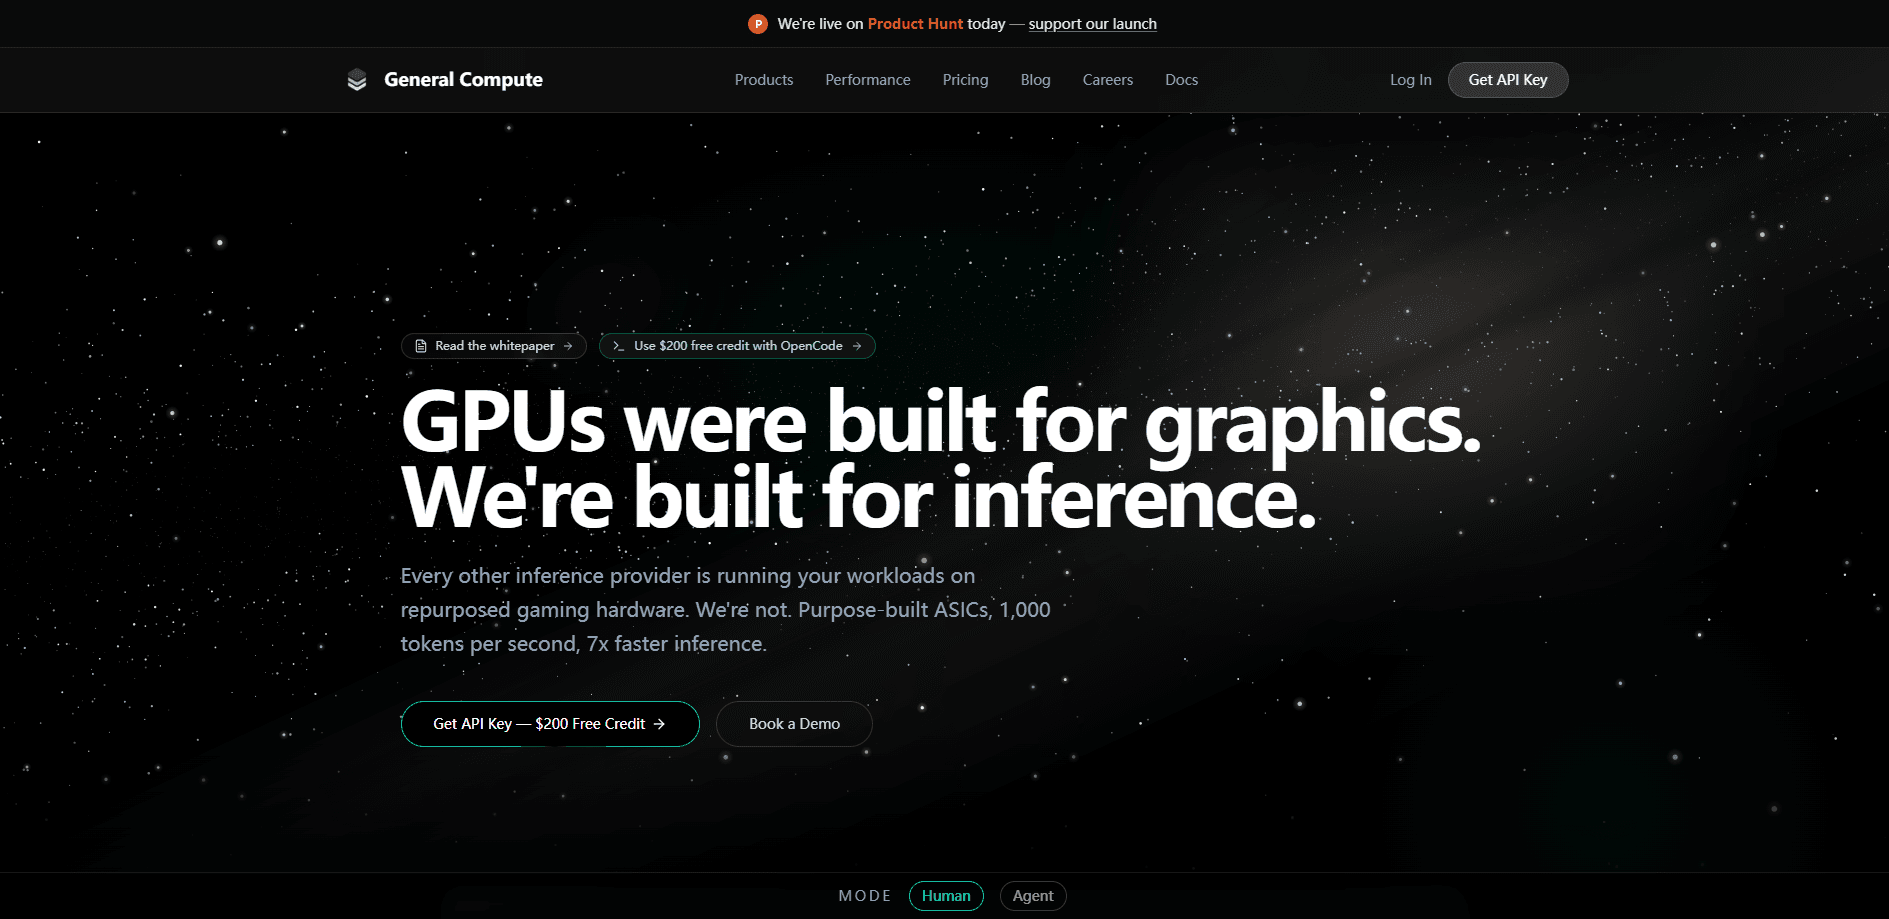
General Compute는 LLM 워크로드를 두 종류의 하드웨어로 나눠 처리하는 추론 공급자다. 계산이 몰리는 첫 단계인 프리필은 GPU에서 돈다. 토큰을 하나씩 생성하는 메모리 병목 구간인 디코딩은 이를 위해 만든 ASIC 가속기에서 돈다. 주장은 단순하다. 에이전트 실행을 느리게 만드는 것은 디코딩 속도이며, GPU 연산을 더 얹는다고 해결되지 않는다.
제품은 REST API로 제공되며 기존 OpenAI SDK를 그대로 향하게 할 수 있다. 베이스 URL과 API 키를 바꾸면 도구 호출, JSON 모드, 스트리밍이 그대로 작동한다. 사용 가능한 모델로는 MiniMax M2.7, DeepSeek V3.2, DeepSeek V3.1, GPT-OSS 120B가 있다.
가장 큰 한계는 성숙도다. General Compute는 젊은 공급자이며, 대표 속도 수치의 출처는 자체 벤치마크다. 모든 리전과 컴플라이언스 인증을 갖춘 10년 된 클라우드가 필요하다면 이건 아니다. 빠른 토큰 생성과 간단한 이전 경로를 원한다면 살펴볼 만하다.
시작하기
- app.generalcompute.com에서 계정을 만들고 100달러 무료 크레딧을 받는다.
- 대시보드에서 API 키를 생성하고 베이스 URL을 복사한다.
- import와 키를 바꿔 OpenAI SDK를 General Compute 엔드포인트로 향하게 한다.
- 요청에서
minimax-m2.7이나deepseek-v3.2같은 모델 ID를 고른다. - 첫 호출을 실행한 뒤 종량제 요금제에서 사용량을 늘린다.
제품 정보
General Compute의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- AI 개발자
- 에이전트 개발자
작업
- 지연에 민감한 채팅
- 구조화된 에이전트 워크플로
- 사설 모델 호스팅
활용 상황
- 새 AI 기능 프로토타이핑
- 대규모 프로덕션 추론
주요 기능
전용 설계 디코딩 실리콘
대부분의 추론 클라우드는 모든 것을 GPU에서 돌린다. General Compute는 디코딩 단계를 이를 위해 설계된 칩으로 보낸다. 운영 중인 SambaNova SN50과 가장 빠른 등급을 위한 Cerebras의 웨이퍼 스케일 하드웨어가 포함된다. 회사에 따르면 이 방식은 수조 파라미터 모델에서 사용자당 초당 1,000~2,000 토큰을 제공하며, 230B MoE를 돌리는 B300 랙의 초당 320 토큰 미만과 대비된다. 이 격차가 제품이 존재하는 이유 전부다. 큰 차이다. 디코딩은 메모리 병목 구간이라 GPU를 쌓아도 거의 움직이지 않는다.
OpenAI 호환 API
API는 OpenAI와 같은 엔드포인트, 파라미터, 스트리밍 의미론을 쓴다. 오케스트레이터와 도구 정의, 재시도 로직을 그대로 유지한다. 대부분의 코드베이스에서 이전은 한 줄 변경이다. 그만큼 단순하다. 이미 OpenAI SDK에 깊이 들어간 팀에게 이는 주말 작업과 분기 하나를 다시 짜는 일의 차이다.
추론 모델을 포함한 다양한 모델
카탈로그는 범용 모델과 추론 모델을 아우른다. MiniMax M2.7은 192k 컨텍스트 창으로 채팅과 생성을 담당한다. DeepSeek V3.2와 V3.1은 수학, 코드, 분석을 위한 내장 사고 연쇄 추론을 더한다. GPT-OSS 120B는 오픈 가중치 팬을 위한 목록을 마무리한다.
자체 모델 가져오기
사설 가중치를 배포할 수 있다. LoRA든 GGUF 파일이든 전체 미세 조정이든 상관없다. General Compute는 체크포인트를 컨테이너로 만들고, us-west-2에서 가속기를 연결하고, 사설 모델 ID 뒤에 노출한다. 그러면 자체 모델이 다른 모델 파라미터와 똑같이 동작하며 스트리밍과 도구 호출도 포함된다. 독점 가중치를 가진 팀에게 이 모델 호스팅 옵션은 소비자용 API 너머를 볼 이유가 된다.
root 접근이 되는 전용 랙
셀프서비스 API를 넘어, SLA가 있는 단일 계약으로 전용 프리필과 디코딩 용량을 맺을 수 있다. root 접근이 되는 베어메탈, 세 공급자에 걸친 가격 보호 쿼터, 그리고 계약 기간 내내 프리필과 디코딩을 단일 서비스로 조율하는 체계를 얻는다.
다중 공급자 용량
쿼터는 SambaNova, Cerebras, Positron, d-Matrix에 걸쳐 분산되므로 한 칩 공급자에 묶이지 않는다. 예약한 디코딩 용량은 트래픽이 몰릴 때 짝을 이룬 B300 플릿으로 버스트해, 들쭉날쭉한 워크로드가 놀고 있는 랙을 남기지 않게 한다.
장단점
장점
- 회사 자체 벤치마크에 따르면 대형 모델에서 GPU만 쓰는 클라우드가 따라올 수 없는 디코딩 속도.
- OpenAI 호환 API 덕분에 대부분의 팀이 코드를 다시 쓰지 않고 이전한다.
- 도구 호출, JSON 모드, 추론 지원이 카탈로그 전반에서 가능하다.
- 다중 공급자 하드웨어와 100달러 무료 크레딧이 시험 비용을 낮춘다.
- 자체 모델 가져오기 지원이 LoRA, GGUF, 전체 미세 조정을 아우른다.
단점
- 대표 속도 수치는 General Compute 자체 벤치마크에서 나온 것이지 독립 검증이 아니므로, 자기 워크로드를 시험할 때까지는 공급자 주장으로 취급해야 한다.
- 프로덕션 트래픽이 현재 미국 단일 리전에서만 돈다. 다른 곳의 데이터 상주나 미국 밖 저지연이 필요하다면 중요한 문제다.
- 예약과 엔터프라이즈 등급은 맞춤 가격이라, 영업과 얘기하지 않고는 전용 용량 비용을 추정할 수 없다.
- 종량제 요금제는 최선 노력 수준의 신뢰성이며, 계약상 SLA는 엔터프라이즈에만 적용된다.
자주 묻는 질문
대규모 언어 모델을 돌리기 위한 AI 추론 클라우드이며, 특히 지연이 쌓이는 다단계 에이전트 루프처럼 디코딩이 몰리는 워크로드에 맞는다. 자체 GPU를 관리하는 대신 OpenAI 호환 API로 호출한다.
관련 콘텐츠
General Compute와 관련된 도구, 스킬, 아티클을 살펴보세요.
General Compute 대안
Forefront
Forefront · 코딩Forefront는 오픈소스 AI로 무언가를 만드는 웹 플랫폼이다. 대표적인 오픈소스 언어 모델을 자신의 데이터로 미세 조정하고, 성능을 평가하고, API로 실행하거나 내보내 직접 호스팅할 수 있다. 폐쇄형 플랫폼의 편의를 원하면서도 모델과 데이터의 소유권은 놓지 않으려는 개발자가 대상이다.

Startkit
StartKit.AI · 코딩Startkit은 AI SaaS와 AI 래퍼 제품을 만들기 위한 보일러플레이트다. 지루한 부분을 미리 연결해 둔 AI 스타트업 보일러플레이트라고 생각하면 된다. 인증, Stripe와 Lemon Squeezy 결제, 사용량 제한, 트랜잭션 이메일, 그리고 OpenAI, Anthropic, Groq, Llama와 통신하는 AI API 스타터 키트가 포함된다. 저장소를 복제하고 가격을 정한 뒤 사용자가 실제로 돈을 내는 부분에 착수하면 된다. React와 Tailwind 위의 Next.js로 만들어졌기 때문에 보일러플레이트 코드의 상당 부분이 이미 익숙하게 느껴진다.
Testim
Tricentis · 코딩Testim은 웹, 모바일, Salesforce 애플리케이션 전반에 걸쳐 엔드투엔드 테스트를 만들고 실행하는 AI 기반 테스트 자동화 플랫폼이다. 머신러닝에 기대어 인터페이스가 바뀌어도 테스트를 안정적으로 유지하므로, 팀은 깨진 셀렉터를 고치는 데 쓰는 시간을 줄인다. 오늘부터 쓸 수 있는 자동화 테스트 도구치고 나쁘지 않다. 브라우저에서 동작을 녹화해 테스트를 만들고, 더 세밀한 제어가 필요하면 JavaScript를 더한다. 바쁜 QA 팀에게 탄탄한 선택이다.