
Grably
Grably · 코딩 · 비즈니스
Grably는 사진과 영상, 음성을 공유한 사람에게 토큰을 주고, AI 기업에는 동의를 받은 데이터셋을 라이선스하는 AI 학습 데이터 마켓플레이스다.
Grably 소개
About
Grably란
Grably는 양쪽을 잇는 데이터 시장이다. 한쪽에서는 일반 사용자가 일상 소재를 올린다. 휴대폰 사진, 짧은 영상, 음성 녹음, 채팅 기록 같은 것들이다. 다른 쪽에서는 AI 연구소와 개발팀이 이를 학습 데이터로 산다. 보상은 Grably Tokens로 지급되고 USDT로 바꿀 수 있다.
내세우는 차별점은 동의다. 파일은 공유에 동의한 사람에게서 모으고, 모든 제출물은 검수를 거쳐야 데이터셋에 들어간다고 회사는 설명한다. 공개 웹에서 이미지와 음성을 긁어오고 싶지 않은 팀에게는 이 점이 중요하다.
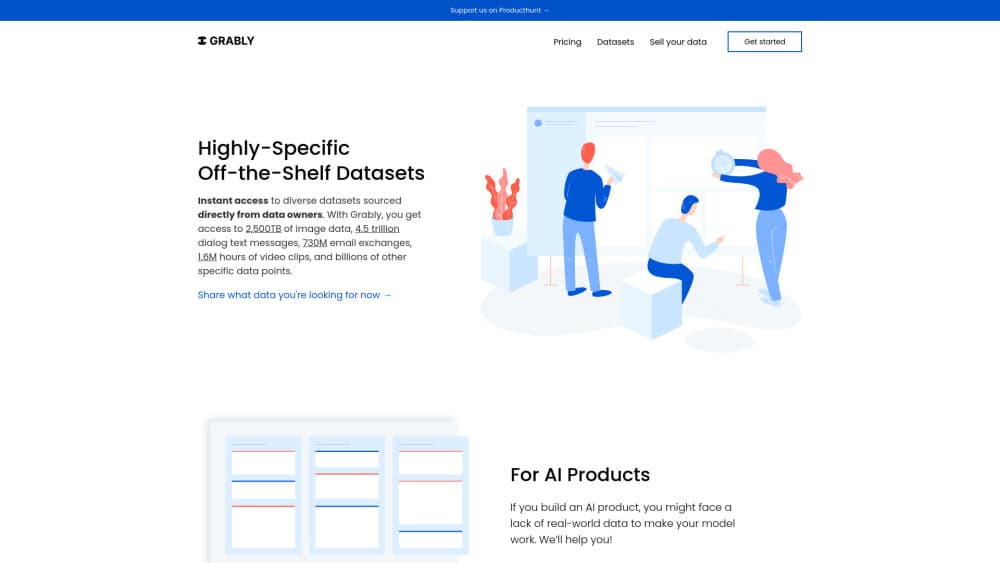
자체적으로 정리한 모음도 판다. 5억 명이 넘는 참여자와 100페타바이트 이상의 소재로 만든 17개 독점 데이터셋이 있고, 100개 이상 언어의 대화 메시지와 라벨이 붙은 스포츠 영상 수천 시간이 포함된다고 한다. 회사 주장이므로 우리가 따로 확인하지는 못했다.
한계도 금방 드러난다. 셀프서비스 도구가 아니다. 데이터를 사는 쪽은 영업과 협의해야 하고, 제공자는 공개 단가가 아니라 승인된 작업 단위로 보상을 받는다. 데이터 공유로 돈 벌기를 원하는 사람에게 진입 장벽은 낮은 편이다.
시작하는 방법
- 텔레그램에서 Grably 봇을 열거나 안드로이드용 Grably 앱을 설치하고 계정을 만든다.
- 사진 묶음 업로드나 음성 문장 녹음처럼 작업을 고른다.
- 공유 조건을 읽고 무엇을 넘기는지 확인한다.
- 파일을 보내고 검수 결과를 기다린다.
- 잔액에 쌓인 Grably Tokens를 USDT로 바꾼다.
제품 정보
Grably의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- 사진이 넘치는 사람
- 음성 제공자
- 라이선스 데이터가 필요한 AI 팀
작업
- AI 기업에 데이터 판매
- 다국어 대화 코퍼스 확보
- 음성과 영상 데이터셋 제작
- 공유 전 노출 범위 확인
활용 상황
- 연구소가 일상적인 인간 장면을 필요로 할 때
- 학생이 이미 가진 파일로 용돈을 벌 때
- 스타트업이 공개 웹을 긁을 수 없을 때
주요 기능
제공에 값을 매기는 구조
Grably는 업로드를 유료 작업으로 바꾼다. 작업을 고르고 요청된 파일을 보내면 검수를 통과한 뒤 Grably Tokens가 들어온다. 토큰은 USDT로 교환되므로 보상은 상품권보다 현금에 가깝다. 단가는 작업마다 달라지고, 사진 한 장이나 음성 1분당 정가는 공개되지 않는다.
넘기기 전 검수
제출물은 구매자에게 도달하기 전에 반드시 확인을 거친다. 데이터셋 품질을 지키고 쓸모없는 소재가 학습에 섞이지 않게 하려는 장치다. 제공자 입장에서는 반려된 묶음은 보상이 없다는 뜻이므로 안내를 그대로 따르는 편이 낫다.
텔레그램 미니앱과 안드로이드 앱
작업 대부분은 텔레그램 안에서 끝난다. 봇이 작업과 업로드, 잔액을 관리한다. 메신저를 피하고 싶은 사람을 위해 안드로이드 전용 Grably 앱도 있다. 둘 다 PC가 필요 없어 휴대폰에서 생기는 데이터라는 성격과 맞는다.
다국어 대화 데이터셋
채팅 모음에는 100개 이상 언어의 연속 메시지 수십억 건이 반응과 답장, 첨부 미디어까지 함께 담긴다. 구매자는 대화 맥락과 멀티모달 정렬에 쓴다. 가치는 흐름에 있다. 문장 하나의 모양이 아니라 사람들이 실제로 어떻게 반응하는지가 남는다.
영상과 스포츠 소재
Grably는 3억 개가 넘는 클립, 9,000년 분량의 영상을 내세운다. 컴퓨터 사용, 게임, DIY 같은 범주로 나뉜다. 스포츠는 따로 묶여 축구의 경우 프레임 단위 라벨이 붙는다. 브라우저 에이전트나 동작 모델을 학습하는 팀은 직접 찍고 주석을 다는 비용이 커서 이런 영상을 반긴다.
공유 범위를 직접 정하는 통제
무엇을 넘길지는 본인이 고르고, 각 작업은 명시적 허락을 전제로 짜인다. AI 학습 데이터 마켓플레이스와 웹 스크레이퍼의 차이가 여기에 있다. 나중에 파일을 지우고 싶으면 자동 대시보드가 아니라 회사에 직접 연락한다.
장단점
장점
- 이미 가진 데이터로 특별한 장비 없이 돈을 벌 수 있다.
- 검수가 부적합한 파일을 걸러 구매자가 지불하는 품질을 지킨다.
- 텔레그램 봇 덕분에 휴대폰에서 몇 번의 터치로 보낼 수 있다.
- 언어와 영상 모음이 본격적인 모델 학습에 쓸 만한 규모를 갖췄다.
- 제공은 무료라 해지할 구독이 없다.
단점
- 보상이 작업 승인에 달려 있고 단가도 공개되지 않아 수입을 예측하기 어렵다.
- 환전이 USDT를 거쳐 계좌 이체만 원하는 사람에게는 절차가 늘어난다.
- 구매자는 직접 가입해 내려받을 수 없고 라이선스는 영업 협의로 진행된다.
- 공개 API 문서가 없어 자사 파이프라인에 데이터를 넣으려는 팀은 막힌다.
자주 묻는 질문
AI 기업에 데이터를 팔려는 사람과 동의 기록이 있는 학습 데이터가 필요한 팀을 연결한다. 한쪽은 업로드 작업을 수행하고, 다른 쪽은 그 결과에 라이선스를 얻는다.
관련 콘텐츠
Grably와 관련된 도구, 스킬, 아티클을 살펴보세요.
Grably 대안

Base Code
Base44 (Wix) · 코딩 · 생산성Base Code는 Base44가 만든 공유 클라우드 개발 환경이다. 팀은 기존 GitHub 저장소에 대한 변경을 채팅으로 설명하고, 미리보기로 확인한 뒤 풀 리퀘스트로 돌려보낸다.

Google EmbeddingGemma 2
Google DeepMind · 글쓰기 · 이미지 · 코딩Google EmbeddingGemma 2는 7억 4000만 파라미터의 오픈 모델로, 텍스트와 코드, 이미지, 오디오, 영상 프레임을 하나의 768차원 공간에 벡터로 바꿔 스마트폰과 노트북에서 실행한다.

GitGlow
GitGlow · 코딩 · 생산성GitGlow는 내 코드와 AI 에이전트의 변경을 한 리뷰에 모으는 데스크톱 Git 클라이언트다. 배포 전에 내 기계에서 무엇이 나가는지 확인할 수 있다.