
Inferless
Inferless · 코딩
Inferless는 머신러닝 모델을 API 엔드포인트로 배포하는 서버리스 GPU 플랫폼이다. 콜드 스타트는 1초 미만, 과금은 초 단위다.
Inferless 소개
About
Inferless란
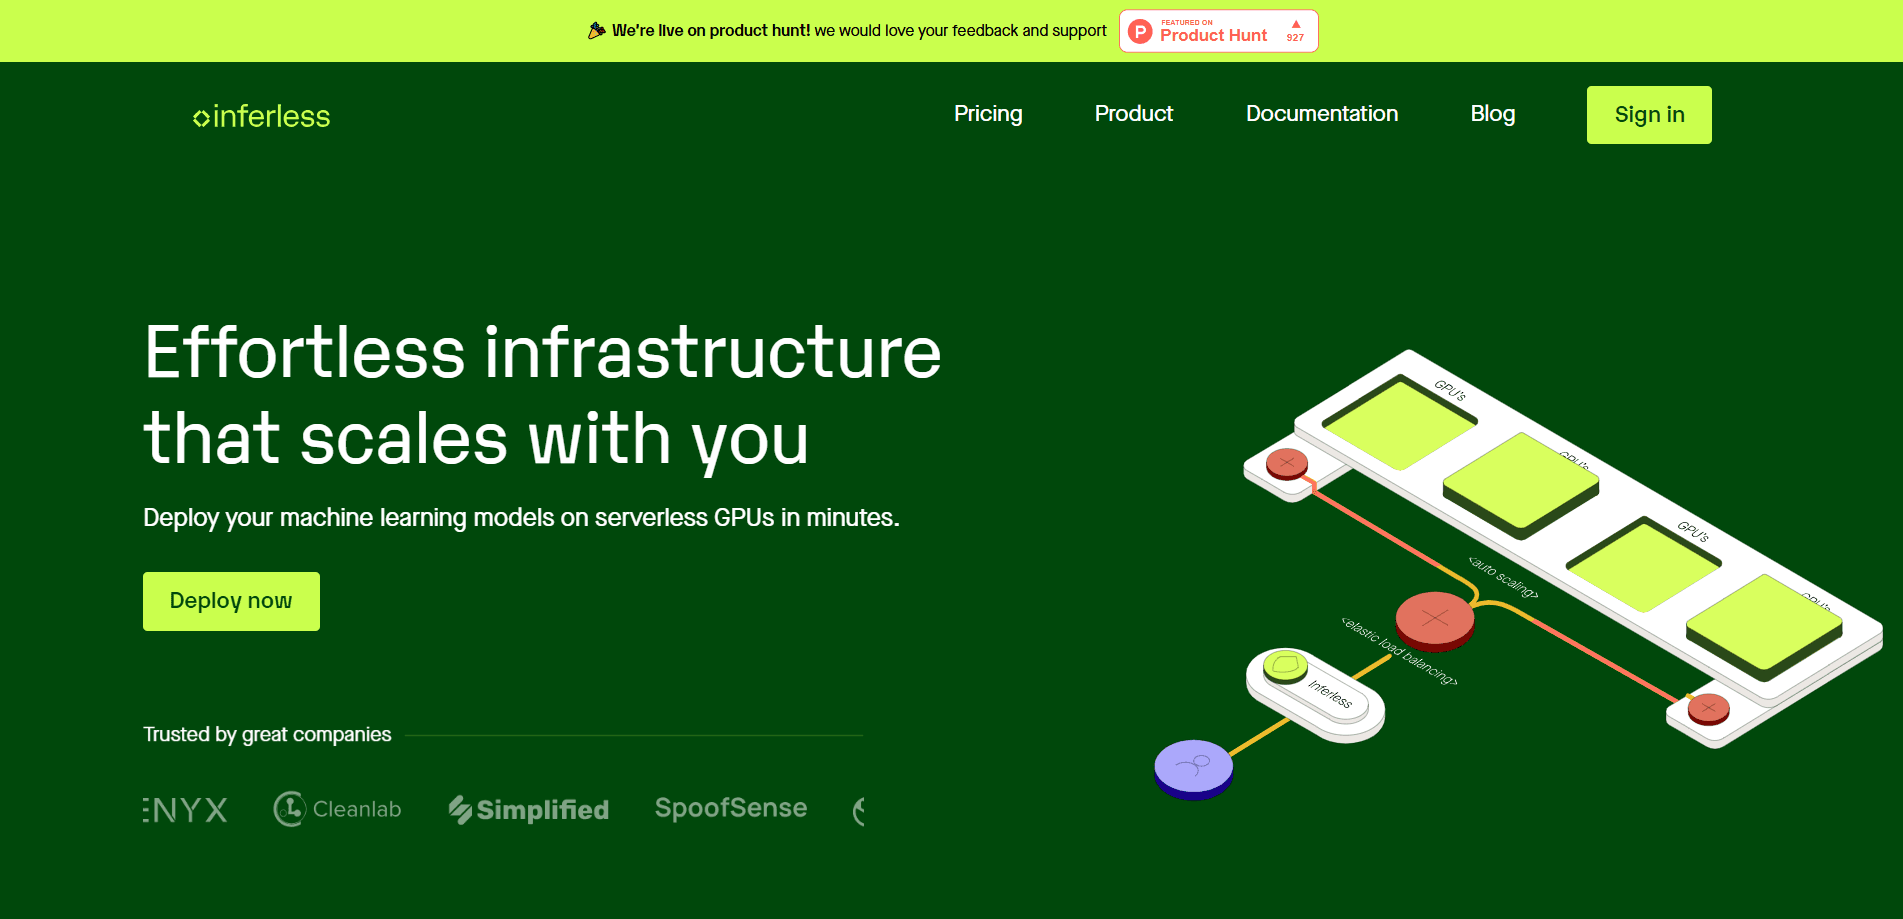
Inferless는 학습을 마친 머신러닝 모델을 GPU를 직접 관리하지 않고 동작하는 모델 엔드포인트로 바꾸는 GPU 추론 플랫폼이다. 모델만 가져오면 프로비저닝과 확장, 그 아래 인프라는 플랫폼이 맡는다. 목표는 ML 추론이고 학습은 아니다. 클러스터 구축을 건너뛰고 앱에서 호출할 수 있는 엔드포인트를 얻는 것이 핵심이다.
겨냥하는 문제는 비용과 수고다. 모델을 돌리려면 아무도 요청을 보내지 않는 시간까지 GPU를 24시간 빌려야 하는 게 보통이었다. Inferless는 초 단위로 과금하고 트래픽이 멈추면 0으로 내린다. 그래서 실제로 쓴 연산만 지불한다. 자체 오케스트레이션 엔진과 스토리지 계층으로 콜드 스타트를 낮게 유지하는데, 모델이 응답 전에 깨어나야 하는 상황에서 이게 중요하다.
한계도 현실적이다. 이건 개발자용 도구이지 노코드 앱이 아니다. 모델과 의존 패키지는 직접 제대로 묶어야 한다. 요금은 사용량 기반이라 양이 적으면 싸지만 고정 요금보다 예측하기 어렵다. 또 긴 학습처럼 추론용 서버리스보다 전용 GPU 머신이 더 맞는 작업도 있다.
시작하기
- Inferless 계정을 만들고 Hugging Face, GitHub, Docker 이미지 같은 모델 공급원을 연결한다
- 실행 환경과 패키지, GPU 종류를 간단한 YAML 파일로 설정한다. 서버 코드는 쓰지 않는다
- 모델을 배포하고 환경 구성과 엔드포인트 기동은 Inferless에 맡긴다
- 생성된 엔드포인트를 앱에서 호출하고 트래픽 몰림은 오토스케일링에 넘긴다
제품 정보
Inferless의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- 머신러닝 엔지니어
- 스타트업
- 데이터 과학자
- 앱 개발자
- 기업 팀
작업
- 자체 모델 배포
- 언어 모델 제공
- 배치 추론 작업
- 아이디어 검증
- 앱에 추론 넣기
- 모델 간 데이터 공유
활용 상황
- AI 기능을 내는 스타트업
- 모델을 검증하는 데이터 과학자
- 트래픽이 들쭉날쭉한 팀
- 데모를 만드는 개발자
- 자체 모델을 돌리는 기업
주요 기능
1초 미만 콜드 스타트
서버리스 추론에서 가장 어려운 부분은 잠든 모델이 응답하려고 깨어나는 대기 시간, 이른바 콜드 스타트다. Inferless는 자체 오케스트레이션 엔진과 고성능 라우터, 자체 스토리지 계층을 함께 묶어 여기에 맞선다. 대형 모델도 1초 미만으로 응답한다고 회사는 설명한다. 덕분에 0으로 내리는 구조가 사용자 대상 앱에서도 현실성이 있다. 채팅이나 검색 기능이 모델 로딩을 10초 기다려야 한다면 서버리스의 값어치는 사라진다.
0에서 시작하는 자동 확장
Inferless는 트래픽에 맞춰 엔드포인트를 올리고 내린다. 돌아가는 GPU가 하나도 없는 상태에서 동시에 수백 장까지 넓어진다. 자체 로드 밸런서가 요청을 나누고 적은 부담으로 용량을 늘리거나 줄인다. 예측하기 어렵게 튀는 부하에 맞는다. 최대 용량을 미리 준비할 필요도, 한산할 때 그 비용을 낼 필요도 없다.
여러 공급원에서 모델 가져오기
모델은 Hugging Face, GitHub, AWS S3, Google Cloud Storage, Docker, Inferless CLI에서 가져올 수 있고 나머지는 플랫폼이 처리한다. ML 팀이 이미 쓰는 저장소에서 클릭 한 번으로 가져오면 준비 작업이 줄어든다. 모델을 운영에 올리는 일이 파일 전송으로 시작하지 않는다. Azure 지원은 곧 제공될 예정이다.
모델과 프레임워크에 얽매이지 않음
PyTorch, TensorFlow, ONNX 모델을 돌리고 자체 Python 함수도 받는다. 이 유연성 덕분에 특정 프레임워크나 모델 형식에 묶이지 않는다. 실행 환경과 패키지는 YAML로 맞추므로 추가 라이브러리를 넣는다고 서버를 처음부터 쓸 필요가 없다.
GPU 분할 지원
작은 모델에 GPU를 통째로 빌리는 대신 여러 모델과 작업이 같은 GPU를 공유하게 한다. 자동 재분배와 노드 드레이닝도 붙는다. 분할 GPU도 쓸 수 있어 A100의 일부만 필요한 모델이 카드 전체를 지불하지 않아도 된다. 작은 모델을 많이 돌리는 팀에게 이 공유는 가능과 너무 비쌈을 가르는 기준이 되곤 한다.
모니터링과 CI/CD
Inferless에는 Prometheus 지표와 Grafana 대시보드가 있어 GPU 사용량과 다른 건강 신호를 추적한다. 새 모델 버전은 CI/CD 파이프라인으로 배포하므로 인프라를 손으로 다시 만들지 않고 업데이트를 낸다. 같은 흐름에서 바로 쓸 수 있는 API 엔드포인트가 나오고, 백엔드에도 프런트엔드에도 끼워 넣을 수 있다.
장단점
장점
- 초 단위 과금이라 트래픽이 0으로 떨어져도 놀고 있는 GPU에 돈을 내지 않는다
- 1초 미만 콜드 스타트로 0으로 내리는 구조가 실시간 앱에서도 성립한다
- Hugging Face, GitHub, S3, Google Cloud Storage에서 클릭 한 번으로 가져와 준비가 가볍다
- 프레임워크에 얽매이지 않아 PyTorch, TensorFlow, ONNX, 자체 Python이 모두 돈다
- GPU 분할 공유로 작은 모델을 많이 돌리는 비용을 낮춘다
단점
- 개발자용 도구여서 모델과 의존 패키지는 직접 묶어야 한다
- 사용량 기반 요금은 양이 적으면 싸지만 고정 요금보다 예측이 어렵다
- 긴 학습은 대상이 아니다. 플랫폼은 추론용으로 만들어졌다
- 네이티브 모바일 앱이 없어 모든 것이 웹 콘솔과 CLI를 거친다
자주 묻는 질문
Inferless는 모델 배포를 위한 서버리스 GPU 플랫폼으로, 자체 머신러닝 모델을 API 엔드포인트로 바꾼다. 모델을 가져오고 실행 환경을 설정하면 하드웨어와 확장, 콜드 스타트 조정은 Inferless가 맡는다.
관련 콘텐츠
Inferless와 관련된 도구, 스킬, 아티클을 살펴보세요.
Inferless 대안

Udon
Udon · 코딩 · 생산성Udon은 Apple Silicon Mac을 Mac 홈서버로 바꾸는 소프트웨어다. 브라우저에서 컨테이너와 파일 공유를 관리하고, 원하면 AI 시스템 관리자까지 붙일 수 있다.

offstage
offstage cloud · 코딩 · 생산성offstage는 AI 에이전트와 CI 작업에 진짜 Mac을 넘긴다. Apple Silicon 위의 새 macOS 27 계정을 API로 다루고 초 단위로 과금한다.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · 코딩 · 생산성BotBus는 AI 코딩 에이전트 원격 제어 앱이다. 스마트폰과 워치에서 명령을 승인하고, 작업을 시작하고, 결과를 확인한다.