
LlamaIndex
LlamaIndex, Inc. · 마케팅 · 기타
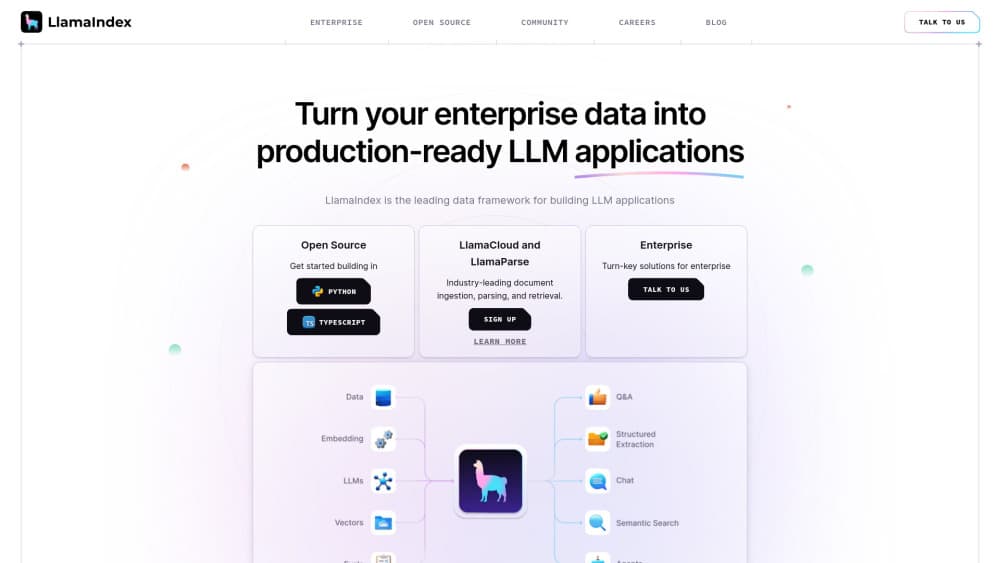
LlamaIndex는 RAG 앱과 AI 에이전트를 만드는 오픈소스 데이터 프레임워크다. 보유한 파일을 불러와 인덱스를 만들고, 이미 쓰고 있는 모델에 깨끗한 문맥을 넘긴다.
LlamaIndex 소개
About
LlamaIndex란 무엇인가
LlamaIndex는 내 문서와 언어 모델 사이에 놓는 코드 라이브러리다. 2022년 말 GPT Index로 나왔고 2023년에 지금 이름으로 바뀌었으며, 현재는 샌프란시스코의 LlamaIndex, Inc.가 유지한다. 라이선스는 MIT라서 코드를 읽고 포크하고 상용 제품에 넣는 데 허락을 받을 필요가 없다.
해결하는 문제는 밋밋하지만 없어지지 않는다. 모델은 공개 웹은 알지만 당신의 계약서, 지원 티켓, 실험 노트는 모른다. LlamaIndex는 그런 파일을 불러오고 노드로 쪼개고 벡터 인덱스나 키워드 인덱스에 넣은 뒤, 질문이 들어오면 필요한 조각만 되찾아오는 배관을 제공한다. 이 방식이 RAG이고, 이 라이브러리는 팀들이 시작할 때 가장 자주 비교하는 두 이름 중 하나다.
회사는 LlamaParse와 LlamaCloud도 판다. 문서 파싱, 추출, 인덱싱을 맡아주는 호스팅 서비스다. 이 구분이 중요하다. 프레임워크 자체는 무료지만, 스캔한 PDF를 쓸 만한 텍스트로 바꾸는 부분은 상용이고 크레딧으로 과금되며 소스가 닫혀 있다.
가장 큰 제약은 개발자용 도구라는 점이다. 오픈소스 쪽에는 끌어다 놓는 화면이 없다. Python이나 TypeScript를 쓰고, 키를 직접 설정하고, 답이 틀리면 검색 어디가 문제인지 직접 파고들어야 한다.
시작하기
pip install llama-index-core로 핵심 패키지를 설치하고, 이어서 사용할 모델의 제공자 패키지를 넣는다. 예를 들어llama-index-llms-openai다.- API 키를 환경 변수에 두거나, 로컬 모델을 돌린다면 Settings.llm을 그쪽으로 돌린다.
- SimpleDirectoryReader나 Notion, Slack, S3, 데이터베이스용 LlamaHub 커넥터로 파일을 읽는다.
- 보통은 벡터 인덱스인 저장 인덱스를 만들고 디스크에 남긴다. 실행할 때마다 임베딩을 다시 계산하지 않으려는 것이다.
- 분기, 재시도, 두 번째 에이전트가 필요해지면 쿼리 엔진을 Workflow로 감싸고 그대로 서비스로 배포한다.
제품 정보
LlamaIndex의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- 첫 RAG 앱을 만드는 Python 개발자. 공식 튜토리얼을 따라 하면 불러오기, 인덱싱, 질의를 수십 줄로 끝낸다. 다만 API 키나 로컬 모델은 직접 준비해야 한다.
- 문서 검색 제품을 맡은 AI 엔지니어. 검색 설정이 교체 가능한 객체라서 실제 질문으로 청크 크기와 리랭커를 비교하기 좋다.
- 스캔 서류에 파묻힌 데이터 팀. LlamaParse는 단순 PDF 텍스트 추출이 망가뜨리는 표와 손글씨를 읽는다. 대신 크레딧을 쓴다.
작업
- 사내 문서에 대한 질의응답. 폴더나 드라이브를 연결하고 인덱스를 만들면, 추측하는 채팅창이 아니라 출처가 붙은 답이 나온다.
- 청구서, 계약서, 보고서 처리. 추출과 분류 단계가 구조 없는 페이지를 스키마에 맞는 JSON으로 바꿔주므로, 뒤쪽 코드가 정규식으로 글자를 뜯지 않아도 된다.
- 여러 단계로 도는 AI 에이전트 구축. 이벤트 기반 워크플로가 작업을 단계별로 나누고, 되돌릴 수 없는 동작 앞에 사람 승인을 끼워 넣을 수 있다.
- 검색 전략 비교. 하이브리드 검색, 메타데이터 필터, 리랭커가 각각 별도 부품이라 앱을 다시 쓰지 않고 측정할 수 있다.
활용 상황
- 사내 지식베이스 시범 운영. 핵심이 무료라 시험 비용이 작고, 검색이 평범한 검색창을 이기는지 확인하기에 맞다.
- 논문과 특허 조사. 긴 PDF를 먼저 문서 파싱에 통과시키고, 그다음 쿼리 엔진이 수백 편을 한 번에 다룬다.
- 인프라 예산이 없는 초기 제품. 오픈 웨이트 모델로 전부 로컬에서 돌리고, 실제로 보낸 모델 호출만 지불한다.
주요 기능
실제 데이터 소스를 위한 커넥터
LlamaHub에는 파일 공유, Notion, Slack, Google Drive, SQL 데이터베이스, 웹 크롤링용 로더와 패키지가 수백 개 모여 있다. 모두 같은 Document 객체에 메타데이터를 붙여 돌려주므로, 날짜나 작성자로 거르는 방식이 텍스트 출처와 상관없이 같다. 덕분에 소스마다 어댑터를 따로 쓸 필요가 없다.
여러 인덱스 유형과 하이브리드 검색
검색 방식을 하나로 고정하지 않는다. 벡터 인덱스는 의미가 가까운 것을 처리하고, 키워드 인덱스는 정확한 이름과 코드를 잡고, 요약 인덱스는 문단이 아니라 문서 전체를 요구하는 질문에 답한다. 라우터로 잇거나 두 결과를 합치는 검색기를 얹고, 그 위에 리랭커를 둔다. 첫 실패를 겪은 뒤 대부분의 팀은 하이브리드 검색으로 정착한다.
이벤트 기반 워크플로
Workflow는 예전의 뻣뻣한 체인을 대신한다. 각 단계가 이벤트를 구독하고 타입이 붙은 결과를 넘기며, 반복하거나 분기하거나 사람 승인을 기다릴 수 있다. 평범한 비동기 Python이라서 일부 출력을 사용자에게 흘려보내고 나머지는 계속 돌릴 수 있다. 노트북을 벗어나면 그대로 마이크로서비스로 배포한다.
LlamaParse 문서 파싱
LlamaParse는 일반 로더가 무너지는 파일을 위해 만들었다. 스캔 페이지, 빽빽한 표, 차트, 손글씨다. 출력은 Markdown, 일반 텍스트, 페이지별 JSON, XLSX 중에서 고르고, 130가지가 넘는 파일 형식과 80개 언어를 지원한다고 밝힌다. 작업마다 파싱 모드를 고르므로, 깨끗한 디지털 PDF는 저렴한 설정으로, 상태 나쁜 스캔은 느린 에이전트 설정으로 돌린다.
LlamaCloud 플랫폼
LlamaCloud는 파싱, 추출, 분류, 분할, 인덱싱을 하나의 계정과 하나의 API 키 뒤에 모은다. 웹 콘솔에서 파일을 시험하고 설정을 저장한 다음, 같은 설정을 코드에서 호출한다. 모든 동작이 크레딧을 쓰지만 캐시된 재파싱은 과금되지 않는다. 프롬프트나 스키마를 다듬을 때 체감이 크다.
평가와 추적
라이브러리에는 직접 만든 테스트 질문으로 답의 충실도와 관련성을 채점하는 모듈이 들어 있고, Arize Phoenix나 LangSmith 같은 추적 도구와도 연결된다. 프롬프트를 바꿔서 제품이 나아졌는지 물을 때 숫자로 답할 수 있다. 이 순환이 없으면 검색 조정은 감에 기대는 일이 된다.
장단점
장점
- 검색이 설계의 중심이라, 돌아가는 RAG 파이프라인까지 필요한 연결 코드가 범용 에이전트 프레임워크보다 훨씬 적다.
- 핵심이 MIT 라이선스이고 사용자당 과금이 없으며, 스택 전체를 직접 운영하는 것을 막는 것도 없다.
- 모델과 벡터 스토어 제공자를 바꿀 수 있어 한 업체의 가격에 묶이지 않는다.
- LlamaParse는 표, 차트, 스캔을 읽는다. 단순 텍스트 추출이 쓰레기로 만드는 부분이다.
- Workflow가 분기, 재시도, 사람 검토를 라이브러리 안에서 제공한다.
단점
- 전부 코드로 한다. 화면에서 조립하는 도구를 기대한 팀은 첫날부터 개발자가 필요하다.
- 릴리스가 빠르고 API 이름도 바뀌어서, 1년 전 튜토리얼은 import 단계에서 실패하기 일쑤다.
- LlamaCloud는 크레딧 과금이고 1,000크레딧이 1.25달러라, 실제 파일로 시험하기 전에는 월 비용을 가늠하기 어렵다.
- 가장 좋은 문서 파싱이 유료 폐쇄 부분이라, 완전히 오픈된 구성에서는 PDF 처리가 약해진다.
자주 묻는 질문
프레임워크는 무료이고 MIT 라이선스다. Workflow와 LlamaHub 통합도 포함된다. 모델 토큰은 제공자에게 계속 내고, LlamaCloud나 LlamaParse 사용량은 따로 청구된다.
관련 콘텐츠
LlamaIndex와 관련된 도구, 스킬, 아티클을 살펴보세요.
LlamaIndex 대안

Emailwritr
Emailwritr · 글쓰기 · 마케팅Emailwritr는 이미 보유한 리스트에서 더 많은 매출을 끌어내려는 제휴 마케터, 강의 제작자, 온라인 사업자를 위해 만든 AI 이메일 카피라이팅 도구다. 빈 페이지나 일반적인 챗봇 프롬프트 대신, 이 AI 이메일 작성 도구는 잘 알려진 다이렉트 리스폰스 카피라이터를 본뜬 프레임워크로 웰컴 시퀀스, 런칭 캠페인, 장바구니 이탈 이메일, 프로모 시리즈를 생성한다. 오토리스폰더를 연결하고 제안에 관한 몇 가지 질문에 답하면 나머지 문구를 대신 써 준다.

Prosp
Prosp · 글쓰기 · 음성 및 언어 · 마케팅Prosp는 에이전시와 영업팀을 위해 만들어진 AI LinkedIn 아웃리치 도구다. 잠재 고객마다 자신의 목소리로 메시지와 음성 메시지를 작성해, 상대가 실제로 답장하도록 만든다. 계정을 연결하고 리드를 찾고, AI가 개인화된 메시지를 대량으로 작성해 보내도록 맡긴다. 전부 하나의 받은편지함에서 처리한다. 대량으로 아웃바운드를 돌리는 사람을 위해 만들어졌다. 그게 이 제품의 전부다. 그래도 모든 접점은 인간처럼 느껴져야 한다.
On Model
On Model · 이미지 · 마케팅On Model은 옷을 가상 모델에 입히는 AI 패션 모델 도구로, 온라인 스토어가 촬영을 예약하지 않고도 모델 착용 제품 사진을 얻을 수 있게 한다. Shopify 앱으로 작동하며, 기존 이미지의 모델을 교체하고 배경을 바꾸며, 잘린 사진이나 머리 없는 사진에 얼굴을 생성할 수 있다. 목표는 단순하다. 제품 사진을 고객에게 맞추고, 같은 공급업체 이미지를 쓰는 경쟁자와 차별화하는 것이다.