
MyScale
MOQI SINGAPORE PTE. LTD. · 코딩
MyScale는 ClickHouse 기반 SQL 벡터 데이터베이스다. ClickHouse 벡터 데이터베이스로서 벡터 검색, 전문 검색, 분석을 하나의 엔진에 담아 SQL로 다룬다. RAG와 AI 앱에 맞는다.
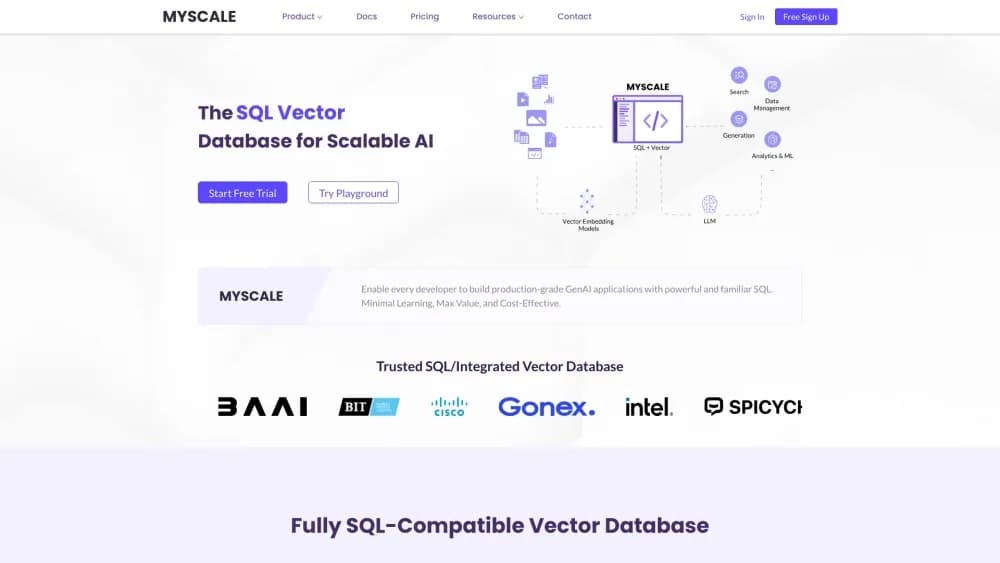
MyScale 소개
What Is MyScale
MyScale는 AI 애플리케이션을 겨냥한 클라우드 데이터베이스이며, 오픈소스 ClickHouse 엔진 위에서 돈다. 발상은 단순하다. 구조화 데이터, 벡터, 텍스트를 한 시스템에 두고 이미 아는 SQL로 한 번에 질의한다. MSTG라 부르는 자체 엔진은 수십억 규모 벡터 검색에 맞춰져 있고, 회사는 전용 벡터 데이터베이스보다 속도와 비용에서 4배에서 10배 앞선다고 주장한다. 이 수치는 회사 자체 벤치마크이므로, 내 벡터로 확인한 뒤 판단하는 편이 낫다.
이 제품이 푸는 문제는 도구가 흩어지는 일이다. 전형적인 RAG 구성은 벡터 저장소를 관계형 데이터베이스와 검색 엔진에 덧붙이고, 그러면 세 시스템과 세 가지 질의 언어를 떠안는다. MyScale는 그것들을 하나로 합치므로, 한 번의 질의로 메타데이터 필터링과 벡터 유사도 정렬을 동시에 할 수 있다. 개발자는 전용 벡터 API를 익히지 않고 SQL 실력을 그대로 쓴다.
대가는 MyScaleDB가 젊고 ClickHouse 자체보다 범위가 좁다는 점이다. ClickHouse에서 갈라져 나와 벡터 작업을 위해 저장과 실행 엔진을 바꾸므로, 상위 릴리스에 뒤처질 수 있다. Apache 2.0 오픈소스 버전을 직접 운영할 수도 있지만, MSTG 엔진을 포함한 완성도 높은 경험은 MyScale Cloud를 통해서만 나온다.
Getting Started
- myscale.com에서 가입하고 Clusters 페이지에서 클러스터를 띄운다.
- Connection Details에서 호스트, 사용자 이름, 비밀번호를 받아 Python 클라이언트, Node.js, Go, JDBC, HTTPS 중 하나로 접속한다.
- 테이블을 만들고 행을 넣은 뒤, 벡터 열에 cosine 같은 메트릭으로 벡터 인덱스를 건다.
- ORDER BY distance와 LIMIT으로 SQL 벡터 검색을 돌리거나, WHERE로 먼저 행을 걸러낸다.
- OpenAI, LangChain, LlamaIndex 연동으로 스택에 붙이고 배포한다.
제품 정보
MyScale의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- 백엔드와 AI 개발자
- RAG 개발자
- 데이터 팀
작업
- RAG 검색 뒷받침
- 하이브리드 검색
- 필터링 벡터 검색
- 앱에 시맨틱 검색 추가
활용 상황
- 첫 RAG 기능을 내놓는 팀
- 여러 데이터베이스 구성을 바꾸는 스타트업
- 데이터가 계속 늘어나는 AI 앱
주요 기능
SQL로 하는 벡터 질의
MyScale는 벡터 검색을 SQL 연산으로 다룬다. 열에 벡터 인덱스를 걸고, ORDER BY 안에서 거리 함수로 행을 정렬하며, WHERE, JOIN, GROUP BY와 자유롭게 섞는다. SQL을 안다면 여기서 벡터 데이터베이스를 다루는 법도 이미 아는 셈이다.
MSTG 벡터 엔진
MSTG는 MyScale 자체 인덱싱 알고리즘이며, NVMe SSD를 써서 노드당 데이터를 더 많이 담는다. 표준 구성의 약 10배 데이터 밀도에 이르고 비용에서 전용 벡터 데이터베이스를 앞선다고 회사는 말한다. 회사 벤치마크이므로 도입 전에 내 벡터로 시험해 보는 편이 좋다.
전문 검색과 하이브리드 검색
벡터와 함께 MyScale는 언어별로 조정 가능한 토크나이저가 달린 BM25 전문 인덱스를 갖춘다. 텍스트 검색을 단독으로 돌리거나 하이브리드 질의에서 벡터 결과와 섞을 수 있다. RAG에서는 이 조합이 한쪽만 쓸 때보다 좋은 구절을 더 자주 찾아낸다.
모든 비율의 필터링 검색
필터링 검색은 많은 벡터 데이터베이스가 약한 지점이다. MyScale는 먼저 메타데이터로 거른 뒤 남은 행을 검색하므로, 수십억 행 중 아주 일부만 남는 필터에서도 정확도가 유지된다. 실무에서는 이것이 깔끔한 결과와 느리고 흐릿한 결과를 가르는 차이다.
통합 데이터 관리
저장은 벡터에 그치지 않는다. MyScale는 구조화 열, JSON, 텍스트, 지리공간, 시계열 데이터를 같은 테이블에서 다룬다. 어떤 제품과 그 임베딩, 판매 이력이 나란히 놓이므로, 한 번의 질의로 AI 특성과 업무 데이터를 연결한다.
연동과 클라이언트
MyScale는 OpenAI, LangChain, LangChain JS/TS, LlamaIndex에 연결되며 Python, Node.js, Go, JDBC 클라이언트와 HTTPS 인터페이스를 제공한다. 대부분의 팀은 처음부터 만들지 않고 기존 파이프라인에 끼워 넣어, 이전 작업이 짧다.
MyScale Telemetry
Telemetry는 LLM 시스템의 관측성을 제공해 프롬프트, 응답, 검색 단계를 한곳에서 추적한다. 이것이 없으면 RAG 파이프라인 디버깅은 나쁜 답이 어디서 왔는지 추측하는 일이 되고, 있으면 모델에 들어간 검색 결과를 본다.
보안과 접근 제어
MyScale는 SQL 기반 역할 기반 접근 제어를 제공하고 SOC 2와 ISO 27001 준수를 밝힌다. 민감한 데이터를 다루는 팀에는 클러스터 전체를 열지 않고 제한된 권한을 주는 길이 된다.
장단점
장점
- SQL과 완전히 호환되므로, SQL을 아는 사람은 자체 API나 새 질의 언어를 배우지 않고 벡터 검색을 돌린다.
- 벡터 검색, 전문 검색, 분석이 한 엔진을 공유해, 전형적인 RAG 구성이 필요로 하는 군더더기 서비스를 없앤다.
- MSTG 엔진은 디스크상의 수십억 규모 벡터를 겨냥해, 큰 컬렉션을 통째로 메모리에 올리지 않아도 된다.
- 필터링 검색은 정렬 전에 메타데이터로 거르므로, 선택도가 높은 질의에서도 정확도가 떨어지지 않는다.
- 768차원 벡터 500만 개를 담는 무료 pod와 OpenAI, LangChain, LlamaIndex 연동 덕에 시험이 빠르다.
단점
- 4배에서 10배라는 성능과 비용 수치는 회사 자체 벤치마크이므로, 믿기 전에 내 데이터로 재현해 보는 편이 좋다.
- ClickHouse에서 갈라진 만큼 MyScaleDB는 상위 엔진과 그 기능 범위에 뒤처질 수 있고, 최신 ClickHouse 기능이 필요하면 신경 쓰인다.
- MSTG 엔진을 포함한 강력한 기능은 MyScale Cloud에 있어, 오픈소스 버전을 직접 운영하면 제품이 덜 완전하다.
- 널리 쓰이는 모바일이나 데스크톱 앱은 없어, 최종 사용자 도구보다 서버와 파이프라인 작업에 맞는다.
자주 묻는 질문
MyScale는 AI 앱 뒤의 데이터를 저장하고 질의하며, 주로 RAG 시스템의 검색과 시맨틱 검색에 쓴다. 벡터, 텍스트, 구조화 행을 함께 두고 SQL로 질의한다.
관련 콘텐츠
MyScale와 관련된 도구, 스킬, 아티클을 살펴보세요.
MyScale 대안

Base Code
Base44 (Wix) · 코딩 · 생산성Base Code는 Base44가 만든 공유 클라우드 개발 환경이다. 팀은 기존 GitHub 저장소에 대한 변경을 채팅으로 설명하고, 미리보기로 확인한 뒤 풀 리퀘스트로 돌려보낸다.

Google EmbeddingGemma 2
Google DeepMind · 글쓰기 · 이미지 · 코딩Google EmbeddingGemma 2는 7억 4000만 파라미터의 오픈 모델로, 텍스트와 코드, 이미지, 오디오, 영상 프레임을 하나의 768차원 공간에 벡터로 바꿔 스마트폰과 노트북에서 실행한다.

GitGlow
GitGlow · 코딩 · 생산성GitGlow는 내 코드와 AI 에이전트의 변경을 한 리뷰에 모으는 데스크톱 Git 클라이언트다. 배포 전에 내 기계에서 무엇이 나가는지 확인할 수 있다.