
OctoAI
OctoAI (formerly OctoML, now part of NVIDIA) · 코딩
OctoAI는 Llama, Mistral, Stable Diffusion 같은 오픈 모델을 OpenAI 호환 API로 돌려주던 클라우드 AI 추론 API다. 2024년 NVIDIA가 인수했고 그해 말 서비스를 접었다.
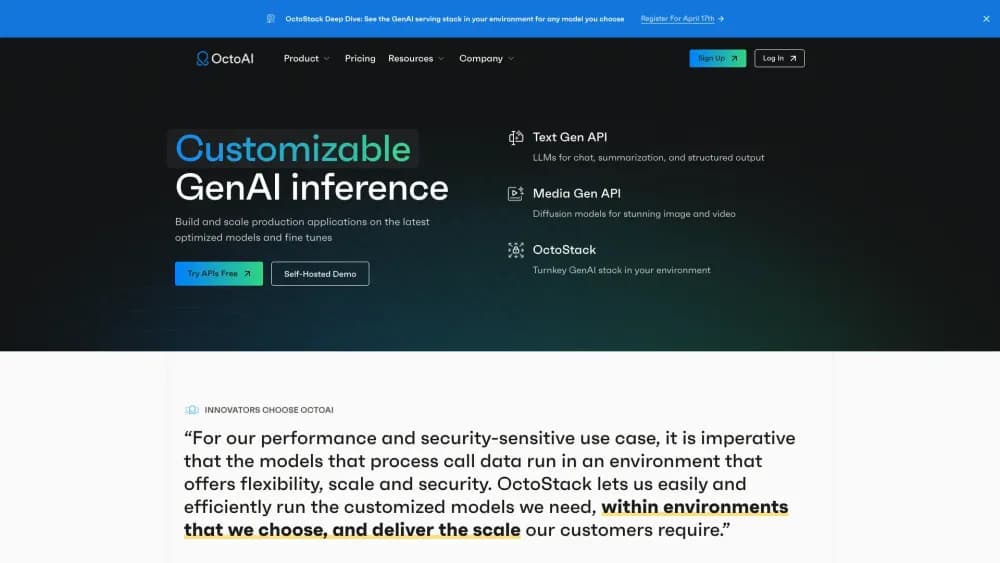
OctoAI 소개
About
OctoAI란
OctoAI는 시애틀의 회사로, 오픈소스 AI 모델을 빠르고 싸게 쓰는 길을 팔았다. API에 요청을 보내고 카탈로그에서 모델을 고르면 텍스트나 이미지가 돌아왔다. 승부처는 속도였다. 같은 GPU에서 더 많은 성능을 뽑아내도록 모델을 손봤기 때문에, 평범한 클라우드 배포보다 응답이 빨랐고 비용도 낮았다.
그 바탕은 챗봇이 아니라 컴파일러다. OctoAI는 2019년 OctoML로 출발했다. 워싱턴대에서 나온 회사로, 지금 가진 칩에서 모델이 제대로 돌도록 코드를 다시 써 주는 오픈소스 컴파일러 Apache TVM이 핵심이었다. 이 작업은 나중에 Llama나 Stable Diffusion을 제품에 넣고 싶지만 머신러닝 인프라 팀을 꾸릴 형편이 아닌 앱 개발자를 겨냥한 오픈 모델 호스팅으로 묶였다.
그 서비스는 이제 없다. NVIDIA가 2024년 9월 OctoAI를 인수했고, 회사는 모든 서비스 접근이 2024년 10월 31일에 끝난다고 고객에게 통보했다. 계정은 비활성화됐고 API는 꺼졌다. 팀은 NVIDIA 소프트웨어 조직으로 옮겼다. 지금 OctoAI를 찾는 사람은 닫힌 장을 보고 있는 셈이고, 실제로 궁금한 것은 무엇이 그 자리를 대신했느냐다.
시작하는 방법
플랫폼이 퇴역해서 가입 절차를 밟을 수는 없다. 아래는 서비스가 살아 있던 시절의 흐름이다. 옛 튜토리얼을 읽거나 이전을 계획할 때 참고할 만하다.
- OctoAI 플랫폼에서 계정을 만들고 콘솔에서 API 토큰을 발급한다.
- Llama, Mistral, Stable Diffusion XL 같은 모델을 카탈로그에서 고르거나, 직접 미세 조정한 모델을 올린다.
- 코드의 접속 주소를 OpenAI 호환 엔드포인트로 바꾼다. 기존 클라이언트 라이브러리 대부분은 기본 URL만 교체하면 동작했다.
- 요청을 보내고 돌아온 텍스트나 이미지, JSON을 읽는다.
- 사설 배포라면 자사 클라우드 계정이나 온프레미스에서 OctoStack을 돌린다. 트래픽이 공용 인프라를 거치지 않는다.
제품 정보
OctoAI의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- 오픈 모델로 제품을 만드는 개발자
- OctoAI에서 옮겨야 하는 팀
- 규제 산업 기업
작업
- 운영 규모의 텍스트 생성 서빙
- Stable Diffusion XL로 이미지 만들기
- 미세 조정 모델 호스팅
- 오래된 의존성 점검
활용 상황
- OctoAI에 기대던 프로토타입
- 추론 공급사 구매 검토
- 2024년 튜토리얼 읽기
주요 기능
OpenAI 호환 텍스트 생성
Llama 2를 7B, 13B, 70B로 제공했고 대화용 변형과 Code Llama, Mistral 7B도 있었다. API가 OpenAI 요청 형식을 따랐기 때문에 그 표준을 이미 쓰던 팀은 기본 URL만 바꿔 공급사를 갈아탔다. 이 호환성 덕에 새 공급사 검증이 설정 몇 줄로 줄었다.
Stable Diffusion XL 이미지 API
이미지 쪽은 Stable Diffusion XL을 돌렸고, 호출 안에서 자체 LoRA 어댑터를 붙일 수 있었다. 게임 스튜디오나 마케팅 팀은 기본 모델을 학습시키지 않고도 브랜드 색깔이 묻은 그림을 뽑았다. 응답은 나중에 조회할 대기 번호가 아니라 완성된 이미지였다.
하드웨어 독립 최적화
강점은 Apache TVM에서 나왔다. 모델을 특정 칩에 맞춘 코드로 바꾸는 컴파일러다. OctoAI는 이 조정을 자기 서버에서 처리했기에 속도 이득이 설치할 패키지가 아니라 API 응답 시간으로 나타났다. 지원 범위는 NVIDIA GPU, AMD 하드웨어, Intel CPU, AWS Inferentia 칩까지 넓었다. 시장이 NVIDIA로 쏠리면서 이 이식성의 값은 떨어졌다.
사설 배포용 OctoStack
2024년 4월에 나온 OctoStack은 기업이 같은 추론 스택을 자기 환경에서 돌리게 했다. AWS, Google Cloud, Azure, CoreWeave, Lambda Labs, 자체 데이터센터 어디든 상관없었다. 내세운 것은 프라이버시와 통제다. 의료, 금융, 공공 팀은 데이터를 OctoAI 서버로 보내지 않고 모델을 쓸 수 있었다. 회사는 직접 구축한 구성보다 GPU 활용률이 4배 높고 운영 비용이 50% 낮다고 주장했다.
자체 모델 반입
카탈로그 밖에서도 미세 조정한 Llama 2 변형을 올려 다른 엔드포인트처럼 호출할 수 있었다. 맞춤 모델용 서빙 계층을 직접 만들지 않아도 됐다. 다만 미세 조정 자체는 다른 곳에서 만들고 검증해야 했다.
사용량 기반 요금
고정 월정액 대신 소비량으로 과금했다. 무료 체험 구간이 있었고, 텍스트는 토큰 단위, SDXL은 이미지 단위, 맞춤 엔드포인트는 GPU 시간 단위로 청구했다. 절감 폭이 큰 쪽은 튜닝된 모델이었다. 회사는 최적화하지 않은 배포보다 최대 10배 빠르다고 설명했다.
장단점
장점
- API가 OpenAI 형식이라 기존 앱은 기본 URL과 키만 바꾸면 옮겨 갔다
- 튜닝된 모델은 응답이 더 빠르고 토큰당 비용이 생짜 클라우드 GPU 배포보다 낮았다
- 자체 LoRA 어댑터로 모델 학습 없이도 이미지 생성의 브랜드 톤을 유지할 수 있었다
- OctoStack 덕에 규제 산업도 데이터를 자사 클라우드 계정 안에 둘 수 있었다
- 무료 체험 구간으로 예산을 잡기 전에 지연 시간과 품질을 재 볼 수 있었다
단점
- 플랫폼 전체가 2024년 10월 31일에 꺼졌다. NVIDIA의 인수 발표에서 약 5주 뒤다
- 같은 작업을 이어받은 NVIDIA 제품이 없어서 고객은 경쟁 추론 서비스에서 다시 만들어야 했다
- 모델 추가 속도가 가장 빠른 경쟁사보다 늦어, 새 오픈 모델은 몇 주에서 몇 달씩 경쟁사에 먼저 올라갔다
- 시장이 NVIDIA GPU로 모이면서 하드웨어 독립이라는 명분이 약해졌고, OctoAI를 고를 이유도 좁아졌다
- 맞춤 엔드포인트 요금은 고정 토큰 단가보다 예측이 어려워, 트래픽이 들쭉날쭉한 팀은 예산 잡기가 힘들었다
자주 묻는 질문
NVIDIA가 2024년 9월 OctoAI를 인수했고 회사는 2024년 10월 31일 모든 상용 서비스를 종료했다. CEO Luis Ceze가 이끄는 팀은 NVIDIA로 합류했고, API와 플랫폼은 더 이상 트래픽을 받지 않는다.
관련 콘텐츠
OctoAI와 관련된 도구, 스킬, 아티클을 살펴보세요.
OctoAI 대안

Base Code
Base44 (Wix) · 코딩 · 생산성Base Code는 Base44가 만든 공유 클라우드 개발 환경이다. 팀은 기존 GitHub 저장소에 대한 변경을 채팅으로 설명하고, 미리보기로 확인한 뒤 풀 리퀘스트로 돌려보낸다.

Google EmbeddingGemma 2
Google DeepMind · 글쓰기 · 이미지 · 코딩Google EmbeddingGemma 2는 7억 4000만 파라미터의 오픈 모델로, 텍스트와 코드, 이미지, 오디오, 영상 프레임을 하나의 768차원 공간에 벡터로 바꿔 스마트폰과 노트북에서 실행한다.

GitGlow
GitGlow · 코딩 · 생산성GitGlow는 내 코드와 AI 에이전트의 변경을 한 리뷰에 모으는 데스크톱 Git 클라이언트다. 배포 전에 내 기계에서 무엇이 나가는지 확인할 수 있다.