
Open Knowledge Maps
Open Knowledge Maps, charitable non-profit based in Vienna, Austria · 코딩 · 비즈니스
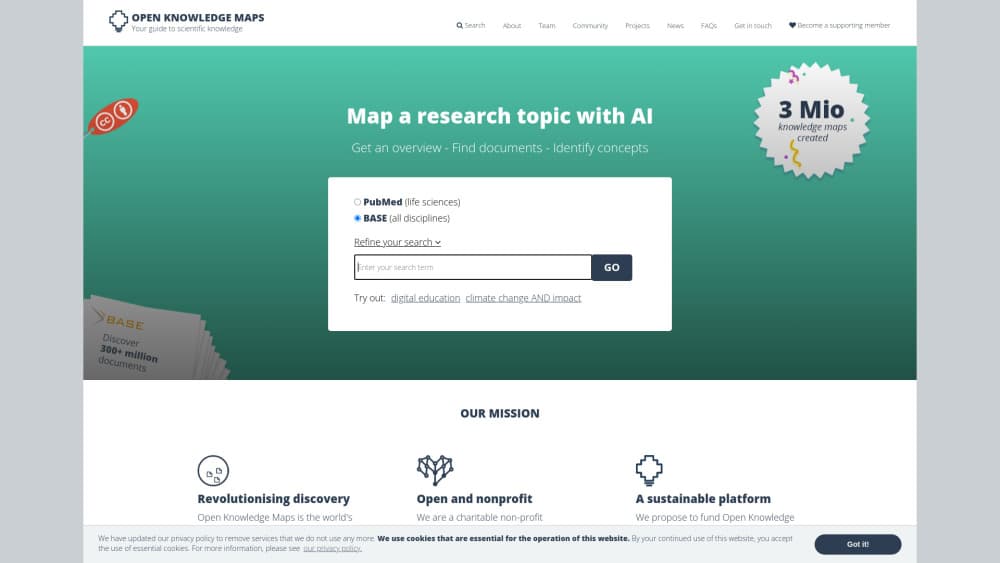
Open Knowledge Maps는 한 번의 검색을 연구 분야의 지식 지도로 바꾸는 무료 비영리 AI 연구 탐색 도구다. 4억 건의 논문, 프리프린트, 연구 데이터를 바탕으로 한다.
Open Knowledge Maps 소개
About
Open Knowledge Maps란
낯선 분야에서 처음 하는 검색이 가장 어렵다. 데이터베이스는 수천 줄을 돌려주지만 정렬 순서에 뚜렷한 의미가 없고, 화면 어디에도 어느 논문 묶음이 중요한지 알려주지 않는다. Open Knowledge Maps(줄여서 OKMaps)는 과학 문헌 검색을 지도 그리기 문제로 다룬다. 검색어 하나가 지식 지도가 되고, 관련도가 높은 100건이 이름표가 붙은 원 안에 나뉘어 들어간다.
바탕에는 시각화 계층을 얹은 학술 검색 엔진이 있다. 레코드는 BASE, PubMed, OpenAIRE에서 모은다. AI 처리 과정이 제목, 초록, 저자, 저널, 주제어를 기준으로 비슷한 것을 묶고, 후보 용어를 TF-IDF로 점수화해 각 영역에 이름을 붙인다. 그래서 원 안에 "기후 변화 적응"이라고 적히지 "클러스터 4"라고 적히지 않는다.
일상 사용에서는 두 가지 제약이 작동한다. 지도는 상위 100건만 쓰므로 검색어를 좁히는 편이 넓게 잡는 것보다 유용하고, 생성에는 최대 30초가 걸린다. 검색이 제공자 쪽에서 실시간으로 돌기 때문이다. 계정은 필요 없고 지도마다 공유용 링크가 붙는다.
시작하기
- openknowledgemaps.org를 열고 검색창에 주제를 입력한다. 긴 문장보다 짧은 구가 잘 맞는다.
- 데이터 소스를 고른다. BASE는 전 분야의 리포지터리와 출판사를 아우르고, PubMed는 의학과 생명과학에 강하다.
- 검색을 실행하고 기다린다. BASE 조회는 최대 30초가 걸린다.
- 논문보다 원을 먼저 읽는다. 원을 클릭하면 그 영역의 자료가 나온다.
- 지도 링크를 공유하거나, 레코드를 열어 오픈 액세스 표시를 따라 전문으로 이동한다.
제품 정보
Open Knowledge Maps의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- 논문을 막 시작한 학생
- 사서와 연구 지원 인력
- 분야를 넘나드는 연구자
작업
- 낯선 주제의 윤곽 잡기
- 모호한 검색어를 분야별로 나누기
- 바로 읽을 수 있는 전문 찾기
- 문헌 검토의 배경 장 구성하기
활용 상황
- 박사 논문 첫 주
- 연구비 신청서 준비
- 문헌 검색 워크숍 진행
주요 기능
결과 목록 대신 지식 지도
핵심 산출물은 원이 하위 영역을 뜻하고 크기가 그 영역에 들어간 레코드 수를 따르는 그림이다. 주요 영역을 한눈에 보고 내 질문에 맞는 원으로 들어간다. 정렬된 목록과 달리 지도는 연구 주제 개요를 먼저 주고 다른 질문에 답한다. 이 분야에 무엇이 있는지이지, 내 단어와 맞는 것이 무엇인지가 아니다.
분야를 갈라 놓는 군집화
AI 처리 과정이 메타데이터 유사도로 레코드를 묶으므로, 여러 뜻을 가진 키워드가 뒤섞인 더미로 돌아오지 않는다. 논쟁이 있는 용어를 검색하면 그 말을 쓰는 연구 공동체마다 별도 덩어리가 생긴다. 분야 이름을 손으로 검색어에 붙이는 것보다 맞는 원을 고르는 편이 빠르다.
문헌에서 뽑아낸 영역 이름표
각 원에는 최대 세 개의 이름표가 붙는다. 그 덩어리 안에서 자주 나오고 밖에서는 드물게 나오는 용어 중에서 고른다. 추출 방식이라 사용된 표현이 저자가 쓴 말에 가깝게 남는다. 주제어가 빠진 레코드는 제목과 초록에서 추정하므로 이름표가 논문 원어로 나오기도 한다.
오픈 액세스 표시와 화면 안 읽기
지도에는 유료 레코드와 오픈 레코드가 섞여 있고, 오픈 쪽에 표시가 붙는다. 상당수는 지도 화면에서 바로 열려 출판사 사이트를 거치는 수고를 덜어 준다. 어떤 주장을 더 파볼 가치가 있는지만 알고 싶은 사람에게는 전문 내려받기보다 이 지름길이 낫다.
4억 건과 25가지 이상의 산출물 유형
색인은 저널 논문에 그치지 않는다. 프리프린트, 소프트웨어, 연구 데이터 등 여러 유형을 전 분야에 걸쳐 담는다. 중요한 성과가 논문이 되지 않는 분야, 가령 컴퓨터과학이나 사회과학 데이터 수집에서 이 폭이 힘을 발휘한다. 범위는 고른 제공자에 따라 달라서 BASE와 PubMed의 결과가 같지 않다.
기관용 임베드 지도
조직은 Custom Services를 계약해 자체 목록이나 리포지터리에 지도를 넣을 수 있고, 소장 자료로 결과를 제한하는 설정도 가능하다. 오스트리아와 스위스의 도서관 네트워크가 모듈로 제공하며, 서비스는 클라우드 구성 요소로 돌아간다. 가격은 기관마다 따로 정하고 공개 요금표는 없다.
장단점
장점
- 무료이고 계정도 광고도 검색 횟수 제한도 없다. 비영리 단체가 기관 회비로 플랫폼을 운영한다.
- 제목 100개를 훑으며 비슷한 것을 짐작하던 느린 작업을 시각적 개요가 대신한다.
- 오픈 액세스 표시와 화면 안 읽기 덕분에 그럴듯한 제목에서 실제 본문까지 거리가 줄어든다.
- 모호한 검색어를 다루는 능력이 평면적 목록보다 낫고, 분야를 넘나드는 작업에서 차이가 난다.
- 링크만 넘기면 학생, 공저자, 워크숍 참가자에게 지도를 공유할 수 있다.
단점
- 지도 한 장은 최대 100건으로 만들어져, 핵심 논문이 경계 밖으로 밀려 아예 나오지 않을 수 있다.
- 생성에 최대 30초가 걸리고 세션 사이에 아무것도 저장되지 않아, 같은 검색을 다시 하면 같은 대기 시간을 치른다.
- 공개 API가 없다. 자동화와 목록 통합은 조직 대상 유료 Custom Services로만 가능하다.
- 군집화는 전문이 아니라 메타데이터를 읽으므로, 색인이 얇거나 영어가 아닌 성과는 과소평가될 수 있다.
자주 묻는 질문
검색을 실행하고 결과를 순위 목록이 아니라 연구 영역 지도로 그린다. 각 영역에는 안에 있는 논문에서 뽑은 이름표가 붙고, 거기서 레코드로 이동한다.
관련 콘텐츠
Open Knowledge Maps와 관련된 도구, 스킬, 아티클을 살펴보세요.
Open Knowledge Maps 대안

Udon
Udon · 코딩 · 생산성Udon은 Apple Silicon Mac을 Mac 홈서버로 바꾸는 소프트웨어다. 브라우저에서 컨테이너와 파일 공유를 관리하고, 원하면 AI 시스템 관리자까지 붙일 수 있다.

offstage
offstage cloud · 코딩 · 생산성offstage는 AI 에이전트와 CI 작업에 진짜 Mac을 넘긴다. Apple Silicon 위의 새 macOS 27 계정을 API로 다루고 초 단위로 과금한다.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · 코딩 · 생산성BotBus는 AI 코딩 에이전트 원격 제어 앱이다. 스마트폰과 워치에서 명령을 승인하고, 작업을 시작하고, 결과를 확인한다.