
PDF Dino
PDF Dino · 코딩 · 생산성
PDF Dino는 PDF 파일을 Excel, CSV, JSON으로 바꾸는 AI PDF 데이터 추출 도구다. PDF 구조화 데이터가 빨리 필요한 재무, 법무, 자동화 팀을 겨냥한다.
PDF Dino 소개
What Is PDF Dino
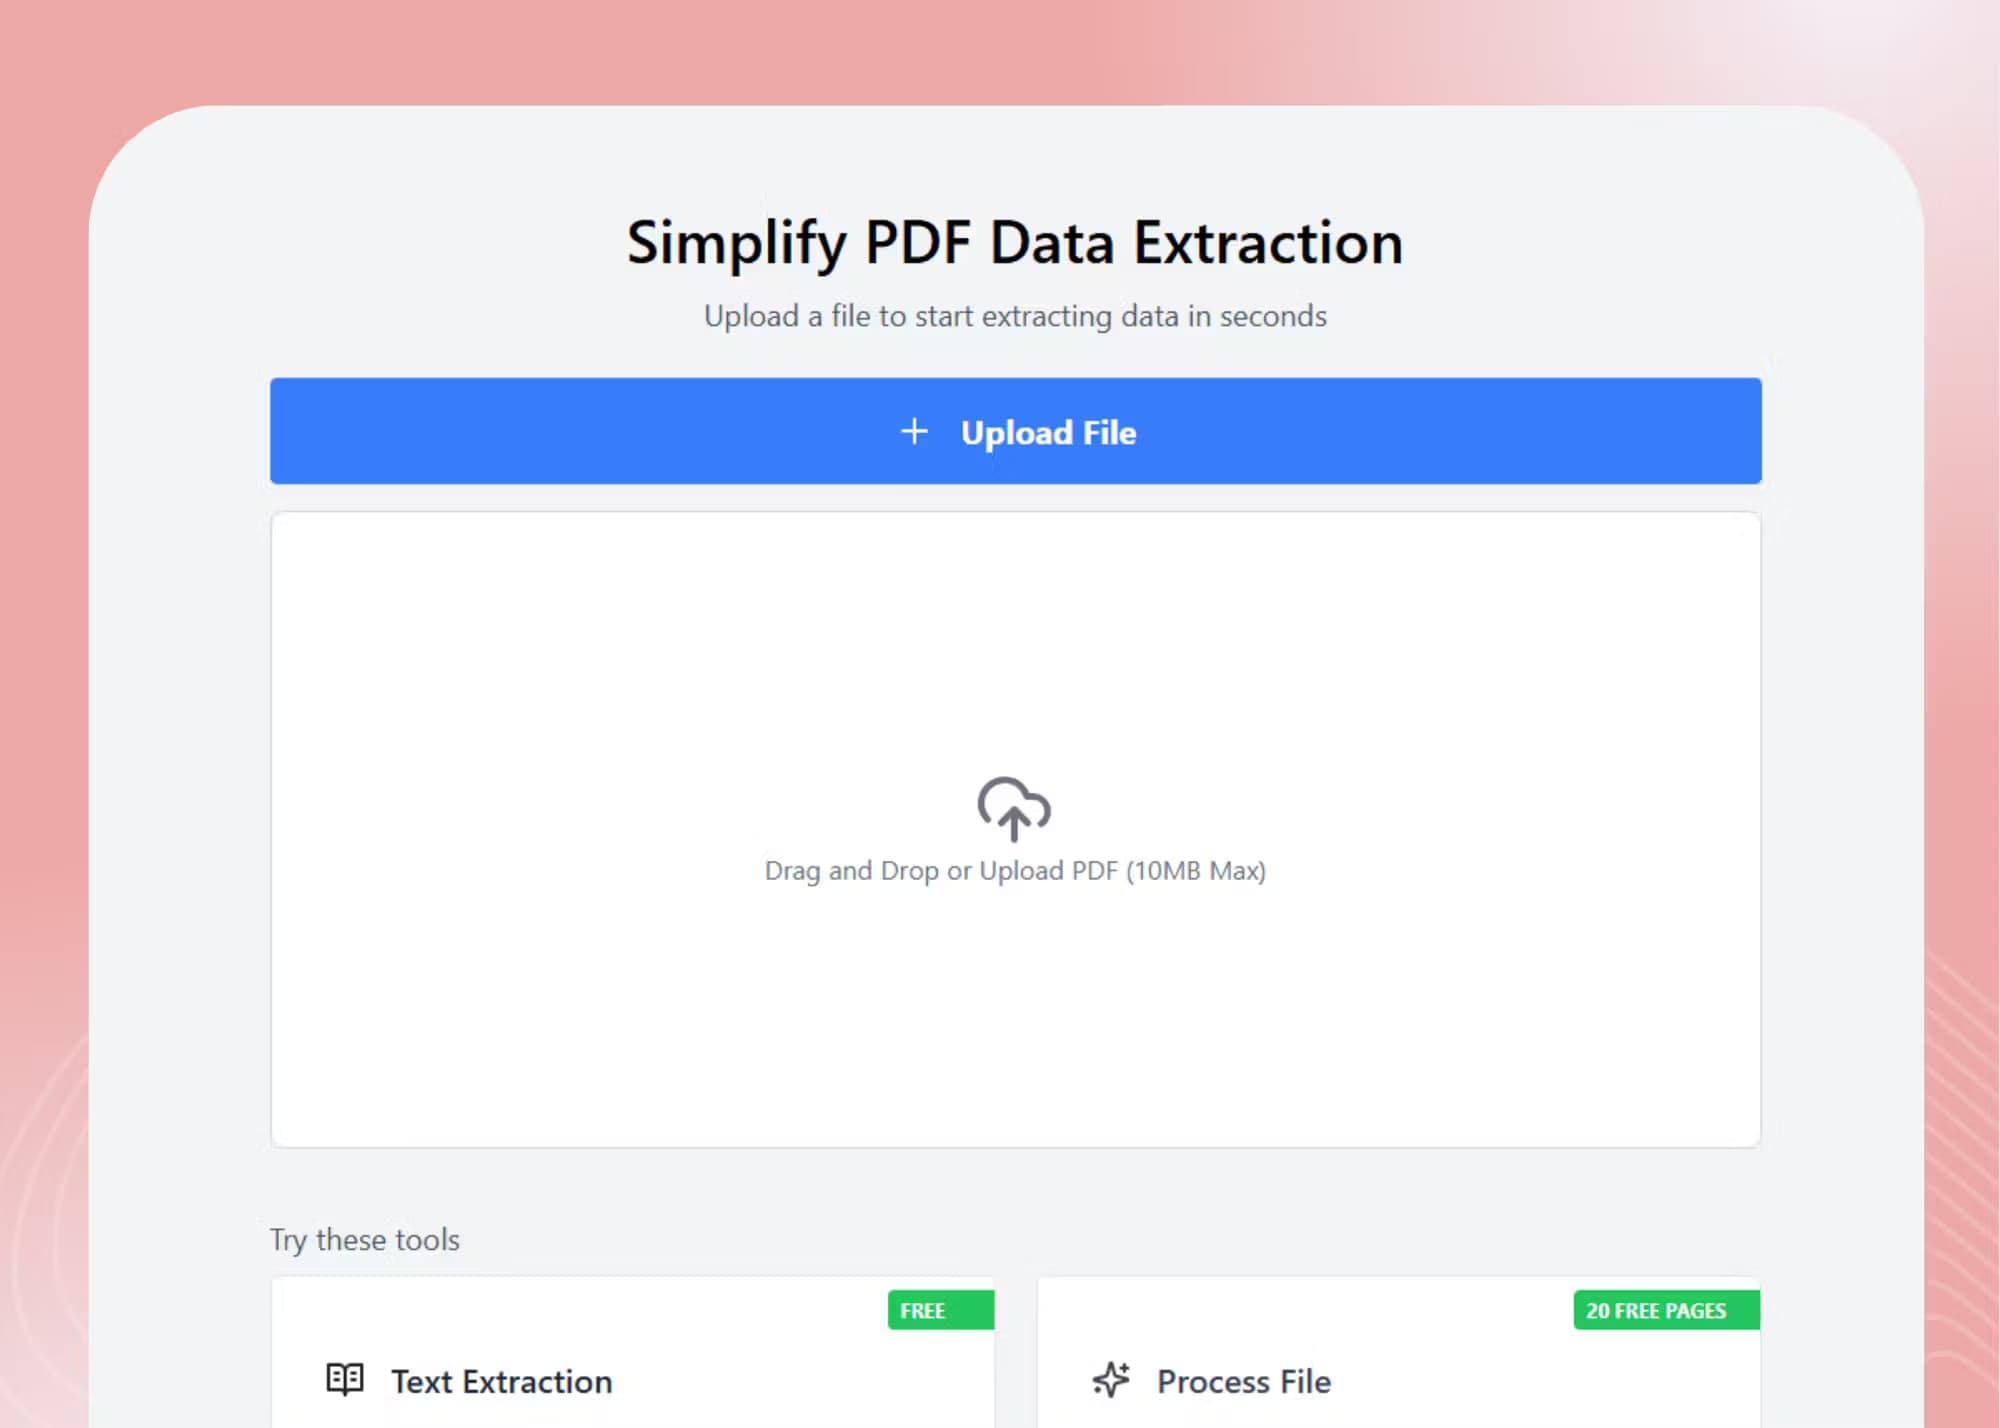
PDF Dino는 PDF 파일에서 구조화된 데이터를 뽑아내는 웹 도구다. 문서를 올리면 AI가 레이아웃을 읽고 표를 그대로 살린 뒤 같은 정보를 Excel, CSV, JSON, 일반 텍스트로 돌려준다. 대부분 같은 벽에 부딪힌다. PDF는 화면에서 멀쩡해 보이지만 숫자를 다시 쓰려는 순간 버틴다. 표를 스프레드시트로 복사하면 열이 뒤엉키고, 청구서를 손으로 다시 만들면 오후가 통째로 사라진다. PDF Dino가 노리는 건 바로 이 지점이지, 일반적인 문서 편집이 아니다.
분명히 할 점은 이게 데이터 도구지 PDF 편집기가 아니라는 것이다. 여기서는 주석도, 서명도, 페이지 재편집도 못 한다. 흐릿한 스캔이나 얇은 글씨는 여전히 정확도를 떨어뜨린다. 숫자를 끌어내는 도구지 문서를 예쁘게 만드는 도구가 아니다.
Getting Started
- PDF Dino 사이트에서 무료 계정을 만든다. 새 사용자는 20크레딧으로 시작한다.
- PDF를 올리거나 여러 파일을 한 번에 끌어다 놓는다.
- 원하는 항목이나 표를 고르고 내보내기 형식을 정한다.
- AI 추출을 실행한 뒤 파싱 결과를 확인한다.
- 구조화 파일을 내려받거나 곧바로 자신의 업무 흐름에 넣는다.
제품 정보
PDF Dino의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- 재무·회계 담당자
- 법무·컴플라이언스 팀
- 연구자와 학생
- 자동화 개발자
작업
- 재무 보고서에 PDF를 Excel로 변환하는 도구를 쓰기
- 출하 전표에서 주문 정보를 뽑기
- 여러 보고서를 PDF to JSON 방식으로 JSON으로 바꾸기
- 증권 계좌 명세서에서 숫자를 끌어오기
활용 상황
- 월말 마감
- 계약서 일괄 검토
- AI 워크플로 구축
- 문헌 검토
주요 기능
똑똑한 AI 추출
PDF Dino는 텍스트 모델과 비전 모델을 함께 써서 기본 변환 도구가 막히는 문서를 읽어낸다. PDF 표 추출을 해내며, 다단 페이지를 다루고, 성가신 줄바꿈도 견딘 뒤 레이아웃을 깔끔한 항목으로 다시 세운다. 핵심은 어수선한 레이아웃에서의 정확도지, 직접 복사할 수 있는 글자가 아니다.
유연한 내보내기 형식
결과는 JSON, Excel, CSV, 일반 텍스트로 나간다. 이 폭이 중요한 이유는 팀마다 쓰는 도구가 다르기 때문이다. 회계는 스프레드시트를 원하고, 개발자는 JSON을 선호하며, 작은 사업체는 텍스트만 있으면 될 수도 있다. 형식은 추출 뒤에 고르니, PDF 하나가 여러 용도에 응한다.
큰 파일 처리
이 도구는 수천 페이지를 한 번에 삼키도록 만들어졌다. 묶음이 커져도 속도가 유지되며, 바로 이 지점이 한 페이지짜리 온라인 변환 도구와 갈린다. 스캔한 보고서에 파묻힌 사람에게는 이 처리량이 하루를 구해 준다.
내장된 파일 보안
파일은 암호화된 연결로 오가고 엄격한 개인정보 기준 아래 처리된다. 계약서, 급여, 재무 기록을 다루는 팀에 이 보호는 선택이 아니다. 민감한 문서를 마음 놓고 맡길 수 있는 이유가 여기 있다.
넓은 사용 사례
PDF Dino에는 재무, 법무, AI, 연구, 이커머스 문서용 흐름이 이미 갖춰져 있다. 각 흐름은 그 작업에 정말 필요한 항목을 가리킨다. 회계라면 합계, 물류라면 SKU 식이다. 실제로 다루는 문서에서 설정에 드는 시간을 줄여 준다.
장단점
장점
- 표와 다단 레이아웃을 손으로 다시 입력하지 않고 구조화 데이터로 바꾼다.
- JSON, Excel, CSV, 텍스트로 내보내니 결과가 기존 도구에 그대로 맞는다.
- 큰 묶음과 수천 페이지를 한 번에 처리한다.
- 무료 요금제에 텍스트 추출과 고급 기능을 시험할 20크레딧이 포함된다.
- 청구서, 계약서, 보고서 같은 흔한 문서 유형을 기본으로 다룬다.
단점
- 데이터 추출 도구지 PDF 편집기가 아니라서 서명이나 페이지 재편집은 못 한다.
- 정확도는 문서 품질에 달려 있다. 흐릿한 스캔이나 손글씨가 많으면 홍보하는 95% 아래로 떨어질 수 있다.
- 고급 처리는 사용량 기반 과금이라 자신의 작업량에 맞춰 가격을 따져야 한다.
- 공개 API 문서가 없어 자동화는 내보낸 파일에 기대야 한다.
자주 묻는 질문
PDF 파일에서 구조화 데이터를 추출한다. 문서를 올리면 내용을 Excel, CSV, JSON, 텍스트로 돌려주고 표와 레이아웃을 살려 두니 데이터를 바로 쓸 수 있다.
관련 콘텐츠
PDF Dino와 관련된 도구, 스킬, 아티클을 살펴보세요.
PDF Dino 대안

Base Code
Base44 (Wix) · 코딩 · 생산성Base Code는 Base44가 만든 공유 클라우드 개발 환경이다. 팀은 기존 GitHub 저장소에 대한 변경을 채팅으로 설명하고, 미리보기로 확인한 뒤 풀 리퀘스트로 돌려보낸다.

Google EmbeddingGemma 2
Google DeepMind · 글쓰기 · 이미지 · 코딩Google EmbeddingGemma 2는 7억 4000만 파라미터의 오픈 모델로, 텍스트와 코드, 이미지, 오디오, 영상 프레임을 하나의 768차원 공간에 벡터로 바꿔 스마트폰과 노트북에서 실행한다.

GitGlow
GitGlow · 코딩 · 생산성GitGlow는 내 코드와 AI 에이전트의 변경을 한 리뷰에 모으는 데스크톱 Git 클라이언트다. 배포 전에 내 기계에서 무엇이 나가는지 확인할 수 있다.