
PromptPerf
PromptPerf · 코딩
PromptPerf는 실제 프롬프트를 GPT, Claude, Gemini 등 100개 넘는 모델에서 실행하고 어느 모델이 가장 잘 답하는지 보여주는 테스트 플랫폼이다.
PromptPerf 소개
What Is PromptPerf
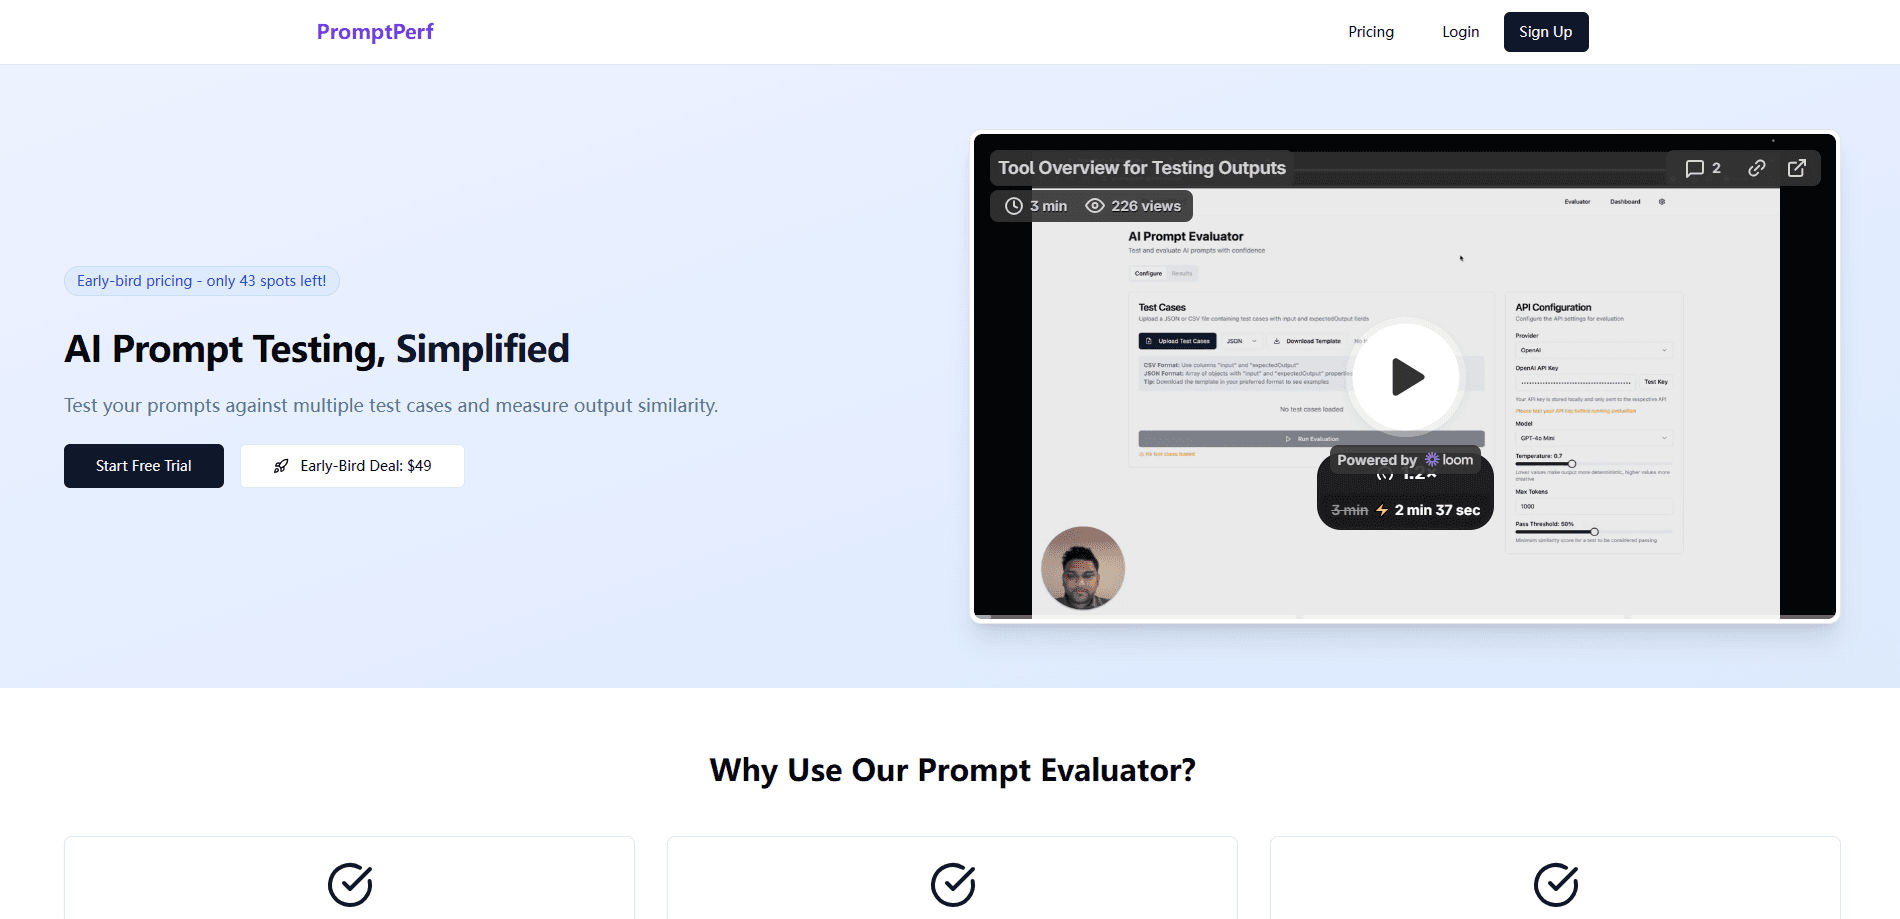
PromptPerf는 업무에서 AI 모델을 쓰면서 명성만 보고 모델을 고르는 데 지친 사람을 위한 웹 도구다. 예시 프롬프트를 쓰고 좋은 답이 어떤 모습인지 적으면, 그 프롬프트를 여러 모델에서 동시에 실행한다. 각 답은 기대한 답과 대조해 일치 점수를 받으므로, 짐작이 아니라 숫자로 뒷받침된 승자를 본다.
바탕에 깔린 생각은 범용 벤치마크가 자기 용도를 거의 말해주지 않는다는 것이다. 공개 순위에서 앞선 모델도 특정 작업에서는 더 싼 선택에 밀릴 수 있고, 이 AI 모델 비교 플랫폼은 그 차이를 자기 프롬프트에서 직접 잰다. 프롬프트 평가를 내 데이터로 할 수 있다는 점이 강점이다. 비용도 기록하므로, 작은 정확도 차이와 모델별 가격을 견줘 볼 수 있다.
주요 한계는 범위다. PromptPerf는 테스트와 비교 계층이지, AI 앱을 만들거나 배포하는 곳이 아니다. 연결된 호스팅 모델에서 작동하며, 팀 도구와 고급 분석 같은 깊은 기능은 상위 요금제에 있다.
Getting Started
- promptperf.dev의 평가 도구를 열고 예시를 최소 하나 추가한다. 자기 프롬프트와 좋은 모델이라면 돌려줄 답을 함께 넣는다.
- 예시를 더 넣거나 한꺼번에 올려, 테스트가 쉬운 경우 하나가 아니라 여러 입력을 다루게 한다.
- 비교할 모델을 두 개에서 네 개 고르거나 도구가 후보를 제안하게 하고, 더 엄격하거나 느슨하게 맞추고 싶으면 창의성과 합격 점수를 조정한다.
- 테스트를 실행하고 결과를 읽는다. 각 모델이 일치 점수로 순위가 매겨지고 각 선택의 상대 비용도 표시된다.
- 테스트를 저장하고 나중에 다시 실행해, 공급자 업데이트가 모델의 프롬프트 처리를 바꾼 시점을 잡아낸다.
제품 정보
PromptPerf의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- 데이터 과학자 없이 일하는 개인 개발자와 작은 팀. 참고 순위표를 읽는 대신 자기 예시로 모델을 비교한다. 무료 요금제는 테스트당 몇 개의 예시를 다룬다.
- 운영 중인 기능을 위해 모델을 고르는 제품 및 지원 책임자. 기능이 실제로 필요로 하는 답에 연결된 점수를 얻는다. 코딩도 API 설정도 필요 없다.
- AI 청구서를 신경 쓰는 개발자. PromptPerf는 더 싼 모델을 더 강한 모델 옆에 놓아, 작은 정확도 희생과 절감액을 견줄 수 있게 하고 내 작업에 맞는 AI 모델을 범용 표에 기대지 않고 찾게 해준다.
작업
- 그 위에 기능을 올리기 전에 모델 고르기. 프롬프트 테스트 도구로 작업에 맞는 프롬프트를 돌려, 어느 모델이 기대한 출력과 가장 자주 맞는지 본다.
- 모델 업데이트 후에도 프롬프트가 작동하는지 확인하기. 테스트를 저장하고 공급자가 새 버전을 내면 다시 실행한다.
- 무료와 유료 선택 비교하기. 같은 예시를 DeepSeek와 Meta의 무료 모델, 유료 모델에서 돌려 차이가 가격을 정당화하는지 본다.
활용 상황
- 어떤 작업에 ChatGPT, Claude, Gemini 중 무엇을 쓸지 망설이기. 같은 프롬프트를 셋에서 돌려 일반적 평판이 아니라 점수로 결정한다.
- 요구사항이 빠르게 바뀌는 초기 프로토타입 단계. 예시가 바뀔 때마다 저장한 테스트를 다시 돌려, 테스트 환경을 새로 짓지 않는다.
- AI 기능을 확장하기 전의 예산 검토. 비용 열을 보고 호출당 더 싼 선택이 얼마를 아낄지 확인한다.
주요 기능
Multi Model Prompt Testing
이 모델 비교 도구는 한 번의 실행에서 두 개에서 네 개 모델을 맞붙인다. GPT, Claude, Gemini는 물론 DeepSeek와 Meta의 무료 모델도 넣을 수 있다. 모든 모델이 같은 예시에 답하므로 입력이 일정하게 유지되고, 선택지 사이의 프롬프트 성능 테스트가 공정해진다. 프롬프트 평가란 같은 질문을 고정한 채 모델만 바꿔 답의 차이를 보는 작업이다.
Match Score Against Your Expected Answer
출력을 눈대중으로 판단하는 대신, 좋은 답이 어떤 모습인지 적으면 PromptPerf가 각 답을 그것과 견줘 점수를 매긴다. 합격 점수 기준으로 그 대조를 얼마나 엄격하게 할지 정할 수 있다.
Cost Visibility Next to Accuracy
결과는 각 모델의 상대 가격을 점수 옆에 보여준다. 정확도와 비용의 맞바꿈이 분명해지는데, 두 모델의 작은 차이가 큰 지출 차이로 이어질 때 특히 중요하다.
Saved Tests and Re-runs
테스트를 저장하고 언제든 다시 실행할 수 있다. 한 번뿐인 비교가 반복 가능한 점검으로 바뀌어, 공급자가 모델을 업데이트한 뒤의 성능 저하를 잡아낸다.
Bulk Example Upload
프롬프트 하나만 시험하는 대신 예시를 묶음으로 불러와, 한 번의 테스트가 많은 입력을 다루게 한다. 무료 요금제는 테스트당 최대 다섯 개까지 허용하고, 유료 요금제는 이 상한을 없앤다.
No Code and No API Setup
PromptPerf는 지원 모델에 닿는 데 필요한 API 키를 갖추고 있어, 자기 계정을 연결하거나 스크립트를 쓸 필요가 없다. 프롬프트를 붙여 넣고 모델을 고르면 결과를 읽을 수 있다.
장단점
장점
- 범용 공개 벤치마크에 기대지 않고 자기 프롬프트로 시험한다.
- 비용 정보를 정확도 옆에 보여줘, 싼 모델도 공정하게 검토된다.
- 무료 요금제는 가입 없이 빠른 비교에 쓸 수 있고, 무료 계정은 한도를 높인다.
- 저장한 테스트 덕분에 모델 업데이트 후 프롬프트를 다시 확인하기 쉽다.
- 코딩도 API 설정도 없어 비엔지니어의 진입 장벽이 낮다.
단점
- 비교와 프롬프트 테스트 도구에 그쳐, 그 안에서 앱을 만들거나 배포할 수는 없다.
- 점수는 사용자가 적는 기대 답에 달려 있어, 예시가 약하면 신호도 약해진다.
- 팀 기능과 고급 분석은 가장 싼 요금제에 없다.
자주 묻는 질문
PromptPerf는 프롬프트를 100개 넘는 AI 모델에서 실행하고, 각 답이 기대한 답과 얼마나 맞는지 점수를 매긴다. 그다음 모델을 순위로 정리해, 특정 작업에서 가장 잘하는 모델을 고를 수 있게 한다.
관련 콘텐츠
PromptPerf와 관련된 도구, 스킬, 아티클을 살펴보세요.
PromptPerf 대안
Forefront
Forefront · 코딩Forefront는 오픈소스 AI로 무언가를 만드는 웹 플랫폼이다. 대표적인 오픈소스 언어 모델을 자신의 데이터로 미세 조정하고, 성능을 평가하고, API로 실행하거나 내보내 직접 호스팅할 수 있다. 폐쇄형 플랫폼의 편의를 원하면서도 모델과 데이터의 소유권은 놓지 않으려는 개발자가 대상이다.

Startkit
StartKit.AI · 코딩Startkit은 AI SaaS와 AI 래퍼 제품을 만들기 위한 보일러플레이트다. 지루한 부분을 미리 연결해 둔 AI 스타트업 보일러플레이트라고 생각하면 된다. 인증, Stripe와 Lemon Squeezy 결제, 사용량 제한, 트랜잭션 이메일, 그리고 OpenAI, Anthropic, Groq, Llama와 통신하는 AI API 스타터 키트가 포함된다. 저장소를 복제하고 가격을 정한 뒤 사용자가 실제로 돈을 내는 부분에 착수하면 된다. React와 Tailwind 위의 Next.js로 만들어졌기 때문에 보일러플레이트 코드의 상당 부분이 이미 익숙하게 느껴진다.
Testim
Tricentis · 코딩Testim은 웹, 모바일, Salesforce 애플리케이션 전반에 걸쳐 엔드투엔드 테스트를 만들고 실행하는 AI 기반 테스트 자동화 플랫폼이다. 머신러닝에 기대어 인터페이스가 바뀌어도 테스트를 안정적으로 유지하므로, 팀은 깨진 셀렉터를 고치는 데 쓰는 시간을 줄인다. 오늘부터 쓸 수 있는 자동화 테스트 도구치고 나쁘지 않다. 브라우저에서 동작을 녹화해 테스트를 만들고, 더 세밀한 제어가 필요하면 JavaScript를 더한다. 바쁜 QA 팀에게 탄탄한 선택이다.