

QAgent
QAgent Inc. · 코딩 · 비즈니스
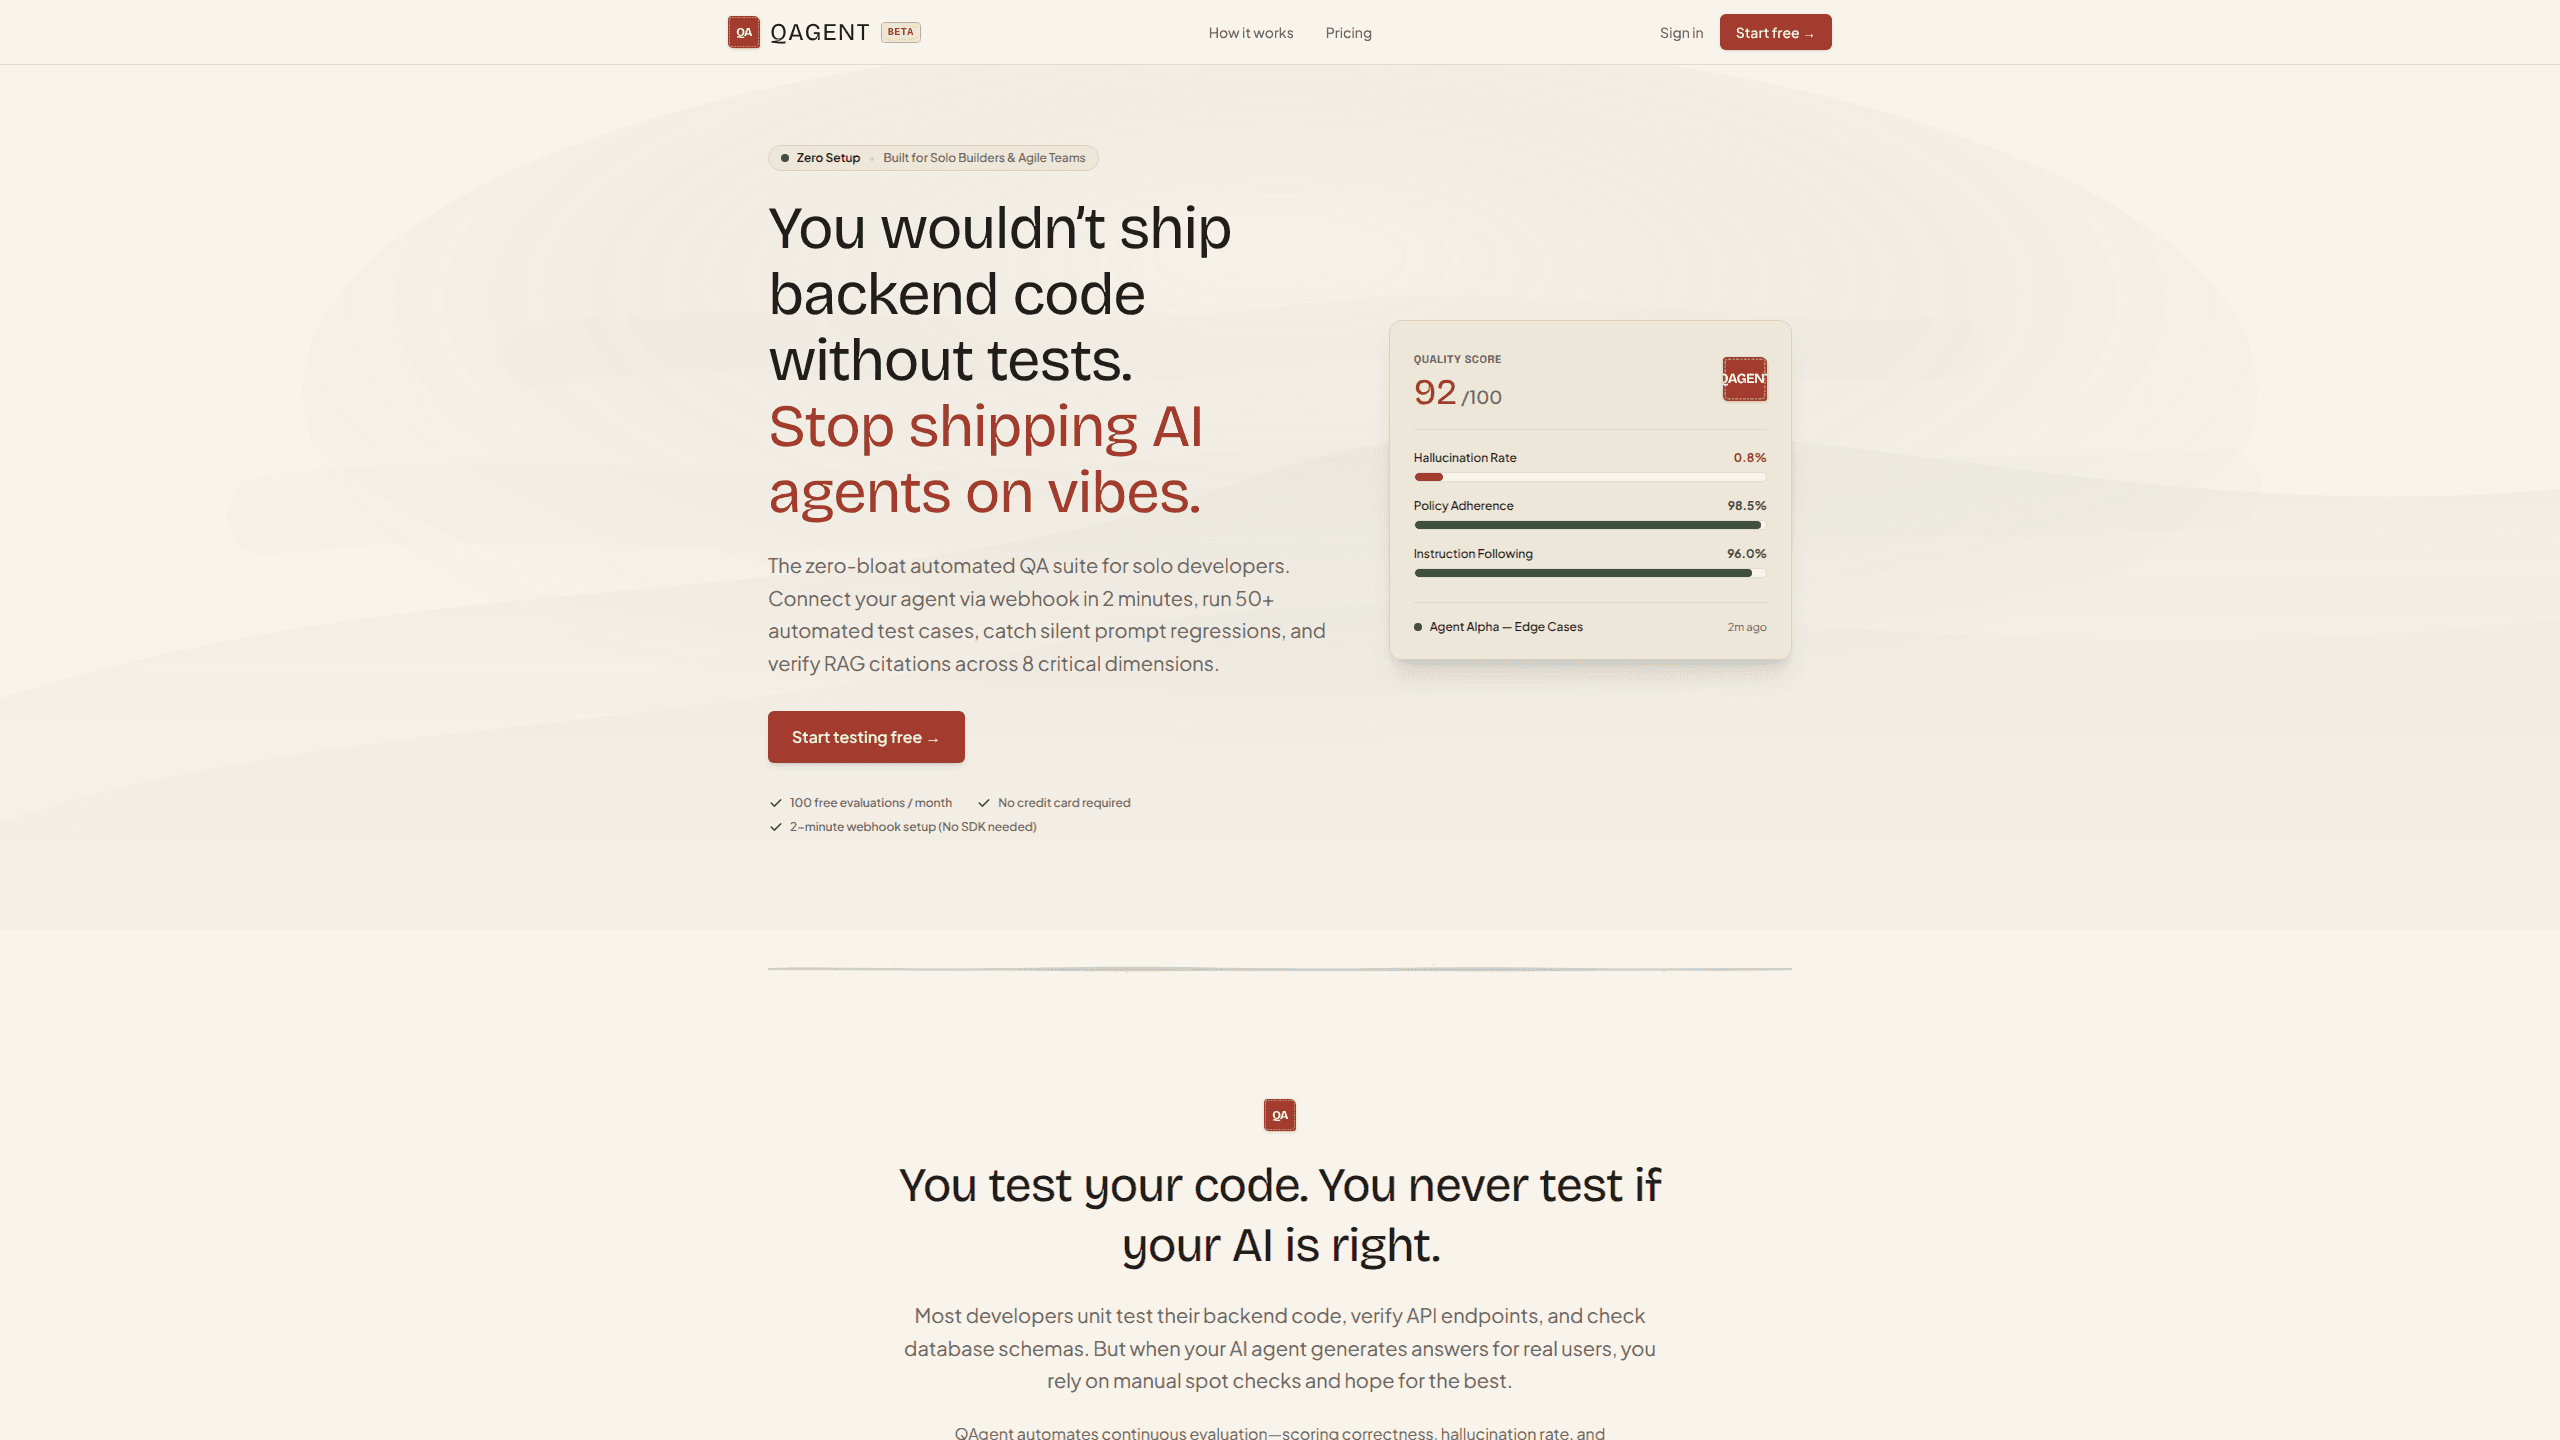
QAgent는 AI 에이전트를 위한 자동화된 품질 보증 플랫폼이다. 에이전트의 엔드포인트를 지정하고 지켜야 할 기준 사실을 정의하면, 릴리스마다 답변 품질, 환각률, 정책 준수, 멀티턴 기억을 채점하는 테스트 스위트를 실행한다. 누구나 몇 분 만에 돌릴 수 있는 LLM 평가 도구로 동작한다. 전담 QA 부서 없이 에이전트를 출시하는 개인 개발자와 소규모 팀을 위해 만들어졌다.
QAgent 소개
QAgent란 무엇인가
QAgent는 대부분의 AI 개발자가 건너뛰는 질문에 답하는 웹 기반 테스트 플랫폼이다. 당신의 에이전트가 정말 정확한 답변을 내놓는가? 플레이그라운드에서 몇 개의 응답을 읽고 잘 되기를 바라는 대신, 에이전트를 연결하고 프롬프트를 바꿀 때마다 같은 검증 묶음을 QAgent가 실행하게 한다.
이 제품은 특정한 공백을 겨냥한다. 개발자는 백엔드 코드를 단위 테스트하고 API 엔드포인트를 검증한다. 그런데 LLM이 실제 사용자를 위해 답변을 생성하는 순간, 품질 점검은 수작업 표본 확인으로 변한다. 이건 문제다. QAgent는 에이전트 출력을 테스트 가능한 대상으로 취급하고, 그 순간 그럴듯하게 들리는지가 아니라 당신이 쓴 규칙에 비추어 채점한다.
주된 한계는 범위에 있다. QAgent가 평가하는 것은 정확성, 안전성, 일관성이다. 프롬프트를 대신 고쳐주지 않으며, 채점은 당신이 제공한 기준 사실의 품질을 넘지 못한다. 그러니 진짜 규칙을 써야 한다. 환불 정책이나 가격 등급이 정의되어 있지 않으면 심판 모델이 대조할 대상이 없다.
시작하기
- 무료 계정을 만들고 webhook 엔드포인트, LangChain 워크플로 또는 단순한 HTTP POST 대상으로 에이전트를 연결한다.
- 기준 사실을 정의한다. 가격 등급, 환불 기간, 금지 주제, 에이전트가 지켜야 할 모든 지식 문서다.
- 프롬프트와 기대 동작을 짝지은 테스트 루브릭을 작성한다. 명확한 '반드시'와 '금지' 규칙을 쓴다.
- 스위트를 실행하고 통과 또는 실패 평가와 각 실패의 단계별 근본 원인을 검토한다.
- 같은 스위트를 릴리스 흐름에 연결해 배포 전에 프롬프트 편집이 다시 채점되게 한다.
제품 정보
QAgent의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- 개인 개발자
- QA 담당자를 뽑지 않은 소규모 팀
- 프리랜서와 에이전시
작업
- 환각 잡아내기
- 프롬프트 회귀 추적
- RAG 인용 검증
- 멀티턴 기억 테스트
활용 상황
- 한 고객의 예외 사례를 고치려는 심야의 프롬프트 조정과, 그 뒤 약 1분 만의 완전한 회귀 실행.
- AI 챗봇을 고객에게 넘기며 사실 근거성과 정책 준수를 보여주는 스코어카드를 첨부하기.
- 직감이 아니라 자동 평가 결과로 배포 릴리스를 판단하기.
- 적대적 입력을 시험해 에이전트가 줄 수 없는 할인을 약속하는 대신 사람에게 에스컬레이션하는지 확인하기.
주요 기능
8가지 평가 차원
QAgent는 하나의 모호한 점수 대신 8개의 개별 지표로 에이전트를 채점한다. 이들은 답변 품질, 사실 근거성, 정책 준수, 에스컬레이션 정확성, RAG 충실성, 문맥 관련성, 문맥 재현율, 멀티턴 기억을 포괄하며, 각 차원이 실제 프로덕션 실패 모드에 대응한다. 이 세부사항이 중요하다. 낮은 숫자는 막연한 분위기가 아니라 구체적인 문제를 가리킨다.
결정론적 LLM 심판 채점
문자열이나 정규식 패턴을 대조하는 대신, QAgent는 보정된 심판 모델로 각 응답을 심문한다. 속도를 위해 Groq LPU에서 돌아가는데, 완전한 회귀 스위트를 1분 안에 끝내고 싶을 때 중요하다. 통과와 실패 판정에는 신뢰 수준이 붙어서, 결과가 경계선에 가까워 믿기 전에 수작업으로 더 볼 가치가 있는 때를 알 수 있다.
기준 사실과 루브릭 시스템
모든 테스트는 세 가지 재료를 결합한다. 당신의 공식 규칙, RFC 2119 스타일의 기대 동작을 담은 테스트 프롬프트, 에이전트의 실시간 응답이다. 심판은 루브릭에 엄격하게 대조해 확인한다. 정중하지만 틀린 답변은 여전히 실패한다. 이것이 QAgent와 채팅 창에서의 느낌 점검을 가르는 차이다.
오탐을 위한 스마트 예외
심판은 환각과 정상 동작의 차이를 안다. 세션마다 바뀌는 티켓 ID, 실시간 잔액, 정중한 인사는 근거 없는 주장으로 표시되지 않는다. 좋다. 최상위 검색 청크가 완전한 답을 담고 있으면 하위 결과가 점수를 끌어내리지 않는다. 탈옥 테스트는 공격 문서가 없다고 검색기에게 페널티를 주지 않는다.
프롬프트 회귀 추적
QAgent는 프롬프트 반복마다 점수 차이를 기록한다. 한 사례를 고친 변경이 다른 곳에서 하락을 일으켰는지 즉시 보인다. 바로 그게 핵심이다. 시스템 프롬프트를 자주 편집하는 팀에게 이것은 조용한 성능 저하를 차트 위에 보이는 선으로 바꾼다.
품질 감사 보고서
Solo 플랜은 CSV와 인쇄 가능한 품질 감사 보고서를 내보낸다. 근거성 비율, RAG 충실성, 정책 준수를 보여주며, 고객이 약속이 아니라 증거를 원할 때 유용하다. 파일을 보내면 된다. 보고서는 테스트 실행을 프로젝트 인도에 첨부할 수 있는 무언가로 바꾼다.
장단점
장점
- webhook 설정은 약 2분이 걸리고 설치할 SDK도 쓸 상용구 코드도 없다.
- 이름이 붙은 8가지 차원이 하나로 섞인 점수 대신 구체적인 피드백을 준다.
- 월 100회 평가가 포함된 무료 등급 덕분에 결제 전에 시험해보기 쉽다.
- 투명한 감사 추적이 각 테스트의 질의, 루브릭, 응답, 평가자 소견을 보여준다.
- 연간 약정도 영업 전화도 없는 정액 월간 가격.
단점
- 무료 플랜에서 연결되는 에이전트 엔드포인트는 하나뿐이라, 여러 에이전트를 테스트하려면 유료 등급이 필요하다.
- 채점은 전적으로 당신이 제공한 기준 사실에 달려 있다. 모호한 규칙은 모호한 결과를 낳는다.
- 플랫폼이 아직 베타라서 기능과 한도가 바뀔 수 있다.
자주 묻는 질문
당신의 AI 에이전트가 정확하고 정책을 준수하는 답변을 내놓는지 테스트한다. 환각 탐지, 지시 따르기, RAG 충실성, 에스컬레이션 동작, 멀티턴 기억을 아우르며 8가지 차원으로 채점한다.
관련 콘텐츠
QAgent와 관련된 도구, 스킬, 아티클을 살펴보세요.
QAgent 대안

Base Code
Base44 (Wix) · 코딩 · 생산성Base Code는 Base44가 만든 공유 클라우드 개발 환경이다. 팀은 기존 GitHub 저장소에 대한 변경을 채팅으로 설명하고, 미리보기로 확인한 뒤 풀 리퀘스트로 돌려보낸다.

Google EmbeddingGemma 2
Google DeepMind · 글쓰기 · 이미지 · 코딩Google EmbeddingGemma 2는 7억 4000만 파라미터의 오픈 모델로, 텍스트와 코드, 이미지, 오디오, 영상 프레임을 하나의 768차원 공간에 벡터로 바꿔 스마트폰과 노트북에서 실행한다.

GitGlow
GitGlow · 코딩 · 생산성GitGlow는 내 코드와 AI 에이전트의 변경을 한 리뷰에 모으는 데스크톱 Git 클라이언트다. 배포 전에 내 기계에서 무엇이 나가는지 확인할 수 있다.