
Vogent Voicelab
Vogent · 음성 및 언어 · 코딩
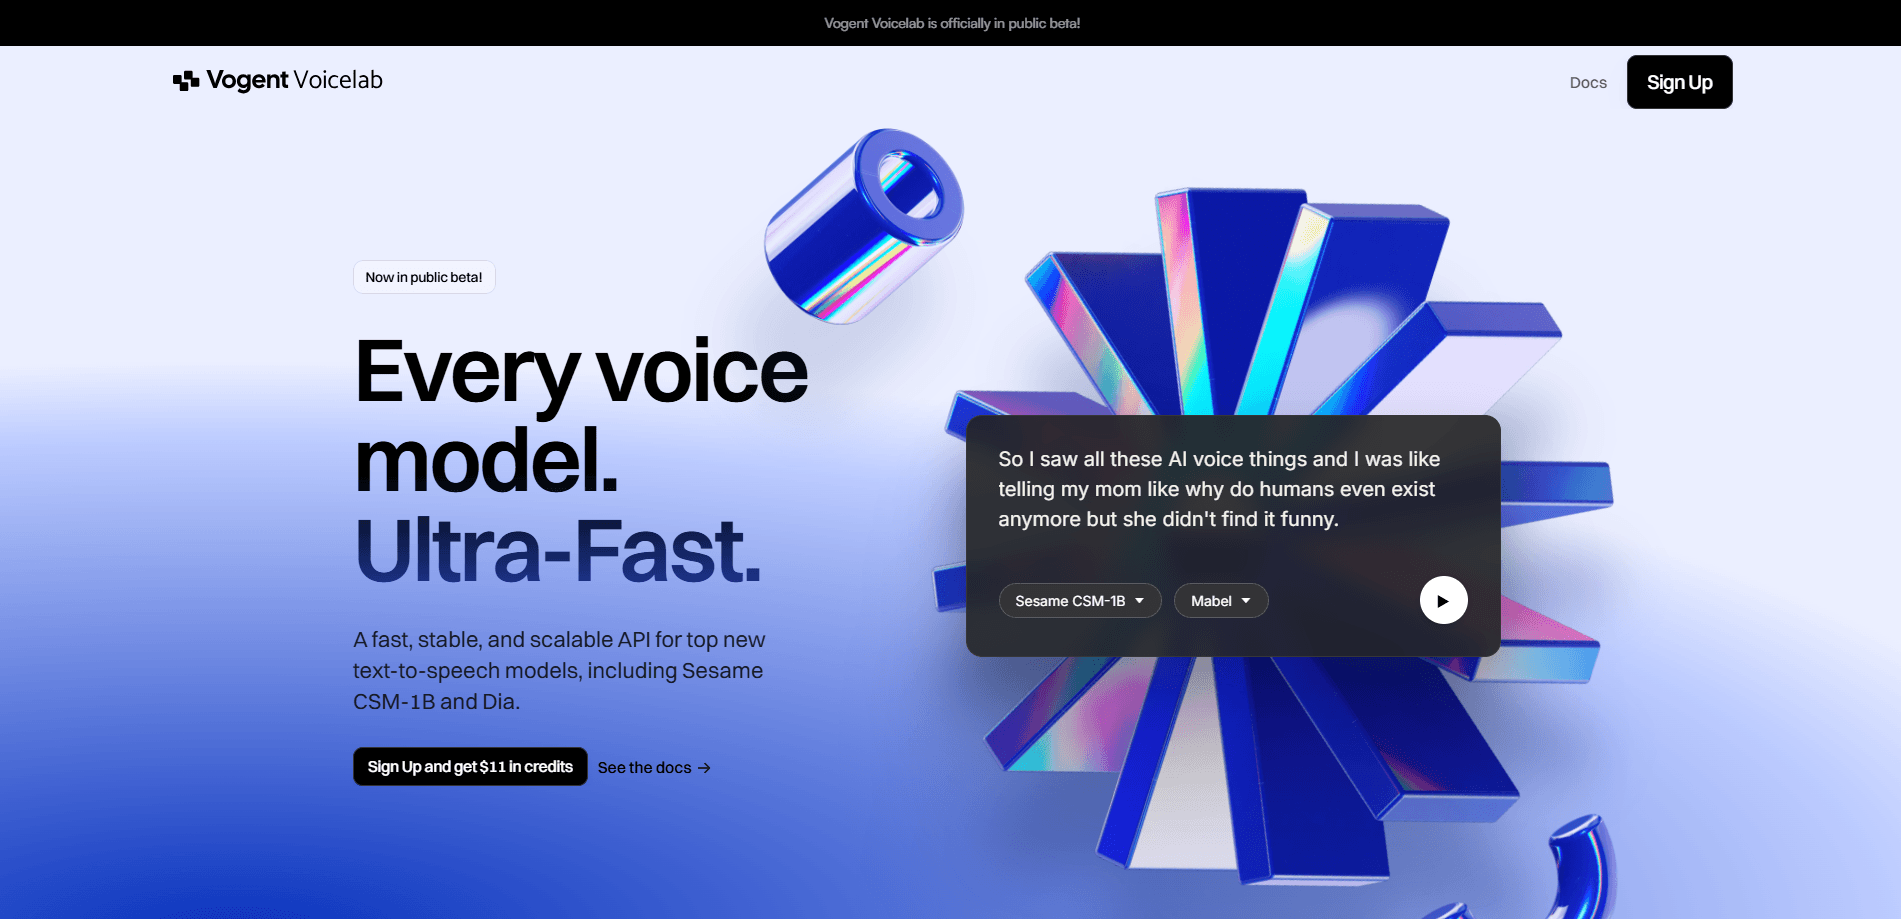
Vogent Voicelab은 Sesame CSM-1B, Dia 같은 오픈소스 음성 모델을 빠르고 저렴한 하나의 엔드포인트로 실행하는 텍스트 음성 변환 API다. 짧은 음성 클립만으로 목소리를 복제한다.
Vogent Voicelab 소개
What Is Vogent Voicelab
Vogent Voicelab은 최상위 오픈소스 텍스트 음성 변환 모델을 돌리는 API다. 음성 벤치마크 상위에 늘 오르는 모델들을 직접 GPU를 세우지 않고 쓸 수 있다. 텍스트를 엔드포인트로 보내고 목소리를 고르면 오디오가 돌아온다. 할 일은 그게 전부이며, 관리할 구독을 하나 더 늘리고 싶지 않은 개발자를 겨냥한다.
끌리는 건 모델이다. Sesame의 CSM-1B는 자연스러운 주고받기 대화를 잘 다루고, Dia는 일반 텍스트를 읽으며 웃음이나 한숨 같은 감정 태그도 받는다. Orpheus는 감정 표현을 더 밀어붙인다. 몇 주마다 새 오픈소스 목소리가 나오고, Voicelab은 늘 갱신되는 목록을 유지해 스택을 고치지 않고 최신 모델을 시험하게 해준다.
미리 알아둘 조건도 있다. 일부 모델은 아직 후학습을 거치지 않아 생성마다 품질이 흔들릴 수 있고, 지금 라인업은 거의 영어가 먼저다. Voicelab은 근본적으로 개발자 도구라, 값어치는 음성을 앱에 붙일 때 드러난다. 한 문장을 빨리 읽어주길 원할 때가 아니다.
Getting Started
- app.vogent.ai에서 가입하고 사이드바의 API 항목에서 무료 키를 받는다.
- 라이브러리에서 목소리를 고르거나 15~20초 클립을 올려 자기 목소리를 복제한다.
- 텍스트와 voiceId를 TTS 엔드포인트로 POST 전송하고 돌아온 오디오 파일을 저장한다.
- 두 사람의 대화가 필요하면 multispeaker 엔드포인트로 바꿔 줄마다 다른 목소리를 지정해 넘긴다.
- 실시간 앱에서는 WebSocket 경로를 열어 문장이 끝나기 전에 소리가 나도록 텍스트를 스트리밍한다.
제품 정보
Vogent Voicelab의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- 앱 개발자
- 개인 개발자와 스타트업
- 대화형 AI를 얹으려는 제품 팀
작업
- 데모와 영상용 내레이션 만들기
- 두 사람의 대화 만들기
- 특정 목소리 복제
- 살아 있는 앱에 음성 흘려보내기
활용 상황
- 정하기 전에 여러 음성 모델을 시험
- 빠듯한 예산으로 음성 파일럿 운영
- 내레이션 한 편에서 동시 다수 에이전트로 확장
주요 기능
여러 음성 모델을 하나의 API로
Voicelab은 CSM-1B, Dia, Orpheus와 계속 늘어나는 오픈소스 모델을 같은 엔드포인트 뒤에 둔다. 호출 방식을 바꾸지 않고 모델을 갈아 끼운다. 더 좋은 목소리가 나올 때마다 연동을 다시 짤 필요가 없다. 이 분야에서는 그런 일이 자주 벌어진다.
즉시 음성 복제
15~20초 녹음을 올리면 Voicelab이 그 목소리의 쓸 만한 복제본을 만든다. 대부분의 프로젝트에 이걸로 충분하며, 공식 문서는 원본에 가까워지려면 매끈하게 다듬은 낭독보다 자연스러운 대화 클립을 권한다. 복제를 피하고 싶으면 전문 성우 목소리가 미리 학습돼 있기도 하다.
사실적인 대화 음성
CSM-1B는 읽어주기 전용이 아니라 대화를 위해 만들어졌다. 실제 대화의 작은 주고받기를 받쳐 주고, 긴 생성에서도 목소리가 안정적이다. 사람이 말을 거는 어시스턴트를 제품에 둔다면 이 모델부터 시작한다.
다중 화자 대화
전용 엔드포인트가 대사 목록을 완성된 대화로 만든다. 줄마다 각자의 목소리가 붙는다. 두 화자가 한 파일에서 번갈아 말한다. 인터뷰, 팟캐스트, 캐릭터 장면을 오디오를 손으로 붙이지 않고 만든다.
WebSocket 실시간 스트리밍
실시간 용도를 위해 Voicelab은 텍스트를 흘려보내고 생성되는 대로 오디오 조각을 돌려주는 WebSocket 경로를 연다. 앱은 전체 응답이 쓰이기 전에 말을 시작한다. 챗봇과, 끊기면 흐름이 깨지는 모든 경험에서 이게 중요하다.
감정 태그와 미세 조정
Dia와 Orpheus는 한숨이나 작은 웃음 같은 태그를 받아, 평평한 낭독이 아니라 감정 쪽으로 읽기를 끌어간다. 상위 플랜에서는 자기 데이터로 목소리를 미세 조정하고 호스팅한다. 복사만 하는 게 아니라 스타일을 바꿀 만큼 깊다.
장단점
장점
- 하나의 API로 여러 앞선 오픈소스 음성 모델을 아우른다. 계정을 따로 만들지 않고 시험한다.
- 무료 플랜에 180분 음성, API 접근, 음성 복제가 포함된다.
- 즉시 복제는 짧은 클립만 요구해 맞춤 목소리가 손 닿는 곳에 있다.
- 분당 요금은 플랜이 올라갈수록 내려간다. 약 6센트에서 3센트로.
- 스트리밍, 다중 화자, 감정 태그가 기본으로 들어 있다. 따로 사는 옵션이 아니다.
단점
- 모든 모델이 후학습을 거친 건 아니라 생성마다 품질이 달라진다.
- 지금은 대부분 모델이 영어 중심이라 다른 언어는 영어 출력에 기댄다.
- 개발자 도구라 한 문장 빠르게 읽히는 끌어다 놓기 편집기는 없다.
- 맞춤 학습 목소리와 온프레미스 배포는 문의가 필요한 Business 플랜 안쪽에 있다.
자주 묻는 질문
Sesame CSM-1B, Dia, Orpheus 같은 오픈소스 텍스트 음성 변환 모델을 돌리는 API다. 텍스트를 보내고 목소리를 고르면 오디오가 돌아온다. 모델을 직접 호스팅할 필요는 없다.
관련 콘텐츠
Vogent Voicelab와 관련된 도구, 스킬, 아티클을 살펴보세요.
Vogent Voicelab 대안

Foley
Hanamori Labs, LLC · 음성 및 언어 · 생산성 · AI 어시스턴트Foley는 음성 할 일 목록이다. 말한 한 문장을 프로젝트와 날짜, 시간까지 붙은 작업으로 정리하고, 그다음에는 이미 있는 목록을 기준으로 하루 순서를 짠다.

HireKey
HireKey · 음성 및 언어 · 생산성 · 학습HireKey는 테크 업계 리크루터가 만든 AI 구직 코파일럿이다. 직무 적합도 분석, 이력서 맞춤화, 면접 연습, 지원 현황 관리를 한 화면에 모은다.

Fluence
Yay Software (Yannick Huchard) · 글쓰기 · 음성 및 언어 · 생산성Fluence는 Android용 문서 리더다. PDF, EPUB, Word 파일과 웹 글을 소리 내어 읽고, 읽는 문장을 화면에서 따라가며, 본문에 대한 질문에 기기 안에서 답한다.