A Liquid AI lançou dois modelos abertos que não escrevem texto nem geram tokens. Eles respondem em um único passo, pensados para rodar em placas pequenas.
O que a Liquid AI lançou com os modelos d1
A Liquid AI publicou dois modelos com pesos abertos: o d1-3B e o experimental d1-omni-600M. A diferença em relação aos modelos generativos comuns é a forma como eles respondem. Em vez de produzir uma frase ou um parágrafo, eles devolvem uma decisão direta, sem gerar texto.
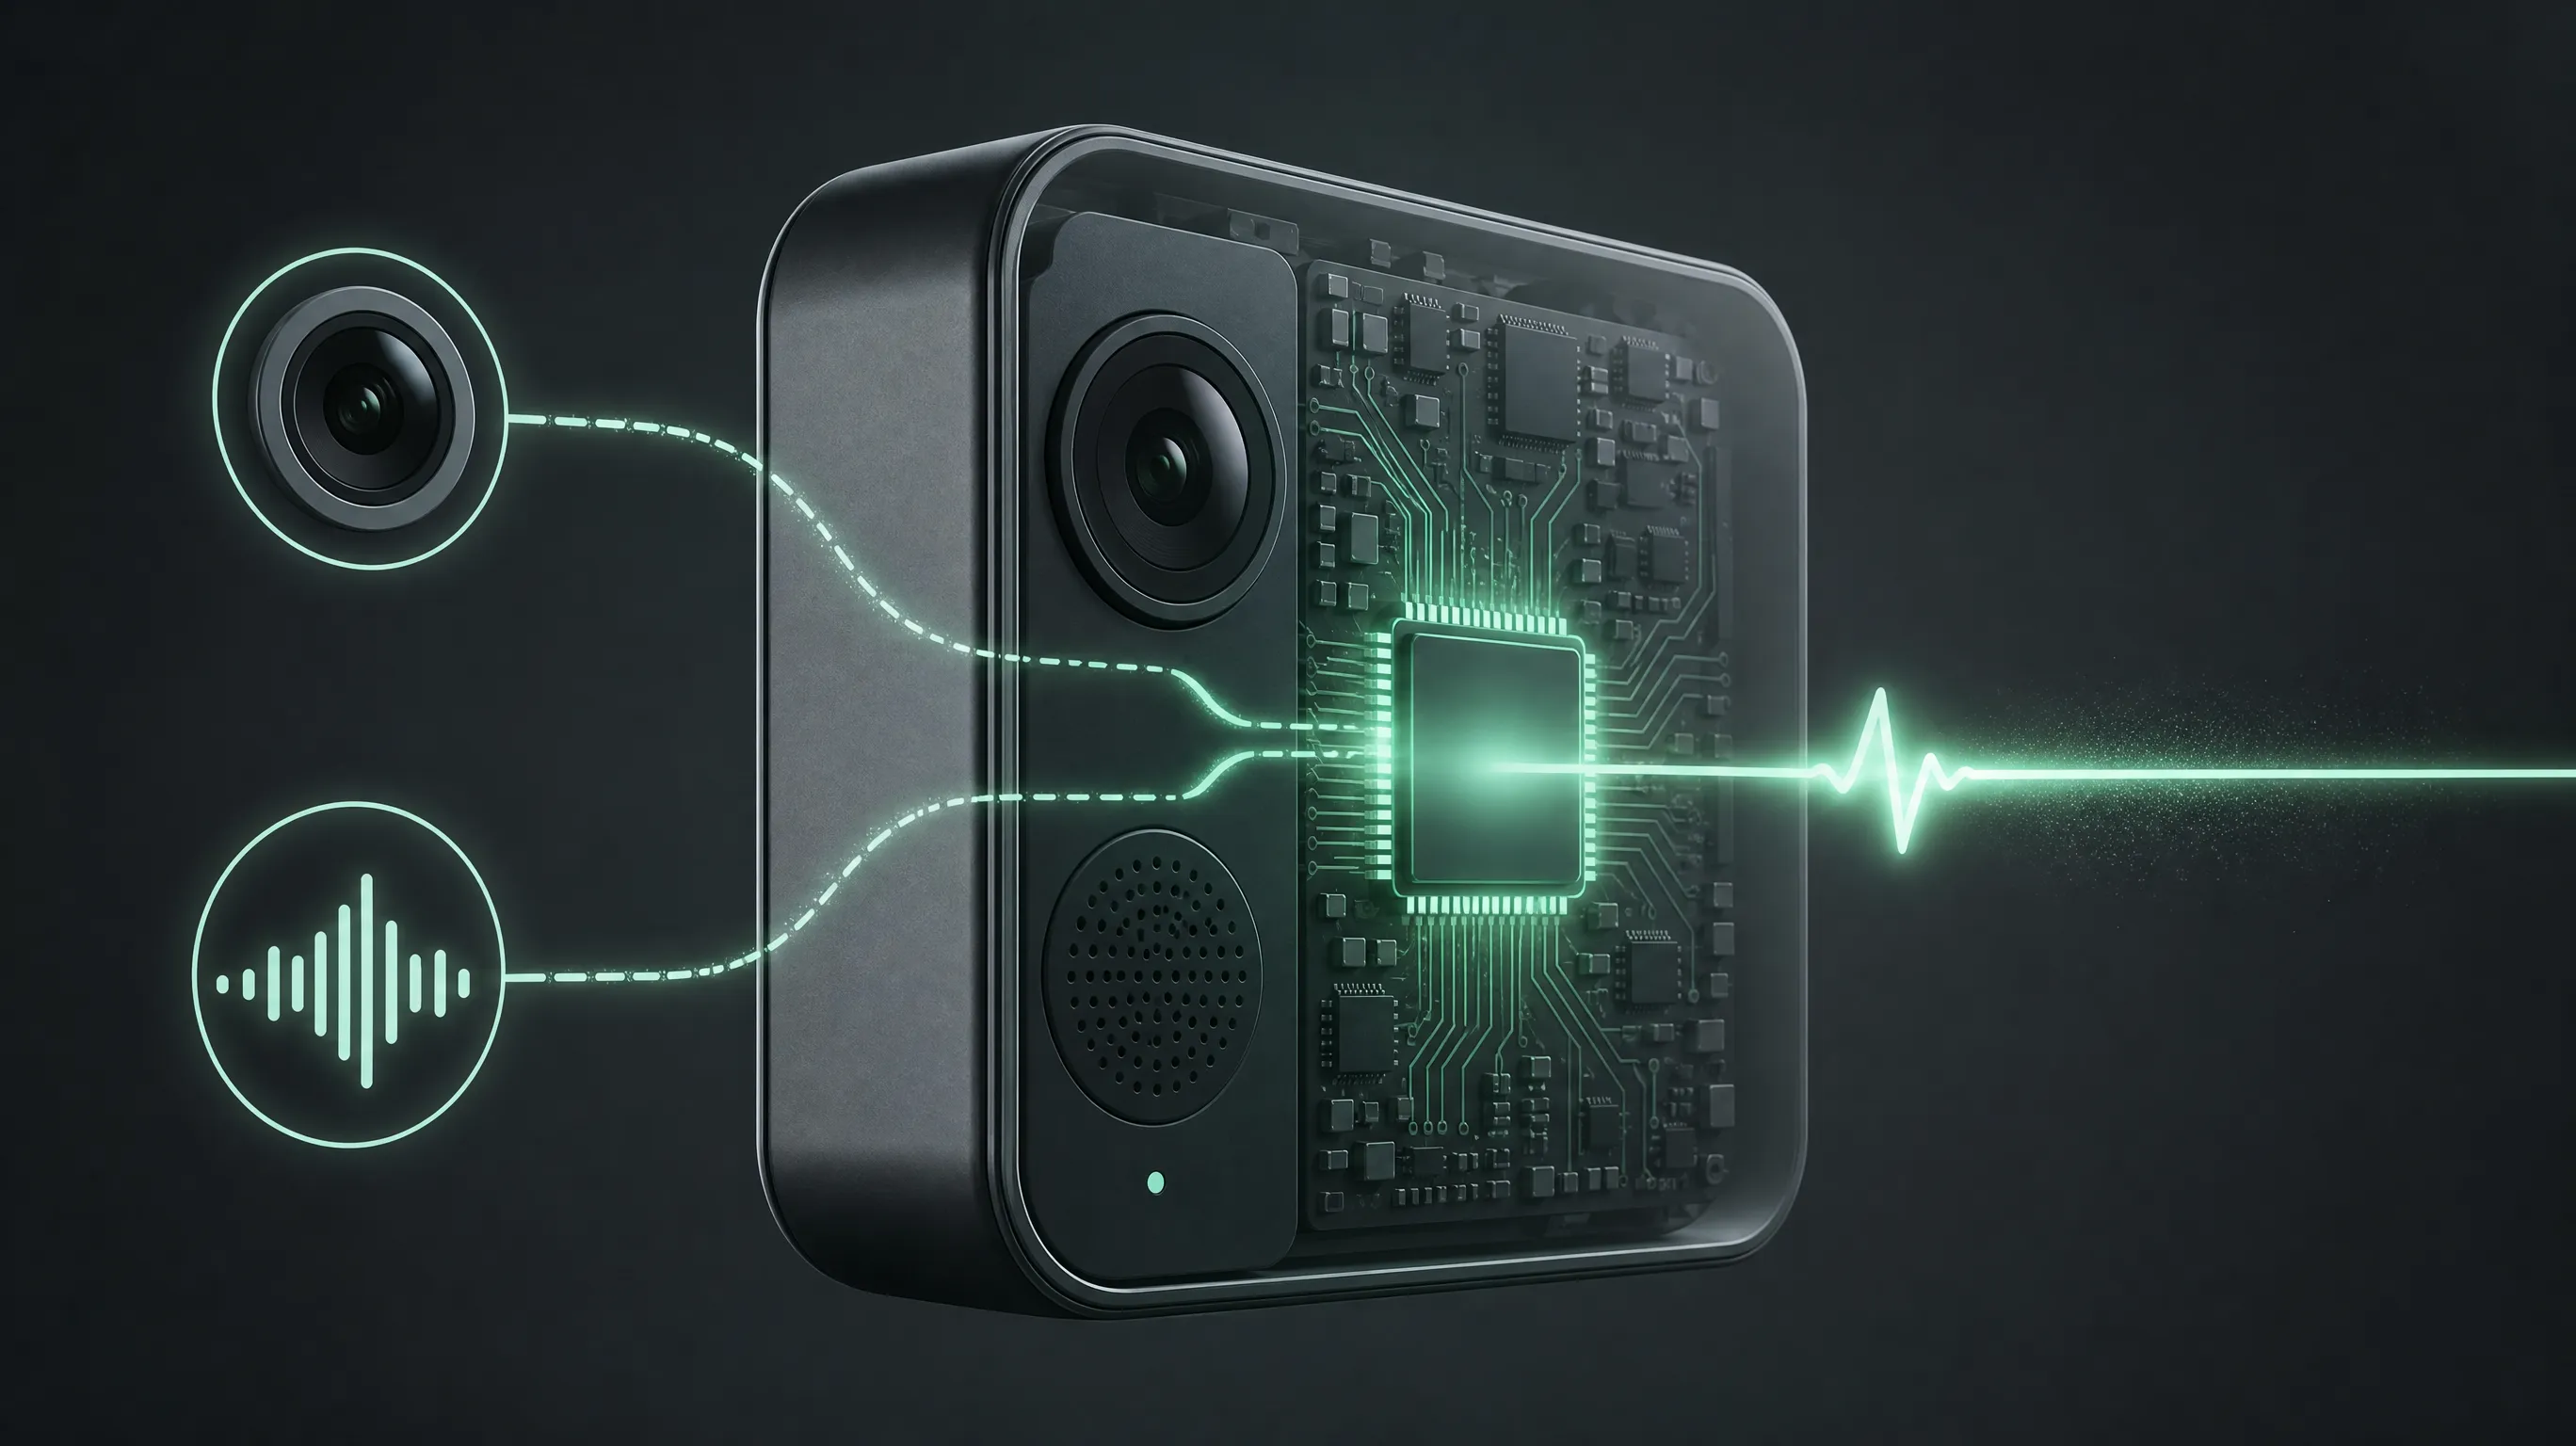
A empresa explica que essa é a proposta da família d1. Um modelo generativo tradicional produz tokens, ou seja, pedaços de texto, um atrás do outro. Os modelos de decisão da Liquid AI dão a resposta de uma vez, em uma passagem única pela rede, o que a empresa chama de single forward pass.
Na prática, isso serve para tarefas fechadas: classificar, decidir entre opções, responder sim ou não. Não é um modelo para conversar nem para redigir conteúdo.
d1-3B e d1-omni-600M: as diferenças entre os dois
Os dois modelos têm origens diferentes. O d1-3B herda do LFM2.5-VL-3B, que trabalha com texto e imagens. Já o d1-omni-600M parte do LFM2.5-Encoder-350M, um modelo do tipo encoder, com codificadores extras para visão e áudio.
Isso muda o que cada um consegue processar. O d1-omni-600M lê texto acompanhado de uma imagem ou de um áudio, o que abre espaço para tarefas em que o som é a informação principal. O d1-3B opera com texto e imagens.
Ambos estão disponíveis no Hugging Face, nas páginas LiquidAI/d1-3b e LiquidAI/d1-omni-600M, com documentação em docs.liquid.ai.
Desempenho e latência: o que a Liquid AI afirma
Aqui entra um ponto importante de cautela. Os números de desempenho são relatados pela própria Liquid AI e não passaram por verificação independente.
Segundo a empresa, o d1-3B alcança 48,57 pontos no Decision Index v0.2.1, na divisão pública. A Liquid AI diz que essa pontuação fica acima de todos os modelos com menos de 10 bilhões de parâmetros e empata com o Decider 35B-A3B, que é cerca de 12 vezes maior.
A latência é o argumento central da proposta. A Liquid AI afirma que o d1-3B responde em 8 milissegundos em uma RTX 4090, em 16 ms no Jetson AGX Thor, em 26 ms no Jetson AGX Orin e em 50 ms no Jetson Orin Nano. O d1-omni-600M, por sua vez, soma 15,95 pontos no mesmo índice, segundo a empresa.
O que os modelos entregam
- Resposta em uma única passada, sem gerar tokens
- Versões para texto, imagem e áudio
- Pesos abertos no Hugging Face
O que ainda depende da própria empresa
- Todos os números de benchmark
- As medições de latência
- A comparação com modelos maiores
O que modelos de decisão mudam para desenvolvedores
A aposta da Liquid AI é diferente da corrida por chatbots maiores. Modelos de decisão são úteis quando o objetivo é automatizar uma escolha, não manter uma conversa. Um sistema que precisa aprovar uma transação ou separar uma imagem por categoria não ganha nada com texto explicativo, e sim com uma resposta rápida e objetiva.
Rodar isso em placas pequenas, como as da linha Jetson, aponta para um uso específico: dispositivos na borda da rede, que processam dados no próprio local em vez de enviá-los para a nuvem. A latência baixa importa quando a decisão precisa acontecer na hora.
Vale acompanhar como a comunidade vai testar os dois modelos fora do ambiente controlado da empresa. É nesse momento, quando gente de fora reproduz os números, que a proposta de decisão em passada única mostra se sustenta.