
BrowserAct
BrowserAct · Programação
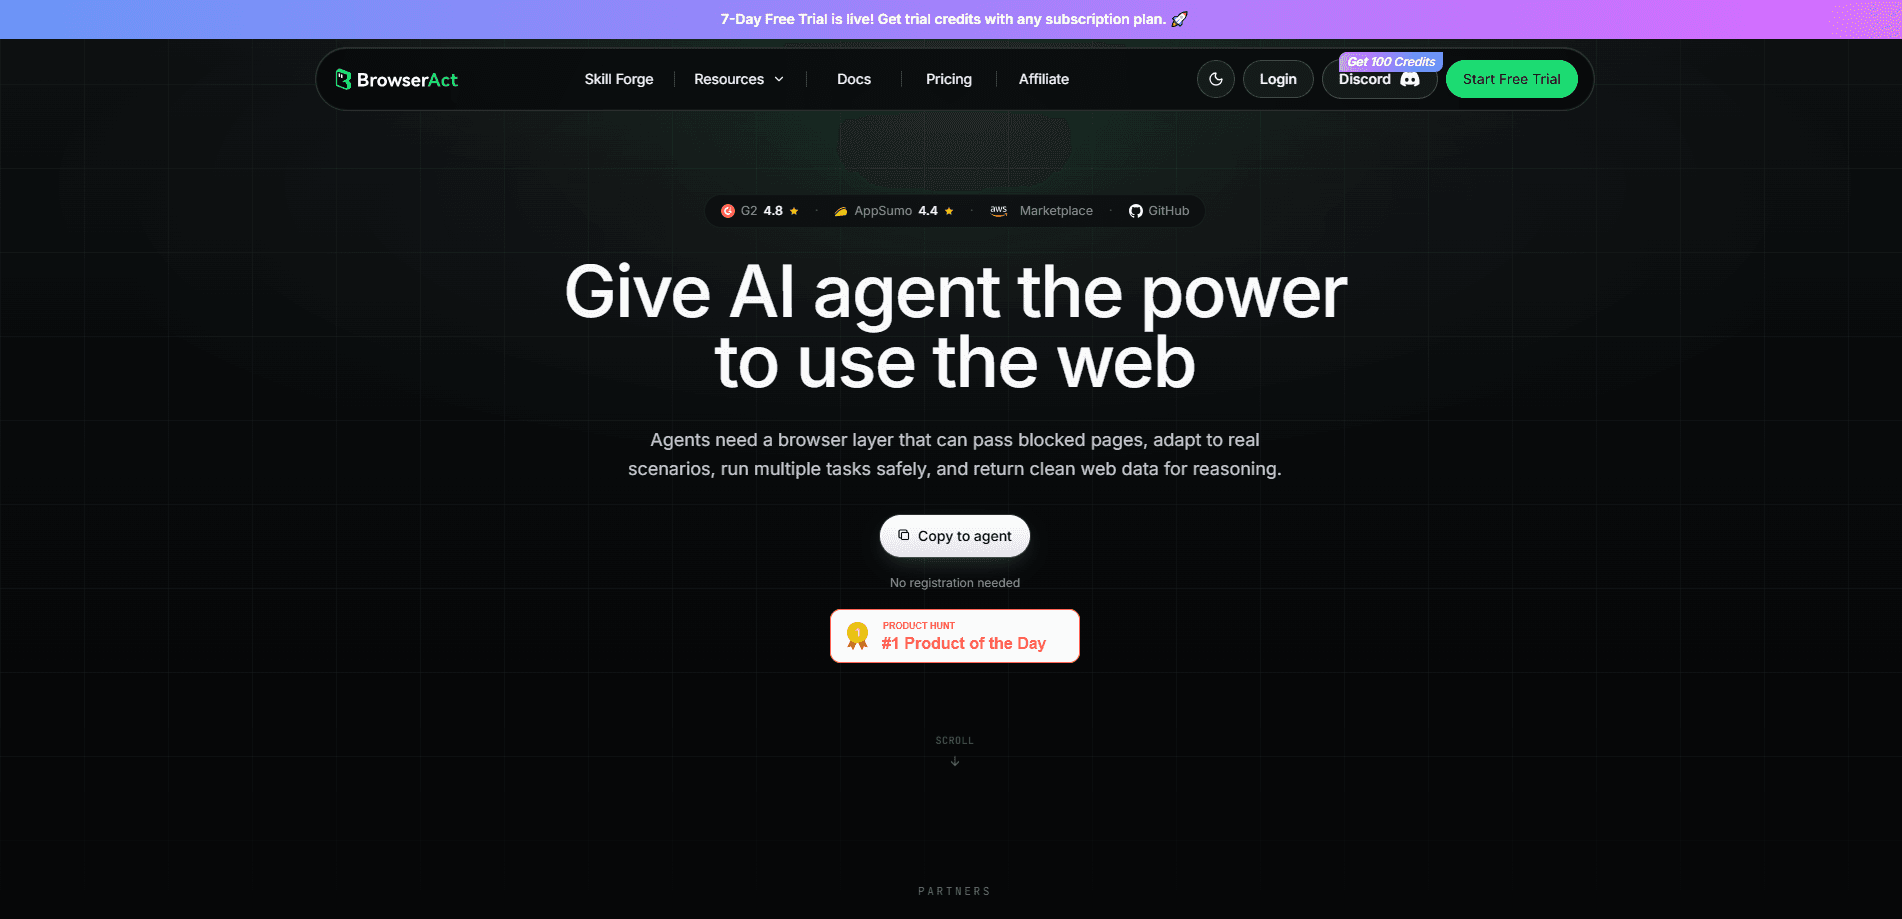
O BrowserAct é um ambiente de automação de navegador feito para agentes de IA. Ele deixa esses agentes abrirem sessões reais e furtivas do Chrome para extrair dados ou agir em qualquer site. Cuida sozinho das partes chatas. Resolução de CAPTCHA, rotação de impressão digital, roteamento por proxies residenciais. Depois devolve dados estruturados e limpos sobre os quais seu agente pode raciocinar. Como ferramenta de web scraping, funciona por uma CLI, um construtor visual de fluxos ou uma API e servidor MCP, então o mesmo bot roda tanto se você programa quanto se não.
Sobre BrowserAct
O que é o BrowserAct
O BrowserAct roda a camada de navegador que os agentes de IA normalmente não conseguem cuidar sozinhos. Em vez de seu agente travar numa página de login ou num CAPTCHA, o BrowserAct levanta uma sessão do Chrome com identidade de dispositivo real, resolve o desafio e segue adiante.
A plataforma fica entre seu agente e a web. Gerencia navegadores, proxies e capacidade, e devolve saída estruturada como CSV ou JSON em vez de um despejo bruto de HTML. Essa saída é a parte que mais importa. Está limpa o bastante para um LLM raciocinar sobre ela sem uma segunda etapa de limpeza. Para extração de dados web pura, isso economiza uma fase inteira de processamento.
O limite principal é a estrutura de custos. Rodar sessões furtivas por IPs residenciais consome créditos rápido, e quando um trabalho de scraping abrange milhares de páginas em várias regiões a conta mensal pode subir bem acima do preço do plano de entrada antes de você perceber. Trabalhos pesados de scraping se acumulam. Então, se sua carga é pequena e ocasional, o plano gratuito basta. Se é grande e constante, fique de olho na aritmética dos créditos.
Como começar
- Cadastre-se no site oficial e resgate o teste gratuito, que começa com 200 créditos e 2 builds de agente grátis.
- Escolha como quer conduzir: instale a CLI, abra o construtor de fluxos na nuvem ou conecte seu agente pela API ou pelo servidor MCP.
- Descreva a tarefa num prompt, ou aponte o construtor para uma página-alvo, e deixe o BrowserAct explorar o site e montar um bot.
- Revise o bot que ele monta, depois rode uma vez para verificar a extração antes de escalar.
- Agende a execução ou dispare sob demanda, e defina a entrega em CSV, JSON ou uma ferramenta conectada como Make, n8n ou Zapier.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de BrowserAct.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores de agentes de IA
- Analistas de e-commerce e de mercado
- Equipes de geração de leads
- Criadores individuais e equipes pequenas
Tarefas
- Extrair listagens de produtos
- Monitorar concorrentes
- Coletar dados de criadores e do mercado de trabalho
- Rodar fluxos com sessão iniciada
Cenários
- Um acompanhamento diário de preços que roda o mesmo bot toda manhã
- Pesquisa em que as páginas-alvo se defendem com CAPTCHAs e bloqueios geográficos
- Extrações em massa pontuais para um relatório
- Entregar o controle do navegador a um agente de IA local
Principais recursos
Ambiente de navegador nativo para agentes
O BrowserAct foi pensado primeiro para agentes, não para humanos clicando. Expõe o navegador por uma CLI, um construtor de fluxos e uma API/MCP, então um agente pode iniciar uma sessão, agir sobre o que encontra e puxar os resultados de volta sem que um humano toque no ciclo. O modo local dá ao seu próprio agente um navegador que ele não alcançaria de outra forma.
Sessões furtivas com impressões digitais reais
Cada sessão do Chromium recebe uma identidade de dispositivo real montada a partir de mais de 30 atributos de impressão digital, combinada com infraestrutura de IPs residenciais. Essa combinação é o que impede que as sessões sejam sinalizadas e bloqueadas em escala. Simplesmente funciona. Você pode levantar um navegador novo a cada vez, ou manter uma sessão logada quando uma tarefa precisa de login.
Resolução automática de CAPTCHA
O ambiente resolve reCAPTCHA, Turnstile, DataDome e outros desafios comuns por conta própria, então uma tarefa não trava no momento em que um site decide te testar. Uma passagem para humano no circuito cobre os casos que a automação não consegue vencer.
Autorrecuperação após mudanças na página
Quando um site atualiza o layout, o BrowserAct encontra e verifica um novo caminho, depois retoma a tarefa. Isso corta o imposto de manutenção que normalmente vem com scrapers, porque você reconstrói menos vezes.
Proxies residenciais globais
Você pode operar a partir dos países de que precisa, usando IPs residenciais rotativos ou persistentes. Sessões fixas servem para trabalho com contas; a rotação serve para coleta de alto volume em que você não quer uma única identidade atrelada a tudo.
Saída estruturada e limpa
Os resultados voltam como dados estruturados, não como uma parede de HTML. Você pode baixar CSV ou JSON, empurrar direto para Make, n8n e Zapier, ou rotear resultados pela sua própria API e endpoints de webhook quando preferir manter tudo dentro do seu pipeline atual. A saída é formatada para que um LLM raciocine sobre ela diretamente.
Execuções na nuvem e agendamento
Os bots rodam sob demanda ou conforme uma agenda, a qualquer hora, sem que você gerencie infraestrutura de navegador. O BrowserAct cuida da capacidade, então uma rajada de tarefas em paralelo não exige que você provisione nada.
Prós e contras
Prós
- Cuida de CAPTCHAs, proxies e impressões digitais. Os agentes não ficam presos nas defesas antibot.
- Converte páginas brutas em saída estruturada que os LLMs usam sem limpeza extra.
- A extração autorrecuperável corta o trabalho de reconstrução quando as páginas-alvo mudam. Menos manutenção, menos tempo perdido.
- Várias superfícies de controle (CLI, construtor sem código, API, MCP) atendem tanto desenvolvedores quanto quem não programa.
Contras
- O preço baseado em créditos faz o uso intenso de proxies residenciais sair caro rápido, e os custos são difíceis de prever de antemão.
- As 2 tarefas simultâneas e os créditos limitados do plano gratuito não sustentam um volume sério de produção.
- O scraping em escala levanta questões legais e de termos de serviço que você mesmo precisa resolver.
Perguntas frequentes
Você pode construir scrapers web reutilizáveis e tarefas de navegador conduzidas por agentes: extrair dados de produtos, monitorar concorrentes, montar listas de leads e acompanhar dados públicos de vagas ou lançamentos. Roda na nuvem ou entrega um navegador ao seu agente local.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a BrowserAct.
Alternativas a BrowserAct

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Google EmbeddingGemma 2
Google DeepMind · Escrita · Imagem · ProgramaçãoGoogle EmbeddingGemma 2 é um modelo aberto de 740 milhões de parâmetros que transforma texto, código, imagens, áudio e quadros de vídeo em vetores de um único espaço de 768 dimensões, rodando em celulares e notebooks.

GitGlow
GitGlow · Programação · ProdutividadeO GitGlow é um cliente Git de desktop que coloca seu código e as mudanças dos seus agentes de IA na mesma revisão, para você saber o que vai sair da máquina antes de publicar.