
Cerebrium
Cerebrium · Programação
O Cerebrium é uma plataforma de GPU sem servidor para rodar apps de IA em tempo real na nuvem. Cobra o processamento por segundo e implanta em várias regiões.
Sobre Cerebrium
What Is Cerebrium
O Cerebrium é infraestrutura para cargas de IA que precisam responder rápido. Você empacota código Python em um contêiner, faz o deploy, e o Cerebrium o transforma em um endpoint que escala sozinho. A plataforma roda CPUs e GPUs da NVIDIA, e mira trabalhos em que a inicialização a frio e a latência decidem se um produto funciona: agentes de voz, saída de modelos em streaming e inferência com muito tráfego.
A velocidade vem de duas coisas. Os contêineres sobem em um a três segundos, e um sistema chamado Content-Aware Storage baixa só os arquivos que uma instância nova precisa, em vez da imagem inteira. Para trabalhos mais pesados, o checkpointing de memória e GPU guarda um instantâneo do processo, então o modelo pula importações e compilação CUDA na próxima inicialização. O Cerebrium diz que o checkpointing encurta bastante a inicialização a frio, e o recurso ainda está em beta.
O preço é por uso, não por assento. Você paga por segundo as vCPUs, a memória e as GPUs que uma carga ocupa enquanto roda, então a cobrança por segundo amarra o gasto ao trabalho real. O plano Hobby é grátis para começar e cobra o processamento por fora; o Standard soma 100 dólares por mês mais processamento para assentos e apps ilimitados. Times que precisam de capacidade reservada, descontos por volume ou ajuda de engenharia de ML vão para o Enterprise. O processamento roda no Google Cloud, na AWS e no Azure, e o Cerebrium encaminha o trabalho para o que for melhor.
Getting Started
- Instale a CLI com pip install cerebrium, ou use o Homebrew no macOS e um pacote binário no Linux.
- Rode cerebrium login e abra o painel para criar uma API key e ver o ID do seu projeto.
- Rode cerebrium init my-first-app para criar um projeto com main.py e cerebrium.toml.
- Teste o código com cerebrium run main.py::run e publique com cerebrium deploy.
- Chame o endpoint implantado na URL de api.cerebrium.ai, ou configure um domínio próprio.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Cerebrium.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Engenheiros de IA que publicam APIs de inferência
- Times com tráfego irregular
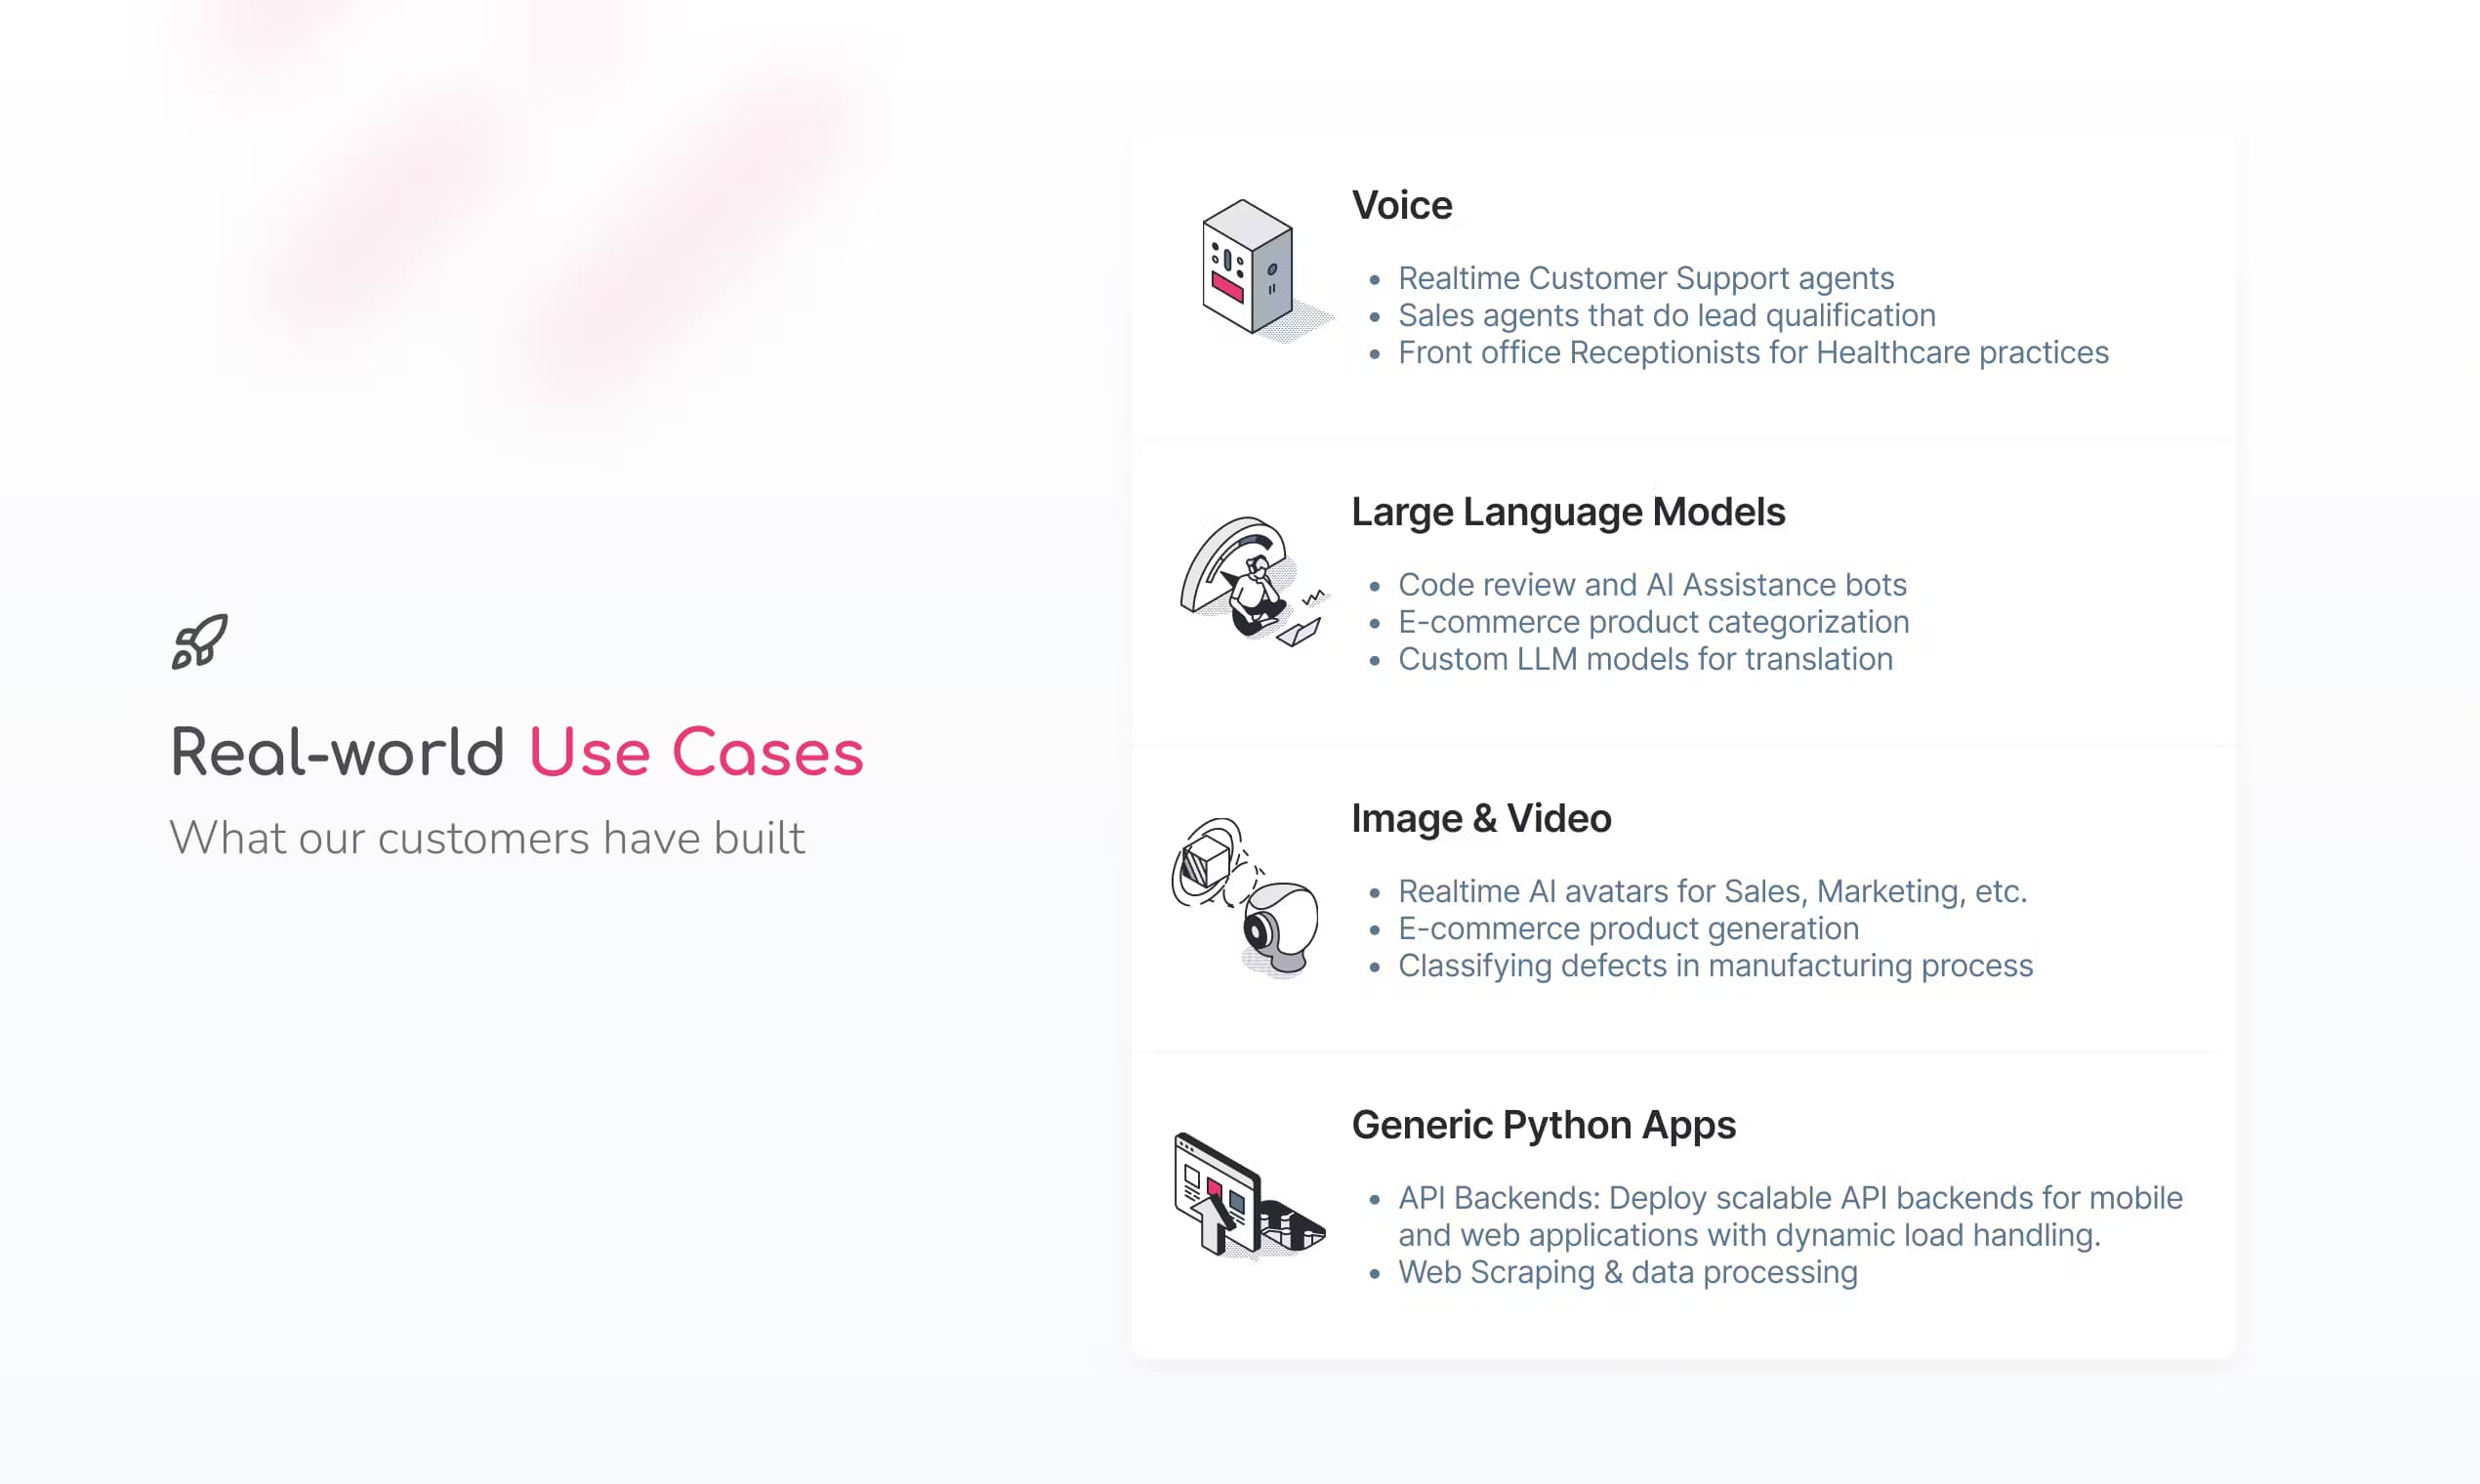
- Criadores de apps de voz e streaming
- Empresas com regras de residência de dados
Tarefas
- Servir modelos abertos
- Gerar imagens e vídeo
- Transcrever áudio longo
- Construir agentes de voz em tempo real
- Rodar embeddings e reranking
Cenários
- Um bot de suporte por telefone que responde enquanto a pessoa ainda fala
- Um pico de tráfego no dia do lançamento
- Um lote noturno de transcrições
- Um app global com usuários em várias regiões
Principais recursos
Inicialização de contêiner em menos de um segundo
O Cerebrium sobe contêineres em um a três segundos, combinando o Content-Aware Storage, que baixa só os arquivos necessários, com o checkpointing de memória e GPU que pula importações, carregamento de modelos e compilação CUDA. A inicialização rápida importa sobretudo em apps em tempo real, em que uma primeira requisição lenta soa como produto quebrado.
GPUs e CPUs sem servidor
Você define o tipo e a quantidade de GPU, os núcleos de vCPU e a memória no cerebrium.toml, escolhendo placas NVIDIA como H100, A100 e L40s. As instâncias escalam com o tráfego, então uma hora calma custa pouco e uma cheia não dispara. Você paga por segundo só os recursos que aloca.
Implantação multirregião
Um mesmo deploy pode rodar em várias regiões para baixar a latência e subir a disponibilidade, ou ficar fixo em uma por residência de dados. O Cerebrium roda no Google Cloud, na AWS e no Azure, e declara 99,999 por cento de disponibilidade com failover que redireciona o tráfego quando uma região cai.
Tipos de endpoint flexíveis
As apps podem servir uma API REST, um endpoint de streaming por server-sent events, um WebSocket para áudio bidirecional, ou qualquer servidor web compatível com ASGI. Esse leque deixa uma única plataforma hospedar tanto uma chamada JSON simples quanto uma sessão de voz ao vivo.
Escalonamento automático e batching
Você configura réplicas, métricas de escalonamento e níveis de processamento, e depois ajusta concorrência e batching para o tráfego real. O batching nativo com vLLM ou LitServe sobe o rendimento da GPU, o que baixa o custo de cada requisição sob carga.
Armazenamento persistente
Os volumes guardam pesos de modelo e arquivos entre deploys, com comandos de upload, download e listagem na CLI, e redimensionamento por projeto até 1TB. Os pesos persistem entre lançamentos, então os contêineres não os baixam de novo a cada inicialização.
Segurança e isolamento
Cada carga roda sobre o gVisor em um ambiente reforçado, o que dá um isolamento de contêiner forte sem grande custo de desempenho. A plataforma cumpre SOC 2, HIPAA, GDPR e ISO, e os segredos vão criptografados e expostos como variáveis de ambiente.
CI/CD e integração com o GitHub
As apps podem se ligar a um repositório do GitHub para que um push ou um merge dispare um deploy, usando chaves de conta de serviço em um pipeline. As configurações de implantação gradual movem o tráfego entre revisões em uma janela fixa, o que reduz o risco de uma versão ruim em produção.
Prós e contras
Prós
- As primeiras requisições chegam em um a três segundos, então apps de voz e em tempo real não travam na inicialização.
- A cobrança por segundo sobre GPU, CPU e memória mantém o custo atado ao trabalho real, e torna a infraestrutura de inferência de IA acessível.
- Um plano Hobby grátis e um Standard de 100 dólares facilitam testar e rodar apps pequenos.
- A implantação multirregião e a cobertura de conformidade combinam com times globais ou com dados regulados.
- O suporte a REST, streaming, WebSockets e servidores Docker ou ASGI próprios encaixa em muitas pilhas.
Contras
- O checkpointing de memória e GPU ainda está em beta, então os maiores ganhos de inicialização ainda não estão fechados.
- A página de preços não lista tarifas fixas por GPU, então você estima o custo com uma calculadora ou pede um orçamento.
- Você não pode usar créditos da AWS nem do GCP, o que surpreende times já comprometidos com essas nuvens.
- A capacidade garantida de GPU exige um gasto mínimo mensal, o que a descarta para projetos pequenos.
Perguntas frequentes
O Cerebrium é uma plataforma de GPU sem servidor para cargas de IA em tempo real e de alto desempenho. Você implanta um contêiner e ele vira um endpoint que escala e roda em CPU ou GPU da NVIDIA, com cobrança por segundo.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Cerebrium.
Alternativas a Cerebrium
Forefront
Forefront · ProgramaçãoO Forefront é uma plataforma web para construir com IA de código aberto. Você ajusta os principais modelos de linguagem de código aberto com seus próprios dados, avalia o desempenho deles e os roda por uma API ou os exporta para hospedar por conta própria. Desenvolvedores que querem a conveniência de uma plataforma fechada, mas fazem questão de ser donos dos modelos e dos dados, são o público-alvo aqui.

Startkit
StartKit.AI · ProgramaçãoStartkit é um boilerplate para criar produtos de SaaS com IA e wrappers de IA. Pense nele como um boilerplate para startups de IA com as partes chatas já conectadas: autenticação, pagamentos com Stripe e Lemon Squeezy, limites de uso, e-mail transacional e um kit inicial de API de IA que conversa com OpenAI, Anthropic, Groq ou Llama. Você clona o repositório, define seu preço e começa pela parte do produto que as pessoas realmente pagam. Ele é feito em Next.js sobre React e Tailwind, então boa parte do código boilerplate já parece familiar.
Testim
Tricentis · ProgramaçãoO Testim é uma plataforma de automação de testes com IA para criar e executar testes de ponta a ponta em aplicações web, mobile e Salesforce. Ele se apoia no aprendizado de máquina para manter os testes estáveis quando uma interface muda, então as equipes gastam menos tempo consertando seletores quebrados. Nada mal para uma ferramenta de testes automatizados que você pode começar a usar hoje. Você cria testes gravando ações no navegador e depois adiciona JavaScript quando precisa de mais controle. É uma escolha sólida para equipes de QA ocupadas.