

Confident AI
Confident AI · Outros
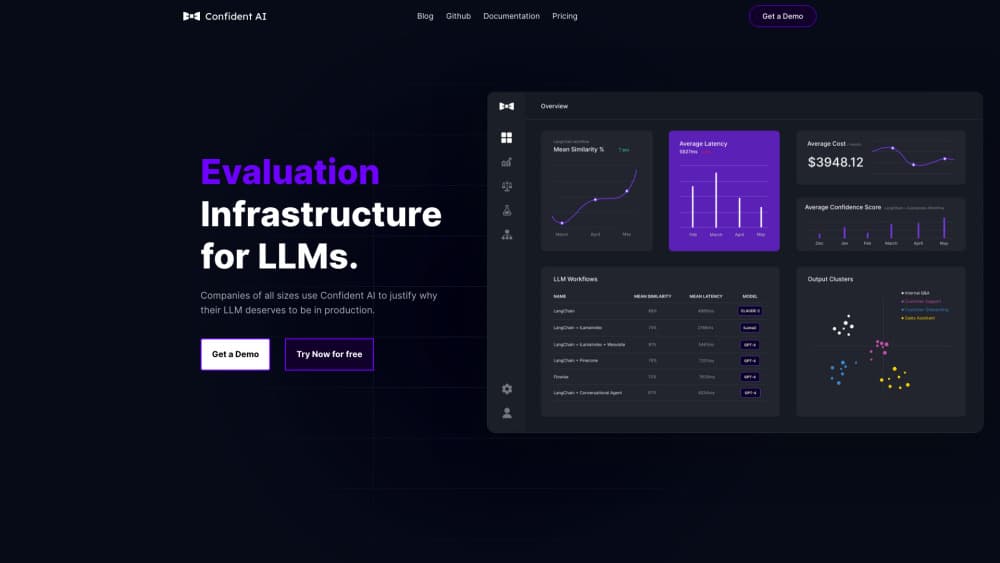
O Confident AI é uma plataforma de avaliação de LLM construída sobre o framework open source DeepEval. Ela testa aplicações de IA antes do lançamento, pontua respostas com métricas de pesquisa e acompanha o tráfego real depois.
Sobre Confident AI
About
O que é o Confident AI
O Confident AI é uma plataforma web para testar e monitorar aplicações baseadas em modelos de linguagem. Ele resolve a parte que mais trava os times: provar que um chatbot, um pipeline RAG ou um agente continua funcionando depois que alguém mexe no prompt ou troca o modelo. Você escreve os casos de teste em Python ou pelo navegador, roda tudo contra a aplicação e recebe uma nota por métrica, com uma justificativa escrita para cada resultado.
A empresa também mantém o DeepEval, o framework de avaliação open source que alimenta as métricas da plataforma. Isso muda a conversa na prática. Dá para rodar as mesmas verificações na sua máquina com o DeepEval e enviar os resultados para o Confident AI, onde o time revisa junto. Nada fica preso na caixa preta de um fornecedor.
O limite mais duro é o preço. O plano gratuito cobre um projeto, dois usuários e cinco execuções por semana. O uso sério começa no Starter, a 200 dólares por mês. Para quem só faz checagens de vez em quando, é uma conta difícil de justificar.
Como começar
- Crie uma conta gratuita em confident-ai.com e copie a chave de API nas configurações do projeto.
- Instale o SDK com
pip install -U deepevale rodedeepeval loginpara ligar o framework local ao projeto na nuvem. - Defina métricas e casos de teste em um arquivo Python, ou monte tudo no navegador pelo fluxo sem código, se você estiver em um plano pago.
- Execute os testes, leia as notas por métrica no painel e compartilhe o link do relatório com o time.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Confident AI.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Engenheiros de IA que constroem pipelines RAG ou agentes
- Product managers responsáveis por recursos de IA
- Times de QA migrando para testes de LLM
Tarefas
- Detectar alucinação antes do lançamento
- Comparar duas configurações de modelo ou prompt
- Transformar falhas de produção em casos de teste
- Fazer red teaming de um chatbot de atendimento
Cenários
- Uma startup que troca de modelo toda semana
- Uma empresa padronizando critérios entre vários times de produto
- Um bot de suporte já em produção
Principais recursos
Biblioteca de métricas com base em pesquisa
A plataforma traz mais de 50 métricas de avaliação de IA construídas sobre o DeepEval, para casos de um turno e de vários. Há relevância da resposta, fidelidade, precisão e recuperação de contexto, alucinação, viés, toxicidade e checagens típicas de agente, como uso correto de ferramentas. Quando nada padrão serve, as métricas G-Eval personalizadas deixam você descrever o critério em linguagem natural.
Simulação de conversas com vários turnos
Em vez de julgar uma resposta isolada, o simulador conduz uma conversa inteira com a sua aplicação e pontua o thread completo. Isso revela falhas que só aparecem depois de várias trocas, como um bot que esquece uma restrição que aceitou antes. Você define a persona e o objetivo, e a plataforma gera os turnos.
Testes de regressão em CI/CD
Os testes de regressão de LLM rodam dentro do GitHub Actions, GitLab CI, Jenkins ou qualquer pipeline que chame a API. Uma métrica reprovada bloqueia o merge do mesmo jeito que um teste unitário quebrado. Cada execução fica salva, então dá para comparar versões e ver o momento exato em que a nota caiu.
Observabilidade de IA no tráfego real
O tracing registra cada requisição, span e thread da aplicação em produção e cola as notas das métricas em cada um. Você filtra traces por nota baixa, percebe desvio ao longo do tempo e cria alertas para respostas repetidas ou sinais de frustração do usuário. Spans do OpenTelemetry continuam valendo se você vem de outra ferramenta.
Anotação humana e alinhamento de métricas
As filas de anotação deixam especialistas de domínio revisarem saídas com os seus próprios critérios. Depois a plataforma compara os rótulos deles com as notas e mostra onde os dois discordam. Essa diferença é a parte útil: indica se uma métrica é frouxa demais antes de você confiar nela como portão de release.
Fluxos sem código e acesso por MCP
Nos planos pagos, dá para apontar as avaliações para um endpoint ao vivo, remodelar a resposta e agendar execuções recorrentes sem escrever código. Um servidor MCP também permite que agentes do Cursor ou do Claude Code rodem avaliações e consultem resultados dentro do editor.
Prós e contras
Prós
- O DeepEval é open source, então você roda as checagens localmente e inspeciona o código das métricas em vez de confiar num motor de pontuação fechado.
- Toda nota vem com explicação, o que deixa a falha depurável por quem não escreveu o teste.
- Tracing e avaliação ficam no mesmo lugar, e os dados de produção viram casos de teste sem retrabalho.
- As integrações cobrem o stack comum: OpenAI, Claude, Gemini, Bedrock, LangChain, LlamaIndex, CrewAI e OpenTelemetry.
- Os controles corporativos incluem SSO, RBAC personalizado, SOC 2, HIPAA e implantação on premise.
Contras
- O plano gratuito limita a um projeto, dois usuários e cinco execuções por semana, o suficiente para conhecer o produto e pouco além disso.
- O uso real em time começa em 200 dólares por mês, valor difícil para desenvolvedor solo ou projeto pequeno.
- Avaliação sem código, avaliações online e alertas são recursos pagos, então o nível gratuito ainda pressupõe que você mexe bem em Python.
- As chamadas ao modelo juiz saem do seu bolso, e um conjunto de dados grande com modelo forte faz a conta subir rápido.
Perguntas frequentes
Testa e monitora aplicações de LLM. Você define casos de teste e métricas, roda contra a sua aplicação e recebe notas com explicação. Depois a mesma plataforma acompanha o tráfego real e pontua as requisições que chegam.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Confident AI.
Alternativas a Confident AI

Odyssey 3
Odyssey · OutrosOdyssey-3 é o modelo de mundo fundacional da Odyssey. Simula física em tempo real, transforma um texto em ambiente interativo e se adapta a robôs, carros e jogos.

JarvisCore
Prescott Data · Programação · Produtividade · OutrosJarvisCore é um runtime de código aberto em Python em que agentes de IA atuam como pares numa malha, assumem tarefas de um registro compartilhado e chegam a serviços externos por um broker sem confiança.
Clef
Cloudflare · Negócios · OutrosClef é o modelo de decisão open source da Cloudflare para o Workers AI. Devolve probabilidades calibradas para perguntas tipadas em vez de texto, então o agente classifica, roteia e age rápido.