
Constellation Gate AI
Constellation Network · Programação
O Constellation Gate AI é um gateway de segurança de IA em tempo real que fica entre os seus agentes e os seus modelos de linguagem. Funciona como gateway LLM e examina cada requisição na entrada e cada resposta na saída, então entrega proteção contra injeção de prompt, evita vazamento de credenciais e dados pessoais, gera economia de custo de tokens e mantém uma trilha de auditoria de IA à prova de adulteração de cada chamada ao modelo. As equipes apontam as ferramentas que já usam para uma única URL base e continuam com os provedores que já pagam, com a gestão de gastos com IA integrada nessa mesma camada.
Sobre Constellation Gate AI
O que é o Constellation Gate AI
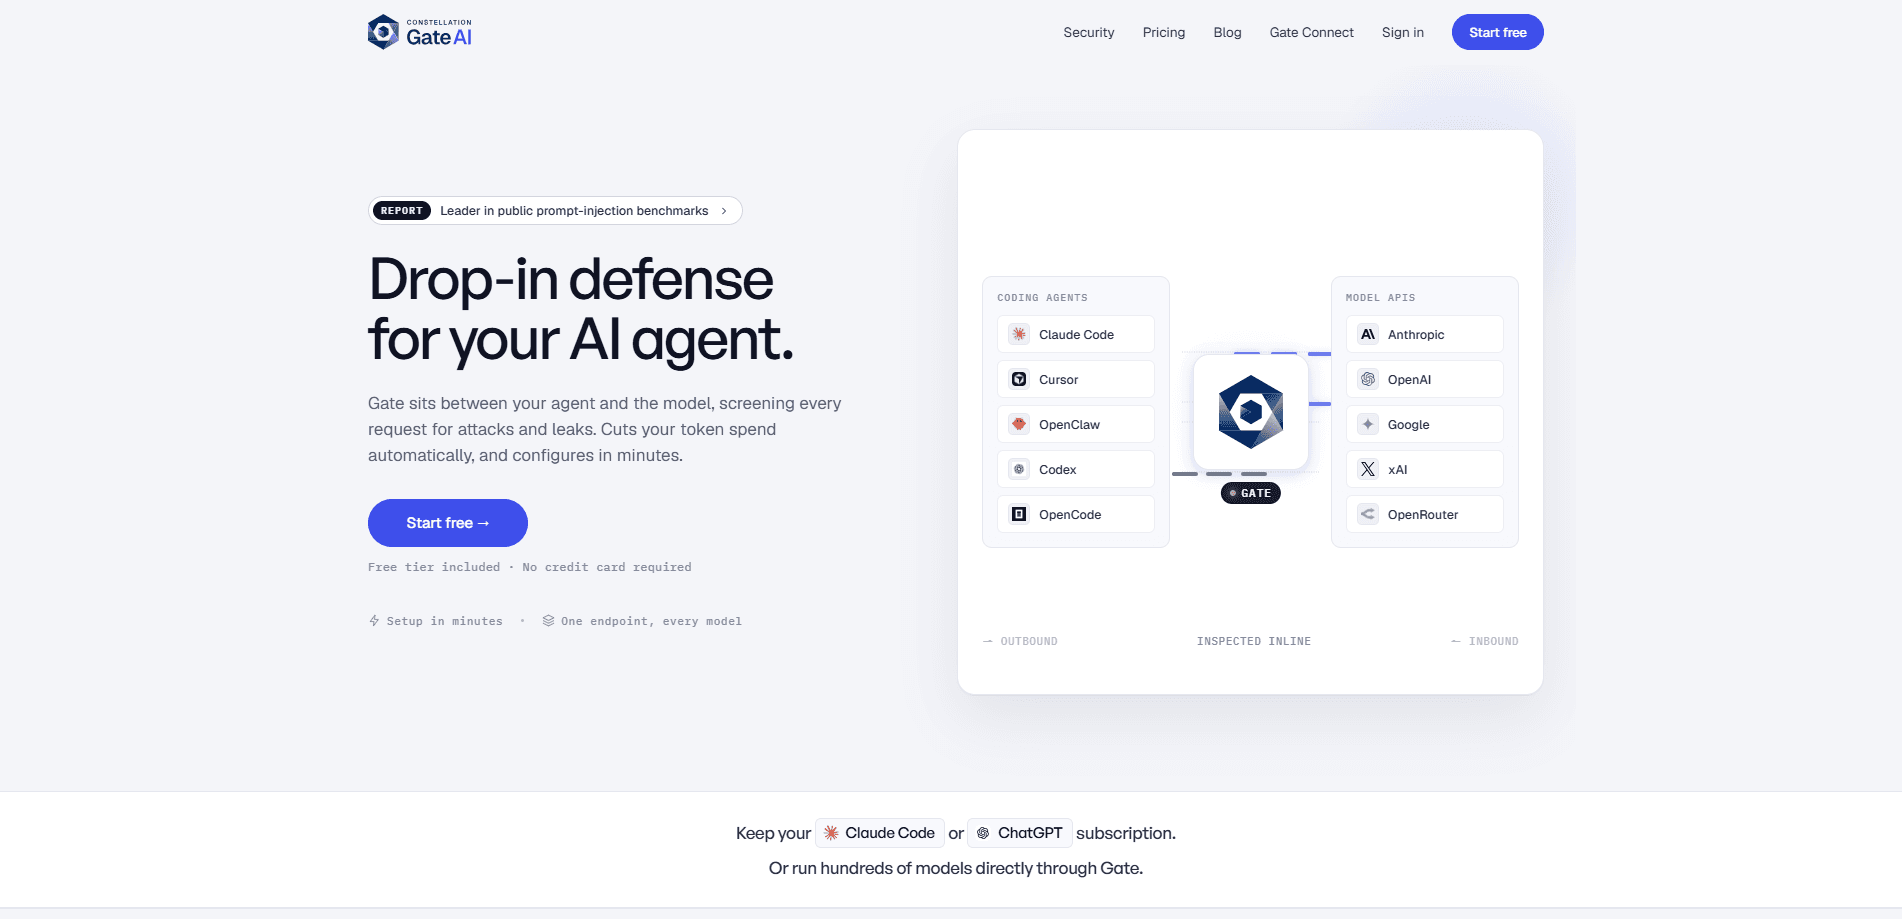
O Constellation Gate AI é uma camada de proxy para equipes que rodam agentes de IA em produção. Pense nele como um posto de controle. Ele não substitui o seu provedor de modelos. Fica na frente de um e observa o tráfego que passa entre o seu app e a OpenAI, a Anthropic ou qualquer outro serviço compatível. Como já está no caminho de cada requisição, examina as entradas, limpa as saídas, comprime o que é enviado e grava uma trilha de auditoria sem que você precise acoplar ferramentas separadas.
O principal problema que ele resolve é que os agentes de IA ficam expostos por duas direções ao mesmo tempo. O texto do atacante chega como uma entrada comum. Pode sobrescrever instruções sem alarde, vazar dados ou disparar uma chamada de ferramenta. Os dados sensíveis vão no sentido contrário, em respostas que podem conter uma chave de API ou o CPF de um cliente. O Gate examina as duas direções e aplica a censura antes que algo arriscado chegue ao destino.
A maior limitação é o alcance. O Gate é um gateway, não uma plataforma de segurança completa, então só protege o tráfego que você direciona por ele. Se parte da sua equipe chama os provedores direto e ignora o Gate, esse tráfego fica cego. E por que rotear pelo Gate, afinal? Porque um único posto de controle para examinar, censurar, comprimir e registrar é mais fácil de manter do que quatro ferramentas soltas. Você também aproveita mais no plano pago, já que a varredura de injeção, a censura e os limites de gasto são recursos do Pro.
Como começar
- Cadastre-se no app do Gate com um endereço de e-mail. O plano Free não pede cartão.
- Crie um workspace e copie a URL base do gateway que ele fornece.
- Aponte uma ferramenta ou um agente para essa URL base no lugar do endpoint do seu provedor. Você pode rodar modelos com as chaves do Gate no modelo pré-pago, ou trazer as suas próprias chaves da OpenAI ou da Anthropic.
- Abra a visão de atividade para ver as requisições, o custo, os tokens e qualquer ataque bloqueado chegando ao vivo.
- Suba para o Pro quando quiser a varredura de injeção, a censura e os limites de gasto, ou defina um limite para que um agente pare em vez de estourar a sua conta.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Constellation Gate AI.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Equipes de engenharia que rodam agentes de IA em produção
- Responsáveis por segurança e conformidade
- Criadores solo com orçamento apertado
Tarefas
- Bloquear a injeção de prompt antes que ela chegue a um modelo
- Cortar o gasto de tokens em loops repetitivos de agentes
- Censurar segredos e dados pessoais nas respostas do modelo
- Auditar o que os seus agentes de fato fizeram
Cenários
- Um agente de atendimento ao cliente que lida com dados de conta
- Agentes que repetem o mesmo arquivo ou a mesma chamada de ferramenta
- Equipes que já pagam Claude Code ou ChatGPT
- Susto com o orçamento no fim do mês
Principais recursos
Proteção contra injeção de prompt e bloqueio de ataques
O Gate examina cada requisição antes que ela chegue ao modelo e cada resposta depois. Cobre três rotas de ataque comuns: injeção direta de prompt, injeção indireta por chamadas de ferramenta sequestradas e vazamento de credenciais ou dados pessoais. Detecta tudo em trânsito, então um ataque é barrado antes que o modelo o veja. A empresa informa F1 médio de 96,6% em 16 conjuntos de dados públicos, contra 83,7% do Lakera Guard. Esse número vem do próprio relatório de benchmark do Gate, então trate-o como uma alegação do fornecedor.
Economia de custo de tokens
O Gate processa cada requisição no caminho até o provedor e tira o desperdício de tokens. Remove conteúdo duplicado, leituras repetidas de arquivo e o excesso das chamadas de ferramenta, mas mantém intacta a primeira cópia de tudo, então o modelo recebe o mesmo conteúdo e devolve a mesma resposta. Na requisição de exemplo da empresa, uma chamada de 6.500 tokens caiu para 5.162 tokens, uma economia de 20,6%, e é daí que vem a economia de custo de tokens.
Censura de dados pessoais e credenciais
Dados sensíveis saindo em uma resposta são um risco silencioso, já que uma única réplica basta para expor um CPF, uma chave de API ou uma nota interna. A censura de dados pessoais no gateway pega isso a tempo: o Gate limpa dados pessoais, dados de saúde e credenciais antes que a resposta volte para o seu app, então o vazamento nunca acontece do seu lado.
Cache de requisições repetidas
Sistemas agênticos se repetem o tempo todo. O mesmo arquivo lido. A mesma nova tentativa. A mesma chamada de ferramenta, em loop. Quando uma requisição idêntica chega pela segunda vez, o Gate devolve a resposta guardada em vez de chamar o provedor. Um acerto de cache não custa nenhum token.
Limites de gasto e de taxa
No Pro você define limites de gasto, de tokens e de taxa de requisições no nível da organização, do projeto ou da chave de API. Quando um agente bate no limite, o Gate para as requisições, não o seu cartão.
Trilha de auditoria de IA à prova de adulteração
Cada mensagem recebe uma impressão digital rumo à Constellation Digital Evidence. Isso produz um registro imutável de cada chamada ao modelo. A trilha de auditoria de IA carrega custo, tokens e latência em todo o workspace, e a linha de conversa deixa você seguir uma única execução de agente do começo ao fim.
Roteamento multiprovedor
Uma URL base cobre OpenAI, Anthropic e outros provedores, então você configura o Gate uma vez em vez de correr atrás de cada endpoint. Você pode pagar conforme o uso pelas chaves do Gate ou trazer as suas próprias chaves de provedor e continuar pagando o provedor direto.
Prós e contras
Prós
- Segurança, controle de custo e registro vivem em um só lugar, já que o Gate já está no caminho da requisição.
- A compressão de tokens e o cache de repetições podem cortar o gasto sem mudar o que o modelo devolve.
- O plano Free não pede cartão e registra 20.000 requisições por mês, então testar é de baixo risco.
- Funciona na frente de assinaturas que você já tem, incluindo Claude Code e ChatGPT.
- A trilha de auditoria é imutável e por mensagem, o que é útil para a revisão de segurança.
Contras
- A proteção só cobre o tráfego roteado pelo Gate, então chamadas diretas ao provedor ficam cegas.
- A varredura de injeção, a censura e os limites de gasto são recursos do Pro, então o plano gratuito é quase só registro.
- Os números de destaque do benchmark vêm do próprio relatório do Gate, não de um teste independente.
- Equipes pequenas podem achar a nuvem privada e a retenção personalizada, exclusivas do Enterprise, fora de alcance.
Perguntas frequentes
É um gateway em tempo real que fica entre os seus agentes de IA e os seus provedores de modelo. Examina requisições e respostas em busca de ataques e dados vazados, comprime o tráfego para reduzir o custo de tokens e registra cada chamada em uma trilha de auditoria verificável.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Constellation Gate AI.
Alternativas a Constellation Gate AI

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Google EmbeddingGemma 2
Google DeepMind · Escrita · Imagem · ProgramaçãoGoogle EmbeddingGemma 2 é um modelo aberto de 740 milhões de parâmetros que transforma texto, código, imagens, áudio e quadros de vídeo em vetores de um único espaço de 768 dimensões, rodando em celulares e notebooks.

GitGlow
GitGlow · Programação · ProdutividadeO GitGlow é um cliente Git de desktop que coloca seu código e as mudanças dos seus agentes de IA na mesma revisão, para você saber o que vai sair da máquina antes de publicar.