
EnergeticAI
EnergeticAI open-source project · Programação
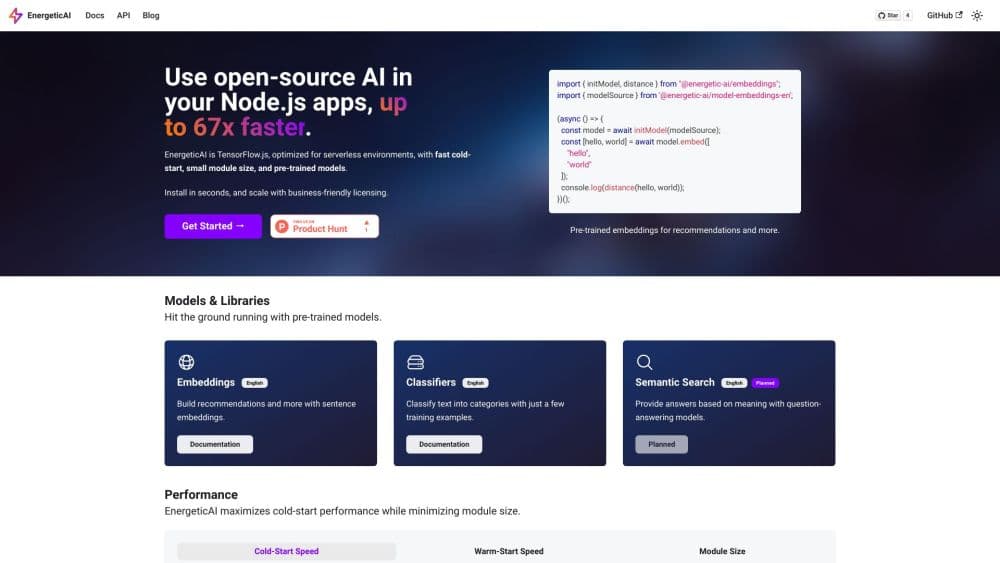
EnergeticAI é uma distribuição de código aberto do TensorFlow.js para funções serverless: um modelo de embeddings ou um classificador de texto começa a responder em cerca de 50 ms.
Sobre EnergeticAI
What Is EnergeticAI
EnergeticAI é uma versão enxuta do TensorFlow.js empacotada para funções serverless como AWS Lambda, Vercel Functions e Netlify Functions. Ela resolve um problema bem específico de deploy. A biblioteca original ocupa de 146 MB a 513 MB sem compactação, então o limite de tamanho do pacote estoura antes de o seu código rodar. Os pesos do modelo ainda são baixados na primeira chamada, o que joga a inicialização acima de dois segundos.
O projeto mantém só o que é necessário para inferência. O módulo fica em torno de 3 MB, a inicialização a frio chega perto de 50 ms na medição do próprio time e o pacote principal funciona como substituto direto do @tensorflow/tfjs-core. Na prática, código e modelos que você já tem costumam rodar sem alteração.
Os limites têm o mesmo peso das vantagens. Os modelos pré-treinados cobrem embeddings e classificação de texto em inglês, a busca semântica continua marcada como planejada e tudo roda em WebAssembly, sem GPU. A versão no npm é a 0.2.0, publicada em junho de 2023, então trate o projeto como estável, porém parado, e não como uma plataforma em expansão.
Getting Started
- Instale Node 18 ou superior e adicione o pacote principal junto com a biblioteca de modelos que você vai usar:
npm install @energetic-ai/core @energetic-ai/embeddings @energetic-ai/model-embeddings-en. - Importe
initModelda biblioteca de modelos e a fonte correspondente, carregando os pesos uma vez por instância da função. - Chame
model.embed()com um array de strings para gerar vetores, ou use o pacote de classificadores e treine com poucos exemplos rotulados. - Compare os vetores com o helper
distancee leve a pontuação para a sua lógica de ordenação, filtro ou roteamento. - Faça o deploy no provedor serverless e confira o tamanho do pacote, porque esse limite é justamente o motivo de trocar para o EnergeticAI.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de EnergeticAI.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores Node.js que querem IA para serverless
- Criadores independentes e times pequenos
- Times com regras rígidas de dados
- Desenvolvedores backend que vão colocar o primeiro recurso de IA no ar
Tarefas
- Montar recomendações de produto com embeddings
- Classificar tickets de suporte ou formulários com um classificador de texto treinado com algumas dezenas de exemplos rotulados.
- Agrupar comentários, avaliações ou anúncios repetidos comparando distância entre vetores em vez de escrever regras de palavra-chave.
- Adicionar uma camada leve de busca semântica sobre algumas centenas de documentos, desde que você aceite que os modelos específicos para isso ainda constam como planejados.
Cenários
- Publicar em um plano gratuito ou barato com teto de pacote, onde um módulo de 3 MB decide se o deploy vai ou não.
- Rodar inferência em texto que não pode ir para uma API externa, como chamados internos, anotações clínicas ou dados de clientes sob contrato.
- Prototipar um recurso de IA no notebook e subir o mesmo código para produção sem reescrever a camada de modelo em cima do SDK de um fornecedor.
Principais recursos
Empacotamento feito para serverless
O projeto inteiro é organizado em volta das restrições das plataformas de função. O módulo cai para cerca de 3 MB, tamanho que cabe nos limites usuais de Lambda e de ambientes de borda onde o TensorFlow.js não passa. Os pesos viajam dentro do pacote em vez de serem baixados na primeira chamada, então um contêiner frio não espera a rede para responder.
Inicialização a frio
O site do projeto fala em até 67 vezes mais velocidade que o TensorFlow.js em funções serverless, medindo a inicialização do modelo e o embedding de um parágrafo de cinco frases em um MacBook Pro com M1 Max. Os seus números vão variar conforme o provedor e o tamanho da entrada. A direção se mantém: dezenas de milissegundos em vez de segundos, e é isso que define se a requisição estoura o tempo.
Modelo de embeddings pré-treinado
O pacote de embeddings transforma strings em vetores que você pode comparar, agrupar ou ordenar. O modelo em inglês vem em um pacote de pesos separado, então você instala apenas o idioma necessário. É o caminho mais curto para recomendações e similaridade de texto sem treinar nada.
Classificador de texto com poucos exemplos
O pacote de classificadores treina em tempo de execução com um conjunto pequeno de exemplos rotulados. Serve bem para roteamento e etiquetagem quando você tem 20 ou 50 casos e não um dataset completo. Os rótulos ficam no seu repositório e o modelo é treinado de novo a cada deploy, o que mantém o comportamento versionado junto com o código.
Compatibilidade direta com TensorFlow.js
O módulo principal espelha a API do @tensorflow/tfjs-core, então imports e código de modelo existentes costumam continuar valendo. Dá para testar em um único endpoint antes de comprometer o serviço inteiro, o que reduz o custo de experimentar.
Backend WebAssembly
A inferência passa por WebAssembly, rápido para entradas curtas e disponível em qualquer host Node sem compilação nativa. Não existe aceleração por GPU, então lotes grandes e documentos longos demoram bem mais do que levariam em uma máquina com CUDA.
Prós e contras
Prós
- Reduz o pacote de centenas de megabytes para cerca de 3 MB, muitas vezes a única forma de publicar um modelo em um plano serverless.
- A inicialização a frio fica perto de 50 ms na medição do projeto, e a requisição do usuário não trava esperando o modelo.
- Licença Apache 2.0 com modelos pré-treinados escolhidos sob termos parecidos, o que simplifica o uso comercial.
- Sem custo por chamada e sem mandar dados para fora da sua função, uma diferença real em relação às APIs de embeddings hospedadas.
- O pacote principal entra em código TensorFlow.js que já existe, então migrar costuma ser trocar uma dependência.
Contras
- Os modelos pré-treinados só existem em inglês, então um produto multilíngue precisa de pesos próprios e de testes extras.
- Sem GPU, lotes grandes ficam mais lentos, e um conjunto longo de documentos pode levar segundos por requisição em uma função pequena.
- O catálogo é curto: hoje há embeddings e classificadores, enquanto a busca semântica segue como planejada.
- No npm a versão é a 0.2.0 de junho de 2023, então você adota um projeto com ritmo lento de release: fixe versões e leia o código quando algo quebrar.
Perguntas frequentes
Roda modelos de IA de código aberto dentro de funções serverless. Os usos mais comuns são recomendações de produto, classificação de texto, detecção de duplicados e busca semântica em backends Node.js que não conseguem carregar uma pilha completa de machine learning.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a EnergeticAI.
Alternativas a EnergeticAI

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Google EmbeddingGemma 2
Google DeepMind · Escrita · Imagem · ProgramaçãoGoogle EmbeddingGemma 2 é um modelo aberto de 740 milhões de parâmetros que transforma texto, código, imagens, áudio e quadros de vídeo em vetores de um único espaço de 768 dimensões, rodando em celulares e notebooks.

GitGlow
GitGlow · Programação · ProdutividadeO GitGlow é um cliente Git de desktop que coloca seu código e as mudanças dos seus agentes de IA na mesma revisão, para você saber o que vai sair da máquina antes de publicar.