
extract by Firecrawl
Firecrawl · Programação
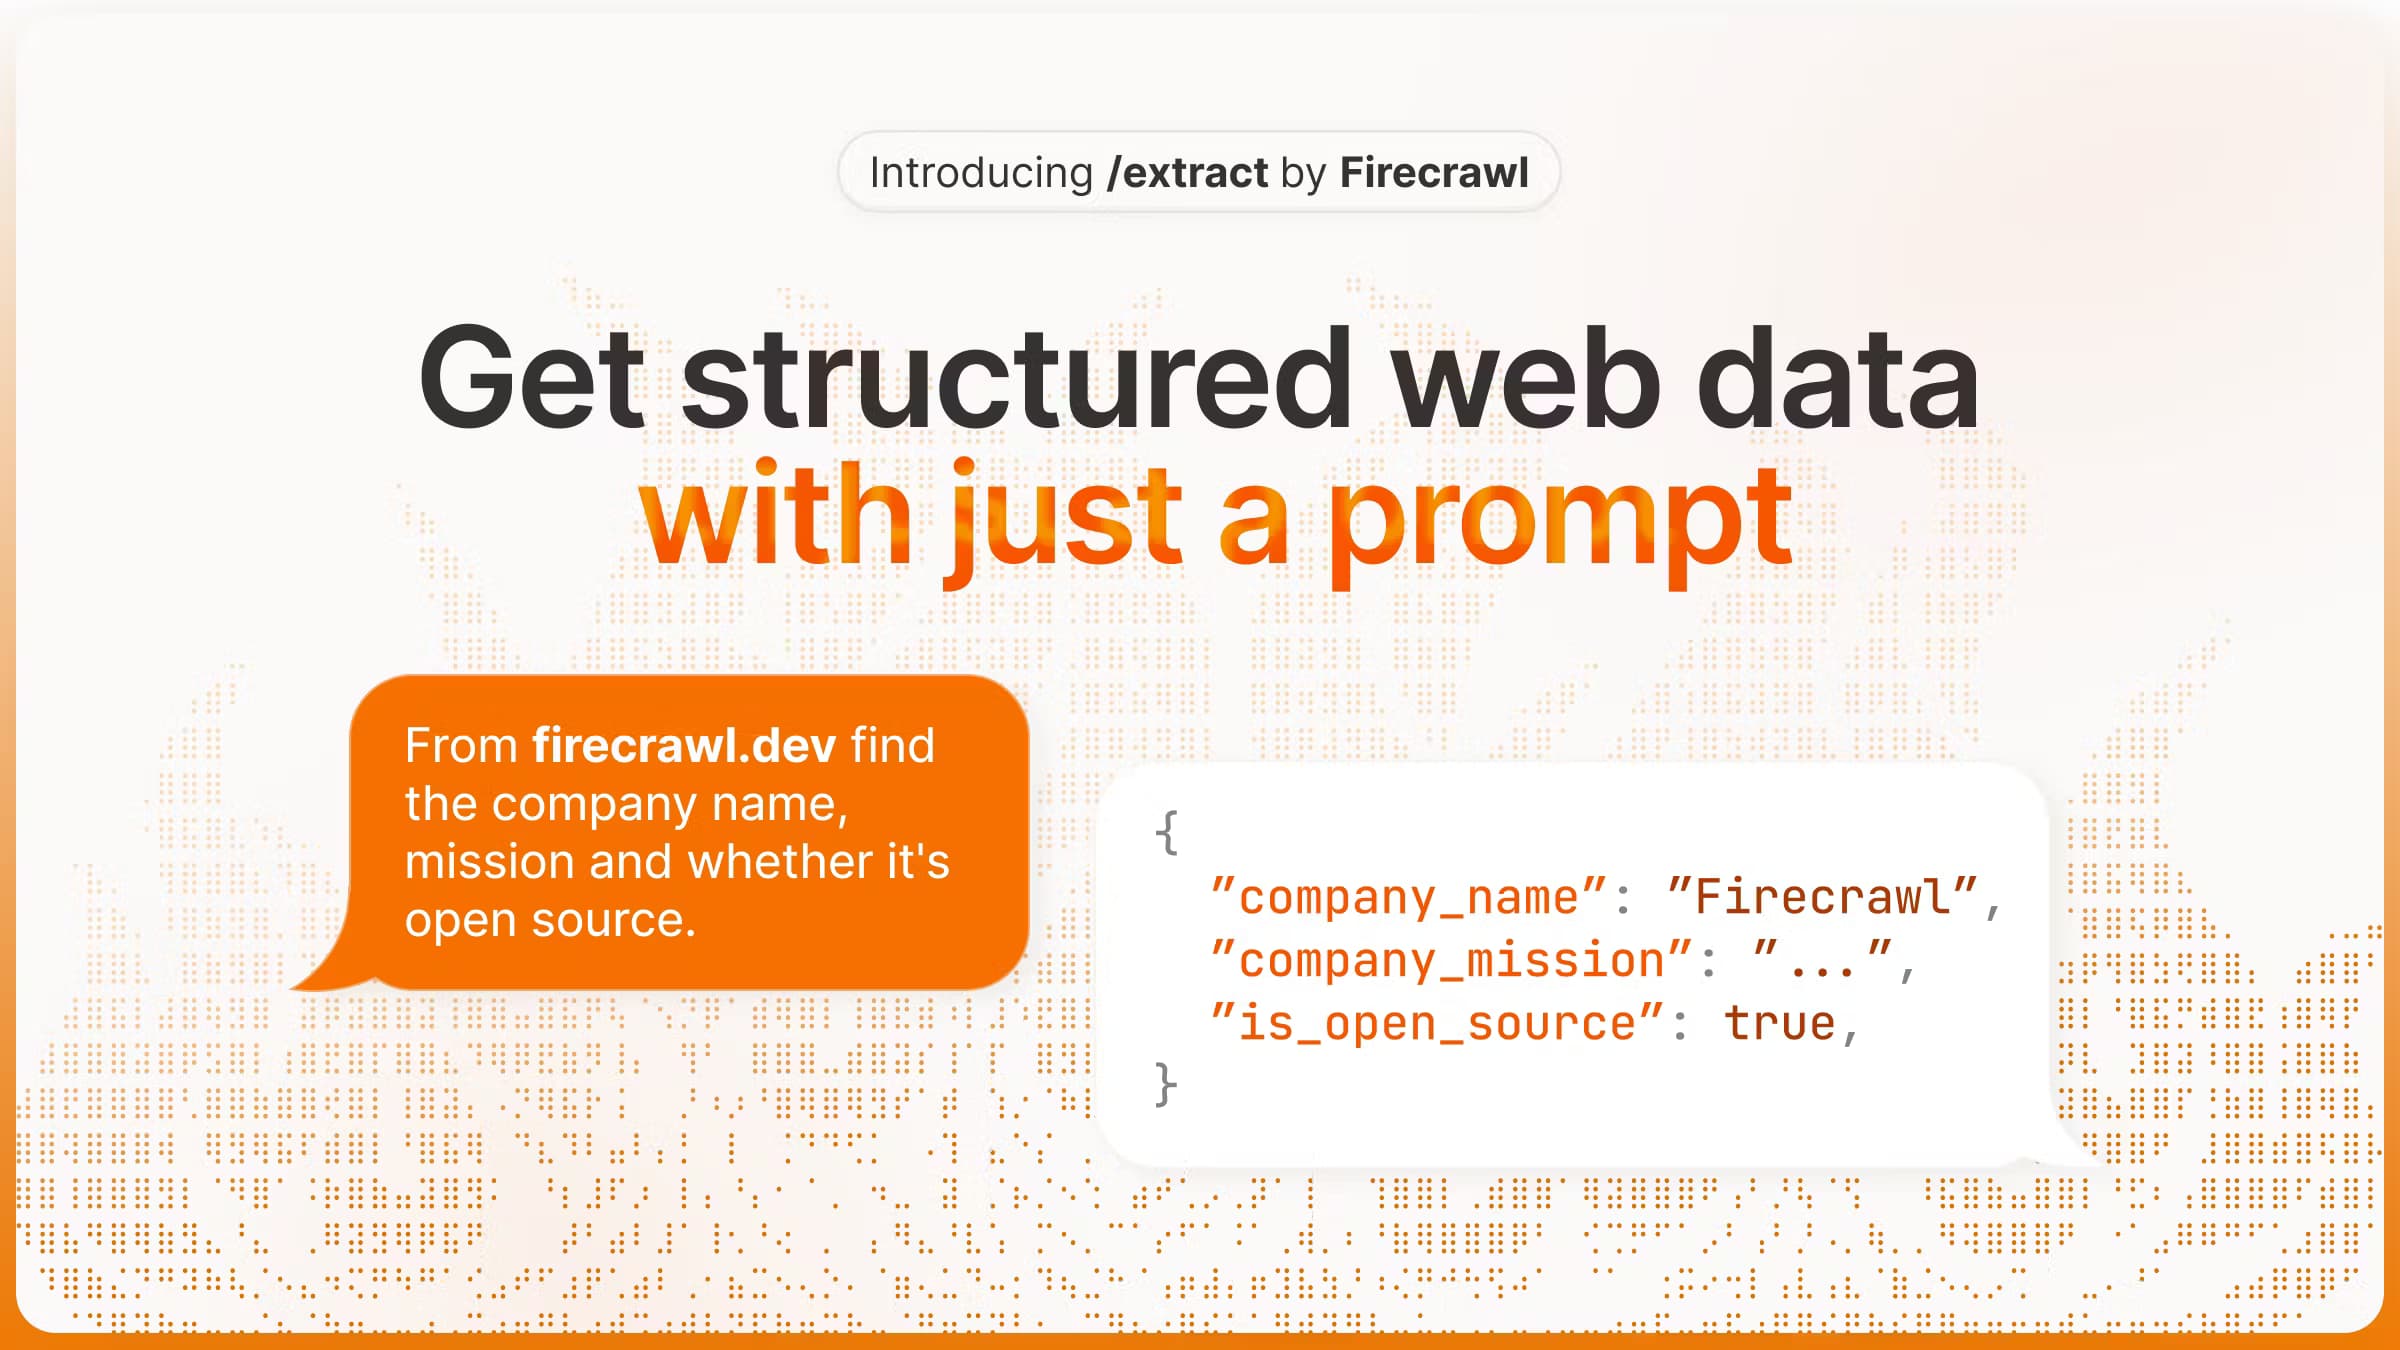
extract by Firecrawl é o endpoint da API do Firecrawl que transforma qualquer URL ou um domínio inteiro em JSON estruturado. Você passa links mais um prompt ou um esquema, e ele devolve os campos que você pediu.
Sobre extract by Firecrawl
What Is extract by Firecrawl
extract by Firecrawl é o endpoint /extract do Firecrawl, uma API de dados da web feita para apps de IA. Ele raspa as páginas que você indica e depois usa um modelo de linguagem para extrair campos específicos em JSON. Em vez de escrever seletores à mão para cada site, você descreve os dados com palavras ou entrega um esquema JSON, e o Firecrawl devolve os valores já organizados.
O endpoint resolve as partes chatas do scraping: páginas pesadas em JavaScript, defesas antibot e mudanças de layout entre sites. Você pode mirar uma página, uma lista ou um domínio inteiro com um curinga como example.com/*, e o Firecrawl rastreia o que encontra antes de extrair. Serve para equipes que precisam de registros, preços ou dados de empresas repetíveis e direto em um banco de dados ou num fluxo posterior.
Dois limites moldam o uso. O extract roda como tarefa assíncrona, então você envia as URLs e consulta um ID de tarefa para ver os resultados, em vez de receber uma resposta na hora. E o Firecrawl agora empurra o trabalho novo para o /agent, seu sucessor, que encontra as próprias URLs. O extract ainda funciona, mas é o caminho mais antigo.
Getting Started
- Cadastre-se em firecrawl.dev e copie sua chave de API no painel
- Instale o SDK (pip install firecrawl-py ou npm install firecrawl) e inicialize um cliente com a chave
- Chame o extract com uma lista de URLs, um prompt que descreva os campos ou um esquema JSON se quiser um formato fixo
- Leia os dados devolvidos, ou consulte o ID da tarefa se usou o método de início para execuções longas
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de extract by Firecrawl.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores que criam apps de IA
- Equipes de dados e analytics
- Fundadores pesquisando o mercado
- Quem monta automações
Tarefas
- Extrair registros de muitas páginas
- Virar páginas bagunçadas em JSON
- Monitorar preços e disponibilidade
- Montar bases de conhecimento para RAG
- Combinar dados de várias fontes
Cenários
- Uma equipe de pesquisa acompanha os preços da concorrência toda semana
- Um desenvolvedor dá fatos frescos da web a um assistente de IA
- Um fundador mapeia um mercado pela primeira vez
- Uma equipe de operações mantém um diretório atualizado
- Um engenheiro de dados normaliza fontes espalhadas
Principais recursos
Extração de dados estruturados com prompt ou esquema
O extract funciona de dois jeitos. Você pode escrever um prompt em linguagem natural descrevendo os dados que quer, e o modelo escolhe um formato sensato. Ou pode entregar um esquema JSON, para que cada registro volte com os campos e tipos exatos que você definiu. Equipes que precisam de um formato estável para um banco de dados escolhem o esquema; quem está explorando um site desconhecido começa com um prompt e aperta depois.
Extração de domínio inteiro com curingas
Você pode mirar o extract numa única página, numa lista curta ou num site inteiro. Uma URL com curinga, como example.com/*, diz ao Firecrawl para rastrear o domínio e ler cada página que encontrar antes de extrair os campos. Isso transforma uma busca no site todo em uma chamada, sem você montar a lista de URLs. O modo de domínio completo está marcado como experimental, então vale conferir os resultados.
Enriquecimento com busca na web
Ligar a opção de busca na web deixa a extração ir além das URLs que você deu. O Firecrawl segue páginas relacionadas para preencher contexto que falta, o que ajuda quando uma única página não traz tudo o que você precisa. Um exemplo documentado puxa preços, recursos e avaliações de dash cams partindo de uma página de produto e deixando a busca ampliar a rede.
Tarefas assíncronas com consulta de status
O extract roda como uma tarefa, não como uma chamada que trava. Você envia a requisição e recebe um ID de tarefa, depois consulta o endpoint de status até ele informar "completed". Os estados são completed, processing, failed e cancelled, então dá para encaixar numa fila ou num worker em segundo plano. Os resultados da tarefa ficam acessíveis pela API por 24 horas depois de terminar.
SDKs oficiais para Python e Node
O Firecrawl publica SDKs para Python e Node, então você não escreve as chamadas HTTP na mão. O cliente de Python aceita um modelo Pydantic como esquema, e o de Node recebe um objeto Zod, o que dá uma saída tipada e validada. Os dois trazem um método de início que devolve um ID de tarefa na hora, e um método de status para buscar os resultados quando a tarefa termina.
Cobrança por créditos compartilhada entre endpoints
Os planos do Firecrawl agora cobram o extract em créditos, a mesma moeda dos outros endpoints. A extração de dados com IA entra nessa mesma conta. Um crédito equivale a 15 tokens no extract, enquanto um scrape básico custa 1 crédito por página. Os créditos são compartilhados entre todos os endpoints, então resultados de busca e páginas raspadas saem do mesmo saldo. Isso facilita prever o gasto quando uma tarefa mistura extração e rastreamento.
Um caminho de migração documentado para o Agent
O Firecrawl marca o extract como a ferramenta mais antiga e aponta o trabalho novo para o /agent, seu sucessor. O Agent mantém as opções de prompt e esquema, mas abre mão da exigência de URL, então consegue procurar e navegar sozinho. Se o seu caso é "encontre esses dados em algum lugar da web", o Agent é o caminho; se você já conhece as URLs, o extract ainda dá conta.
Prós e contras
Prós
- A saída com prompt ou esquema JSON livra você de escrever seletores à mão para cada site
- URLs com curinga deixam uma tarefa cobrir um domínio inteiro, sem você montar a lista de páginas
- Os SDKs oficiais de Python e Node aceitam Pydantic e Zod para resultados tipados e validados
- A cobrança por créditos é compartilhada entre endpoints, o que deixa o gasto previsível quando uma tarefa mistura trabalhos
- Há um plano gratuito com 1.000 créditos por mês que cobre testes leves sem cartão
Contras
- A extração é assíncrona, então você não pode encaixá-la numa requisição que precise de resposta na hora
- O Firecrawl agora direciona usuários novos para o Agent, então o extract é o caminho antigo e fica atrás da ferramenta nova
- A extração de domínio inteiro com curinga está marcada como experimental, então rastreamentos amplos podem exigir conferir resultados
- Os resultados da tarefa somem da API depois de 24 horas, o que deixa o armazenamento de longo prazo com você
- Páginas que devolvem status de erro como 403 ou 404 ainda custam um crédito
Perguntas frequentes
É o endpoint /extract do Firecrawl, uma API de dados da web. Você passa URLs mais um prompt ou um esquema JSON, e um modelo de linguagem devolve os campos que você pediu como JSON estruturado. Serve para puxar registros repetíveis de páginas que não compartilham um layout fixo.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a extract by Firecrawl.
Alternativas a extract by Firecrawl

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Google EmbeddingGemma 2
Google DeepMind · Escrita · Imagem · ProgramaçãoGoogle EmbeddingGemma 2 é um modelo aberto de 740 milhões de parâmetros que transforma texto, código, imagens, áudio e quadros de vídeo em vetores de um único espaço de 768 dimensões, rodando em celulares e notebooks.

GitGlow
GitGlow · Programação · ProdutividadeO GitGlow é um cliente Git de desktop que coloca seu código e as mudanças dos seus agentes de IA na mesma revisão, para você saber o que vai sair da máquina antes de publicar.