
Finetunefast
FinetuneFast · Imagem · Outros
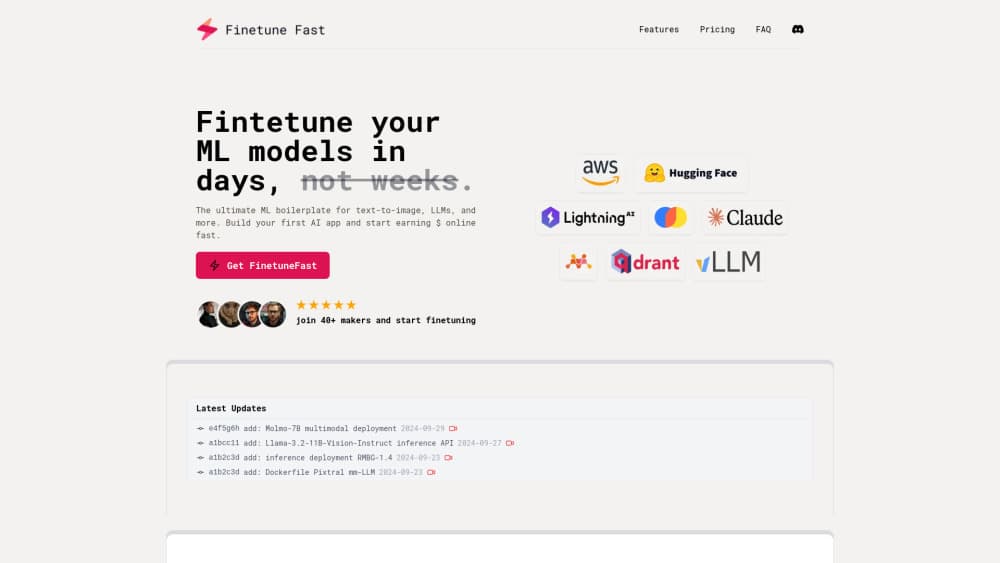
O FinetuneFast é um boilerplate de código para ajustar modelos de imagem, LLM e multimodais, com treinamento, preparação de dados, implantação e exemplos de RAG para lançar apps de IA mais rápido.
Sobre Finetunefast
What Is FinetuneFast
O FinetuneFast vende um conjunto de modelos de código prontos para quem quer ajustar um modelo de aprendizado de máquina sem montar todo o processo do zero. O ajuste fino de modelos (fine-tuning) é pegar um modelo já treinado e continuar o treinamento com os seus próprios dados, para que ele se adapte a uma tarefa específica, seja um estilo de arte pessoal ou um chatbot de suporte que fala como a sua empresa.
O projeto foi criado por Patrick, um engenheiro de ML que montou a ferramenta depois de anos preparando treinamentos na mão. O ajuste de modelos de imagem é o uso mais chamativo, mas a rota serve igual para texto e multimodal. O produto lista as horas que um ajuste típico consome antes de sair algo publicável: cerca de quatro para configurar o ambiente, seis para limpar os dados, quatro para integrar APIs, duas para avaliar, três para implantar e um número sem fim para escalar a infraestrutura conforme o modelo cresce. O FinetuneFast reúne essas etapas em scripts já configurados, então você pula a parte chata e dedica o tempo ao modelo.
Os casos de uso vão de um estilo de arte próprio a um chatbot de atendimento. As limitações contam. Isto é uma biblioteca de modelos, não uma plataforma hospedada com painel. Você continua rodando o código, conectando a sua própria GPU ou nuvem e sabendo se virar no terminal ou em um notebook. Os modelos de código favorecem modelos abertos e fluxos comuns, então uma arquitetura fora do padrão pode exigir trabalho extra. As novidades chegam por uma comunidade no Discord e, no plano mais caro, com atualizações vitalícias.
Getting Started
- Compre um plano em finetunefast.com e baixe os arquivos do boilerplate. Não há versão grátis, e o pagamento é único, não mensal.
- Abra os notebooks ou scripts de treinamento e aponte-os para o seu conjunto de dados. Os pipelines de carga esperam os arquivos no formato documentado.
- Escolha o modelo base e as opções de treinamento. Para imagem ou LLM, você normalmente parte de um checkpoint, seja um LoRA ou um ajuste completo, e mexe nos hiperparâmetros.
- Rode o treinamento na sua própria GPU. O suporte multi-GPU vem incluído, então dá para dividir um trabalho grande entre várias placas.
- Implante o modelo com o boilerplate de inferência, que gera um endpoint de API e monta o monitoramento e os logs para você.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Finetunefast.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores independentes e makers
- Times pequenos de IA com orçamento apertado
- Engenheiros de ML cansados de configurar tudo
- Fundadores montando um SaaS de IA
Tarefas
- Ajustar modelos de imagem
- Ajustar LLM
- Preparar os dados de treinamento
- Implantar um modelo com API
- Adicionar recuperação a um app de IA
Cenários
- Um designer que treina um modelo de imagem com o seu estilo
- Um desenvolvedor que lança um SaaS de IA
- Um pesquisador que faz experimentos controlados
- Um hobbyista aprendendo ajuste fino
Principais recursos
Boilerplates de treinamento
O núcleo do produto é um conjunto de scripts de treinamento já configurados para modelos de imagem, LLM e multimodais. Em vez de escrever um laço de treinamento e montar um carregador de dados na mão, você ajusta algumas opções e começa. Os scripts cobrem o que costuma quebrar primeiro, como carga eficiente de dados e ferramentas de hiperparâmetros.
Pipelines de preparação de dados
O ajuste fino trava quase sempre por dados bagunçados, e o boilerplate trata essa etapa como parte central. Os pipelines limpam, formatam e organizam os seus arquivos antes do treinamento, a tarefa que o próprio produto estima em cerca de seis horas por projeto. Você ainda precisa fornecer dados bons, mas a parte técnica já está escrita.
Treinamento multi-GPU
O suporte multi-GPU funciona sem configuração, então um ajuste grande não precisa rodar em uma única placa. Você distribui o trabalho entre as GPUs que tiver, encurta treinamentos longos e aproveita hardware que já aluga.
Implantação em um clique e autoescalonamento
O boilerplate de inferência pega um modelo treinado e levanta o caminho de serviço: implantação em um clique, infraestrutura com autoescalonamento, um endpoint de API gerado e monitoramento com logs. Isso cobre a distância entre um checkpoint no notebook e um modelo que o seu app consegue chamar de fato.
Modelos de inferência e RAG
Junto ao código de treinamento, o pacote traz boilerplates de inferência prontos para produção e exemplos de RAG. O RAG, ou geração aumentada por recuperação, deixa um app de IA puxar documentos externos para que as respostas se apoiem no seu próprio conteúdo. Esses modelos são o que transforma um modelo ajustado em um recurso do produto.
Ajuste sem código
Para quem não quer mexer no código de treinamento, há uma rota sem código que resolve as etapas do ajuste com uma configuração guiada. Ela mira makers que se importam mais com o resultado do que com o interior, e convive com a rota de código completo em vez de substituí-la.
Prós e contras
Prós
- Corta o tempo de configuração, preparação e implantação que domina um primeiro projeto de ajuste, conforme as horas que o produto lista.
- Preço de pagamento único com projetos ilimitados, então o custo não sobe conforme quantos modelos você treina.
- Cobre todo o caminho, do treinamento a um endpoint servido, com exemplos de RAG que quase todo app de IA precisa.
- O plano All In soma suporte no Discord e atualizações vitalícias, útil se você pretende continuar construindo.
Contras
- Não há versão grátis, então você não testa os modelos de código antes de pagar.
- É uma biblioteca de código, não uma plataforma gerenciada: você entra com a própria GPU ou nuvem e continua rodando tudo sozinho.
- O suporte é comunitário no Discord, o que significa que a ajuda depende de quem está online, sem tempo de resposta garantido.
- Os modelos de código puxam para modelos abertos e fluxos comuns, então uma montagem fora do padrão pode pedir código escrito por você.
Perguntas frequentes
Ele oferece código de boilerplate para ajustar e implantar modelos de ML, cobrindo scripts de treinamento, pipelines de dados, implantação e exemplos de RAG para imagem, LLM e trabalho multimodal. Você compra os modelos de código e os roda no seu próprio hardware.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Finetunefast.
Alternativas a Finetunefast

X Ray Interpreter
X-ray Interpreter · ImagemO X Ray Interpreter é uma ferramenta de radiologia com IA baseada na web que transforma raios X, tomografias, ressonâncias, ultrassonografias e imagens PET em laudos em linguagem simples. Você envia um exame, recebe uma interpretação preliminar dos raios X em instantes e depois faz perguntas de acompanhamento se algo precisar de explicação. Ele funciona como segunda opinião e como apoio de aprendizado, não como diagnóstico médico.

Aieasypic
AIEasyPic · ImagemO AIEasyPic é um gerador de imagens com IA que transforma prompts de texto simples em obras finalizadas em segundos. Você também pode treinar modelos personalizados com suas próprias fotos, trocar rostos em imagens existentes e criar clipes de vídeo curtos a partir de texto, tudo pelo navegador. Ele serve tanto para criadores casuais que querem imagens rápidas quanto para hobistas que desejam montar um modelo pessoal sem tocar em código.

Chargen
Chargen · ImagemO Chargen é um gerador de personagens com IA e um conjunto de ferramentas de criação de mundos feito para Dungeons & Dragons e outros RPGs de mesa. Ele transforma uma ideia de uma linha em um retrato de personagem pintado, cria NPCs, monstros, mapas e encontros na mesma sessão, e mantém os detalhes de cada criatura à mão. A parte de arte para RPG de mesa funciona com um sistema de créditos chamado Gold, enquanto os geradores de texto seguem gratuitos para todos.