
Fish Speech
Fish Audio · Voz e linguagem · Vídeo
Fish Speech é o modelo de texto para fala open source da Fish Audio, hoje entregue como Drama 3: clona uma voz em 10 a 30 segundos, fala 83 idiomas e aceita tags de emoção.
Sobre Fish Speech
About
O que é o Fish Speech
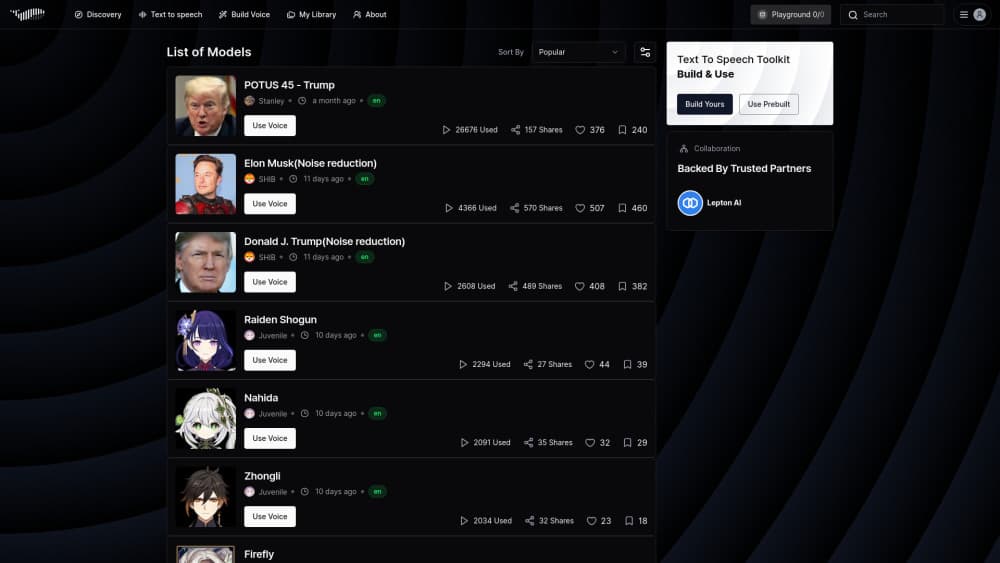
Fish Speech é um modelo de texto para fala open source da Fish Audio, a empresa por trás da plataforma fish.audio. O nome cobre duas coisas que vêm juntas: os pesos do modelo no Hugging Face e o código no GitHub, além do serviço hospedado que roda esses mesmos modelos por trás de um site e de uma API. Você pode entrar no site e usar como qualquer gerador de voz com IA, ou baixar os pesos e ficar com a infraestrutura inteira nas suas mãos.
A família evoluiu rápido. Fish Speech 1.x e OpenAudio S1 firmaram a proposta: clonar uma voz a partir de uma amostra curta e controlar o tom com linguagem comum. S2 e S2.1 Pro melhoraram precisão e streaming. Drama 3, lançado em 13 de outubro de 2026, é o modelo atual: 35B de parâmetros com 3B ativos por token, e acrescenta edição local de áudio e revisão por turnos ao que já funcionava.
O que ele resolve é a distância entre o aberto e o acabado. Quase todo projeto de TTS open source soa chapado ao lado das ferramentas comerciais, e quase toda ferramenta comercial obriga você a passar pela nuvem dela. Aqui as duas portas estão abertas: os pesos saem com a licença comunitária da Fish Audio, que libera uso comercial para empresas com menos de 500 mil dólares de receita anual, e os planos hospedados começam de graça.
Os limites também contam. Rodar por conta própria pede uma GPU NVIDIA e alguma paciência com ambientes Python. A qualidade do clone acompanha a limpeza do áudio de referência: uma gravação com ruído de fundo gera um clone com ruído de fundo. E boa parte dos números de benchmark vem dos testes da própria Fish Audio; o Artificial Analysis é a comparação independente mais consistente hoje.
Como começar
- Abra o fish.audio e crie uma conta gratuita. O plano free cobre cerca de 7 minutos de áudio por mês, o bastante para saber se as vozes servem ao seu projeto.
- Escolha uma voz da biblioteca ou clone a sua. Para clonar, envie de 10 a 30 segundos de fala limpa, sem música e sem eco de sala.
- Cole o roteiro na caixa de texto e insira as tags de direção onde a intenção muda, por exemplo [whisper] antes de uma fala ou [laughing] depois dela.
- Gere, ouça e mexa nas tags antes de reescrever o texto. Trocar uma tag muda mais a entrega do que reescrever a frase.
- Para rodar localmente, clone o repositório do GitHub, monte o ambiente, baixe os pesos do Hugging Face e suba a interface web ou o servidor de API numa máquina com placa NVIDIA recente.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Fish Speech.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Criadores de YouTube e podcasters
- Desenvolvedores de jogos e animação
- Desenvolvedores que colocam voz em um produto
- Equipes de localização
Tarefas
- Dublar um vídeo para outro idioma
- Rascunhar diálogos de personagem
- Transformar um artigo em áudio
- Adicionar voz a um protótipo
Cenários
- Testar uma ideia antes de pagar estúdio
- Manter um canal em vários mercados
- Entregar uma demo com prazo curto
Principais recursos
Clonagem de voz com amostra curta
De 10 a 30 segundos de áudio de referência bastam para reproduzir um timbre, e a Fish Audio anuncia 15 segundos no material de divulgação. O clone carrega sotaque, altura e ritmo de fala, não só uma impressão geral. O que funciona melhor é um arquivo mono gravado perto do microfone; música ao fundo é o caminho mais rápido para estragar tudo.
Tags de direção no texto
A entrega é controlada por instruções entre colchetes, escritas onde o clima muda: [whispering], [angry], [sighing], [laughing], [pause]. O Drama 3 também aceita direção livre, então [barely holding it together, forcing a smile] vale como tag. Tags em par, como as de ênfase, dirigem só algumas palavras dentro da frase. É essa a diferença real em relação aos motores antigos, em que você ajustava velocidade e tom e torcia.
Cobertura ampla de idiomas
O Drama 3 fala 83 idiomas, bem acima dos 13 do Fish Speech 1.5. Isso o coloca entre os modelos de TTS multilíngue mais amplos que dá para baixar. O ponto central é a clonagem entre idiomas: você clona a voz uma vez e gera em outra língua mantendo a identidade do falante. As tags de direção podem ser escritas no idioma em que você pensa, e o modelo aplica do mesmo jeito.
Várias vozes em uma única cena
Um mesmo texto pode trazer vários personagens marcados com identificadores de falante, e o modelo gera o diálogo inteiro de uma vez. Para radionovela, cinemática de jogo ou vídeo com dois apresentadores, isso elimina o ciclo de gerar, colar e reajustar tempos que tornava o trabalho com várias vozes penoso.
Edição local e revisão por turnos
O Drama 3 deixa você editar uma tomada pronta como se fosse um documento. Troque uma palavra e o timbre e as transições em volta continuam intactos, então você não regenera cinco minutos de áudio por causa de um erro. A revisão por turnos vai no sentido oposto: você diz que a última tomada deveria ser mais suave ou mais triste e o modelo refaz com esse contexto.
Pesos abertos para rodar onde quiser
O código e os pesos são públicos, e a licença comunitária autoriza uso comercial abaixo de 500 mil dólares de receita anual. Para equipes com exigência de privacidade ou volume previsível, é uma opção real: a inferência local não cobra por caractere. Em troca, você põe hardware, tempo de instalação e a manutenção de uma pilha Python.
API em streaming com baixa latência
A API hospedada emite áudio enquanto gera, com o primeiro som por volta de 100 ms e fator de tempo real de 0,195 numa H200 segundo as medições da Fish Audio. Texto para fala, fala para texto e um endpoint de agente de voz usam a mesma chave. Em produto conversacional, essa latência separa um assistente que atropela de um que espera a vez.
Prós e contras
Prós
- A clonagem funciona com uma referência curta, então você não precisa de sessão de estúdio para ter uma voz utilizável.
- Emoção e ritmo são controlados com tags em linguagem comum, bem mais rápido de iterar do que com controles de parâmetro.
- O plano gratuito e os pesos abertos dão dois caminhos baratos de avaliar antes de pagar.
- 83 idiomas com clonagem entre línguas cobrem boa parte do trabalho de localização com uma só identidade de voz.
- A latência de streaming e a API aberta tornam o modelo viável dentro de um produto de verdade, não só para arquivos soltos.
Contras
- Rodar localmente exige GPU NVIDIA e familiaridade com ambientes Python, o que deixa o usuário casual de fora.
- A qualidade do clone depende muito do áudio de referência: gravação ruidosa gera resultado abafado e não há ferramenta de limpeza embutida.
- A licença comunitária limita o uso comercial gratuito a empresas com receita anual abaixo de 500 mil dólares, então empresas maiores precisam de acordo à parte.
- Quase todos os benchmarks publicados são do próprio fabricante, e as comparações independentes medem pronúncia, não alcance emocional.
Perguntas frequentes
Sim. O serviço hospedado tem plano free com cerca de 7 minutos de geração por mês, e os pesos podem ser baixados sem custo. O uso comercial dos pesos abertos é liberado para organizações com receita anual abaixo de 500 mil dólares.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Fish Speech.
Alternativas a Fish Speech

Foley
Hanamori Labs, LLC · Voz e linguagem · Produtividade · Assistente de IAFoley é uma lista de tarefas por voz que transforma uma frase falada em tarefa arquivada, com projeto, data e hora já preenchidos, e depois ajuda você a organizar o dia com o que já está anotado.

HireKey
HireKey · Voz e linguagem · Produtividade · AprendizadoHireKey é um copiloto de busca de emprego com IA criado por uma recrutadora de tecnologia. Avalia aderência à vaga, adapta o currículo, treina entrevistas e organiza cada candidatura.

Fluence
Yay Software (Yannick Huchard) · Escrita · Voz e linguagem · ProdutividadeO Fluence é um app de Android que lê em voz alta PDF, EPUB, arquivos do Word e artigos da web, acompanha a frase falada e responde perguntas sobre o texto sem sair do celular.