
Foglamp
Foglamp Labs · Programação
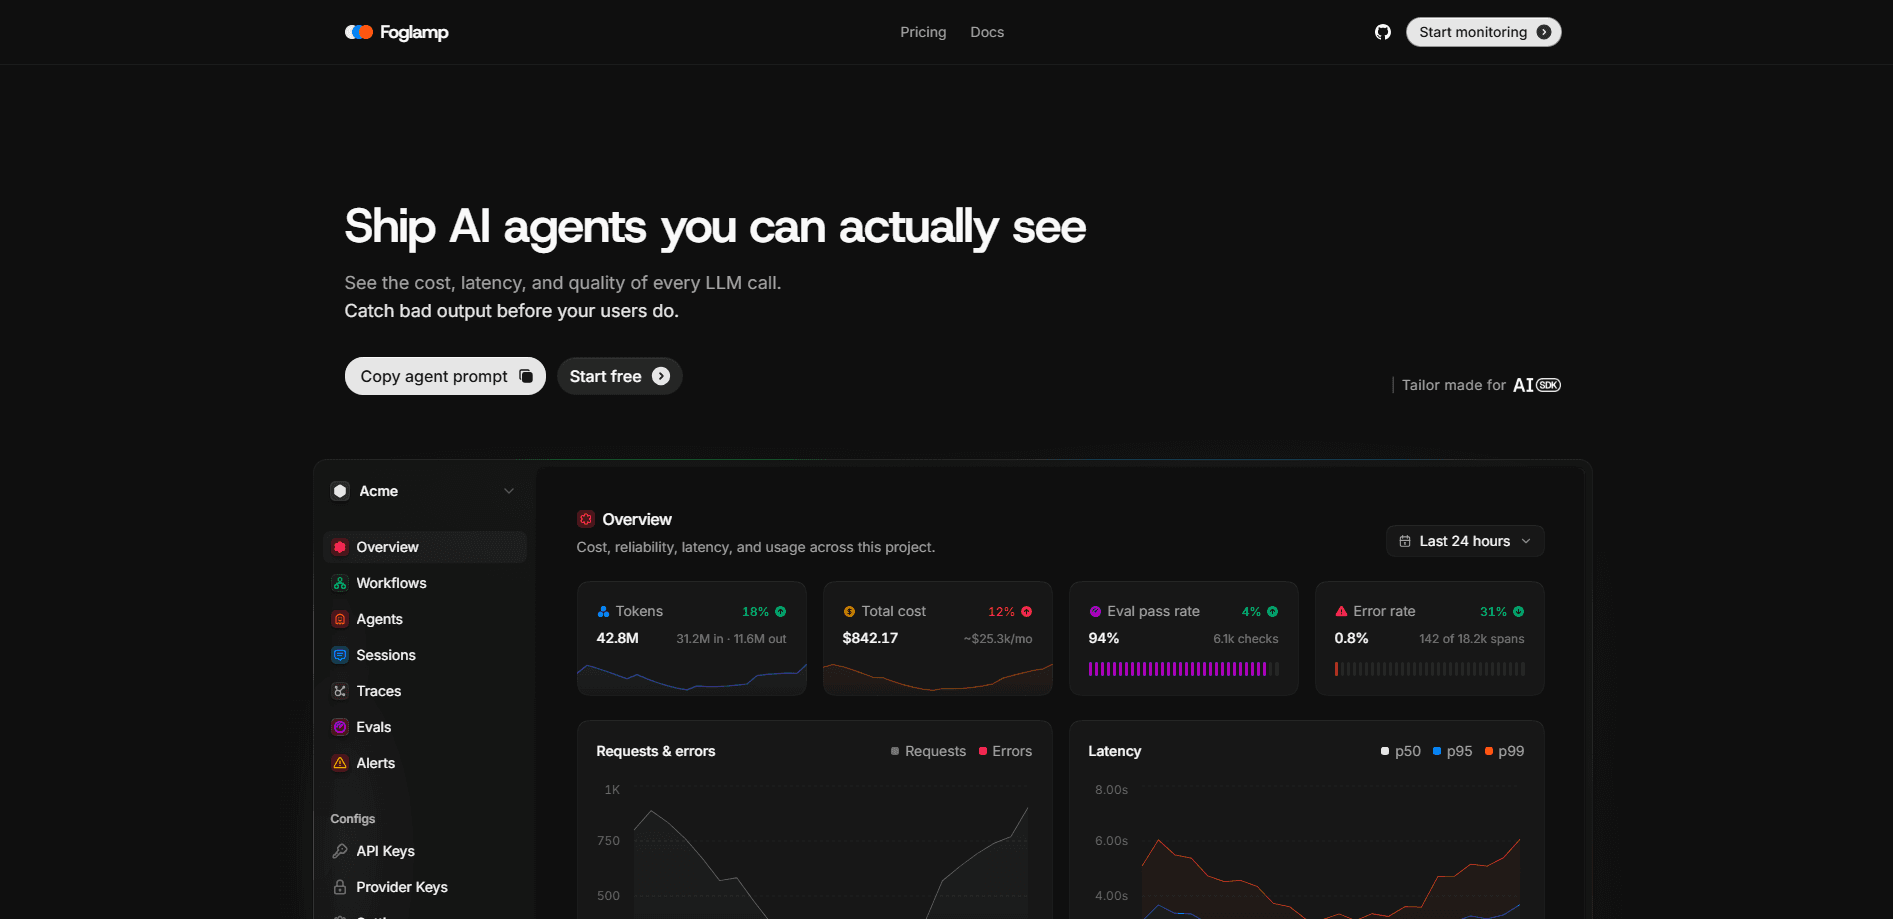
Foglamp é uma plataforma de observabilidade para agentes de IA que vigia as chamadas de LLM que o seu aplicativo faz e as transforma em custos, números de latência, traces distribuídos, avaliações e alertas. Ela se conecta ao Vercel AI SDK com duas linhas de código, então equipes que constroem agentes de IA veem quanto custou cada chamada a um modelo, quão lenta ela foi e onde as saídas deram errado antes que os usuários percebam.
Sobre Foglamp
O que é o Foglamp
Foglamp é a camada de observabilidade do Vercel AI SDK. Ele cuida da observabilidade de agentes de IA capturando cada chamada a generateText e streamText que o seu código executa, e depois divide essas chamadas por modelo, agente e cliente para que você pare de adivinhar de onde vêm o seu orçamento e os seus bugs. Como ferramenta de monitoramento de IA, ele fica entre o código do seu agente e os modelos que ele chama.
O problema que ele resolve é simples de enunciar e doloroso de viver. Assim que você coloca um agente de IA em produção, custo e qualidade se desviam em silêncio. Uma mudança de prompt pode dobrar o uso de tokens. Uma troca de modelo pode adicionar segundos de latência. Uma saída ruim pode passar sem que ninguém perceba. Foglamp torna essas mudanças visíveis.
É código aberto sob Apache 2.0, e você pode hospedá-lo por conta própria. Isso importa se os seus prompts e respostas não podem sair da sua infraestrutura. O porém está no foco. O Foglamp foi feito primeiro para o Vercel AI SDK. Hoje, equipes em outros frameworks aproveitam menos dele.
Primeiros passos
- Crie uma chave de API do Foglamp no painel, ou imprima uma pelo script de seed se você hospeda por conta própria. A chave começa com
fl_. - Instale o pacote com
npm i foglamp(também disponível para pnpm, bun e yarn). - Defina
FOGLAMP_API_KEYno seu ambiente. Se a chave estiver faltando, o Foglamp não faz nada e nada quebra, então é seguro deixá-la em qualquer ambiente. - Envolva o módulo
aicomwrap()e nomeie as suas chamadas usandofog.with({ agentName: "..." }). No AI SDK v7, adicione a integração ao array de telemetria de cada chamada. - Rode o seu aplicativo e abra o painel para ver traces, custos e latência chegando.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Foglamp.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Engenheiros de IA que colocam agentes no Vercel AI SDK
- Equipes de produto pequenas que vigiam o gasto em IA
- Empresas preocupadas com privacidade
Tarefas
- Acompanhar o custo de LLM por modelo e cliente
- Depurar execuções lentas de agentes
- Pontuar o tráfego de produção
Cenários
- Lançar um agente novo em produção
- Auditar uma migração de modelo
- Rodar fluxos com vários agentes
Principais recursos
Inteligência de custos
O Foglamp registra quanto custa cada chamada e divide isso por modelo, agente e cliente. Em vez de uma fatura mensal embaçada, você tem uma linha para cada um que chama. Isso torna possível apontar o único agente ou cliente que está drenando o seu orçamento. O dinheiro vaza rápido.
Traces distribuídos
Cada execução vira uma visão em cascata, com o prompt e a resposta exatos capturados por span. Quando um agente devolve algo estranho, você pode percorrer todo o fluxo de chamadas e achar o passo que quebrou em vez de adivinhar a partir dos logs.
Avaliações no tráfego de produção
Você pode pontuar tráfego real com verificações de código e juízes de LLM. Isso significa que a qualidade não é medida apenas em uma suíte de testes. Saídas ruins que escapam dos seus testes de staging são marcadas em dados ao vivo, que é onde elas de fato importam. É esse o ponto.
Alertas de custo, latência e taxa de erro
Regras de limite vigiam custo, latência e taxas de erro, e o plano Pro adiciona alertas por e-mail e Slack. Você define a linha, e o Foglamp avisa quando uma execução a cruza. Não é ideal saber de um pico de latência pelos seus usuários.
Rastreamento por agente
A visão de Agentes mostra spans, latência e gasto de cada agente, junto com o fluxo de chamadas completo dele. Equipes que rodam vários agentes podem compará-los diretamente e ver qual é lento ou caro sem vasculhar painéis compartilhados.
SDK de duas linhas
Envolver o módulo ai custa duas linhas, e as funções que você recebe de volta mantêm os tipos do próprio AI SDK. O seu código atual continua funcionando do mesmo jeito. Esse baixo custo de configuração é o principal motivo pelo qual equipes pequenas realmente o ativam. Por que isso importa? Porque a ferramenta que ninguém instala não pega nada.
Código aberto e auto-hospedável
O Foglamp roda sob Apache 2.0, e o código vive no GitHub. Se os seus dados não podem sair da sua infraestrutura, você pode hospedá-lo por conta própria e ainda ter os mesmos traces e painéis. Grande diferença para equipes reguladas.
Prós e contras
Prós
- A configuração sai quase de graça: duas linhas de código instrumentam cada chamada a generateText e streamText.
- O rastreamento de custos divide o gasto por modelo, agente e cliente, não só pelo total.
- Os traces distribuídos capturam o prompt e a resposta exatos por span, o que torna a depuração concreta.
- A licença Apache 2.0 com opção de auto-hospedagem mantém prompts sensíveis na sua própria infraestrutura.
Contras
- Foi feito primeiro para o Vercel AI SDK, então equipes em outros frameworks aproveitam um valor limitado.
- O plano gratuito limita você a 10.000 spans por mês com apenas 3 dias de retenção, o que não cobre um agente de produção movimentado.
- Os alertas por e-mail e Slack estão atrás do plano Pro de $49/mês, então usuários gratuitos podem perder o aviso quando algo quebra.
Perguntas frequentes
Ele registra as chamadas de LLM que o seu aplicativo faz e as transforma em números de custo, números de latência, traces, avaliações e alertas. Pense nele como um painel de monitoramento para as partes de IA do seu produto, não como um modelo nem um chatbot.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Foglamp.
Alternativas a Foglamp

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Google EmbeddingGemma 2
Google DeepMind · Escrita · Imagem · ProgramaçãoGoogle EmbeddingGemma 2 é um modelo aberto de 740 milhões de parâmetros que transforma texto, código, imagens, áudio e quadros de vídeo em vetores de um único espaço de 768 dimensões, rodando em celulares e notebooks.

GitGlow
GitGlow · Programação · ProdutividadeO GitGlow é um cliente Git de desktop que coloca seu código e as mudanças dos seus agentes de IA na mesma revisão, para você saber o que vai sair da máquina antes de publicar.