
Fuzzy Match
Radix Analytics Pvt Ltd · Programação
Fuzzy Match é uma ferramenta web de correspondência de dados que carrega arquivos CSV ou Excel e encontra nomes parecidos, erros de digitação e variações de grafia nas colunas que você escolher.
Sobre Fuzzy Match
What Is Fuzzy Match
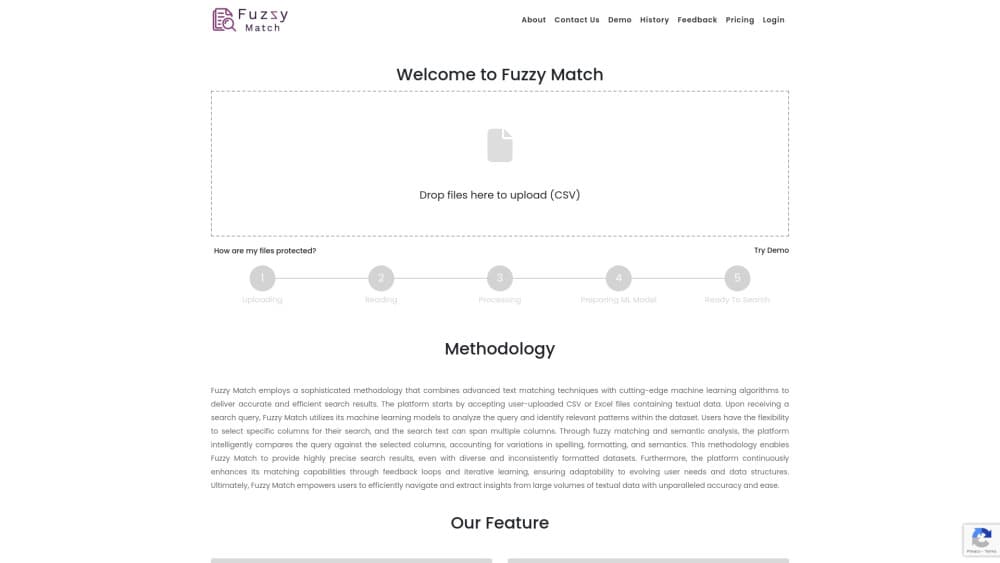
Fuzzy Match é um aplicativo web da Radix Analytics que compara o texto digitado com um arquivo enviado. Você marca as colunas que quer consultar, manda um nome, endereço ou código de produto e recebe as linhas parecidas com a busca, inclusive as que trazem erro de digitação ou formatação diferente.
O produto resolve um problema bem comum no escritório: duas listas que descrevem as mesmas entidades e nunca batem na grafia. Um cliente aparece como "Jon Smith" num export e como "John Smyth" em outro. Com uma ferramenta de correspondência difusa dessas, você acha esses pares sem escrever SQL nem Python.
É um console de busca, não uma suíte completa de limpeza de dados. Você recebe correspondências ordenadas e um histórico das execuções, mas não um fluxo que reconstrua o registro mestre. Cada plano também limita tamanho de arquivo, quantidade de arquivos e número de resultados, então bases muito grandes precisam ser divididas antes do envio.
Getting Started
- Abra fuzzymatch.in e teste a demonstração sem conta, ou entre para liberar os limites do plano gratuito.
- Envie um arquivo CSV ou Excel e espere enquanto o serviço lê as linhas e prepara o modelo de comparação.
- Selecione as colunas que serão lidas e digite o nome, endereço ou código que procura.
- Revise os resultados ordenados, ajuste a redação da consulta e deixe a execução no histórico.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Fuzzy Match.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Analistas de dados
- Administradores de operações e CRM
- Times pequenos sem engenheiros
Tarefas
- Deduplicar uma lista de clientes
- Correspondência de endereços
- Limpeza de catálogo
- Limpeza de dados antes do relatório
Cenários
- Auditoria pontual de arquivo
- Conferências mensais de fornecedores
- Revisão antes de migrar
Principais recursos
Correspondência difusa que tolera erros de digitação
O motor compara sua consulta com cada linha e ainda devolve acertos quando sobram, faltam ou trocam letras. Isso pesa em trabalhos de correspondência de dados com registros digitados à mão, onde o primeiro erro derruba um filtro exato.
Controle das colunas pesquisadas
Você define quais colunas o motor lê, e uma mesma consulta pode cobrir mais de uma. Restringir a busca à coluna de nomes corta o ruído de notas e campos livres, e a lista ordenada fica curta o bastante para revisar.
Machine learning no lugar de listas de regras
O Fuzzy Match apresenta a comparação como um modelo que aprende com o arquivo, não como um conjunto fixo de exceções. Na prática, isso ajuda em bases onde o formato muda de linha para linha.
Ciclos de feedback
A plataforma recolhe suas avaliações sobre as correspondências e usa isso para afinar execuções seguintes. Se você marca um par como errado, o modelo recebe um sinal, e esse é o motivo principal para entrar na conta em vez de usar a demo anônima.
Histórico e controle de retenção
Cada execução fica numa tela de histórico e você pode apagar arquivos antes do vencimento. A retenção depende do plano: 24 horas no gratuito e depois 7, 15 ou 30 dias conforme você sobe de faixa.
Limites por plano e modelos próprios
As faixas gratuitas e pagas diferem em tamanho de arquivo, número de resultados, armazenamento e arquivos por mês. O Premium acrescenta um modelo de ML treinado com seus dados, pensado para times com regras de correspondência bem específicas do setor.
Prós e contras
Prós
- Sem instalação e sem configuração: tudo roda numa aba do navegador e a demo funciona antes de criar conta.
- Tetos claros: tamanho de arquivo, resultados e retenção estão publicados por plano, então dá para prever se o gratuito atende.
- Comparação que aprende: as correções voltam para o modelo, o que rende mais que regras fixas de distância entre textos em listas sujas.
- Opção de modelo próprio: o Premium atende times que precisam de ajuste nos próprios dados, não de um modelo genérico.
Contras
- Os tetos de resultado pesam em arquivos grandes: até o Premium para em 1.000 correspondências por busca, então um trabalho de 50.000 linhas precisa ser fatiado.
- Sem API pública documentada: a automação fica restrita a envios manuais, o que inviabiliza pipelines agendados a menos que você construa algo em volta do fluxo web.
- Retenção curta: os arquivos somem em no máximo 30 dias, então a ferramenta não serve como armazenamento leve para auditoria.
- A revisão humana continua necessária: entre correspondências próximas há falsos positivos e a ferramenta não funde registros por você.
Perguntas frequentes
Procura num arquivo CSV ou Excel as linhas parecidas com o texto digitado, incluindo as que têm erros de digitação e variações de grafia. Você escolhe as colunas e revisa os resultados ordenados.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Fuzzy Match.
Alternativas a Fuzzy Match

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Google EmbeddingGemma 2
Google DeepMind · Escrita · Imagem · ProgramaçãoGoogle EmbeddingGemma 2 é um modelo aberto de 740 milhões de parâmetros que transforma texto, código, imagens, áudio e quadros de vídeo em vetores de um único espaço de 768 dimensões, rodando em celulares e notebooks.

GitGlow
GitGlow · Programação · ProdutividadeO GitGlow é um cliente Git de desktop que coloca seu código e as mudanças dos seus agentes de IA na mesma revisão, para você saber o que vai sair da máquina antes de publicar.