

Gemini 3.8 & 3.8 Live Extended Thinking
Google DeepMind · Voz e linguagem · Chatbot
O Gemini 3.8 Live e o Gemini 3.8 Live Extended Thinking são dois modelos de IA de voz em tempo real do Google DeepMind, ambos lançados em 15 de setembro de 2026. O 3.8 Live padrão é um modelo de voz para voz ajustado para interfaces de voz rápidas e baratas, enquanto o 3.8 Live Extended Thinking adiciona raciocínio em segundo plano em várias etapas, então consegue continuar falando enquanto resolve um problema difícil. Os desenvolvedores chegam aos dois pela Gemini API, pelo Google AI Studio e pela Gemini Live API. Sem configuração extra. Os usuários comuns já os encontram dentro do Gemini Live e do Search Live, e o Google diz que os dois modelos começaram a ser distribuídos também no app Gemini e no Google Workspace.
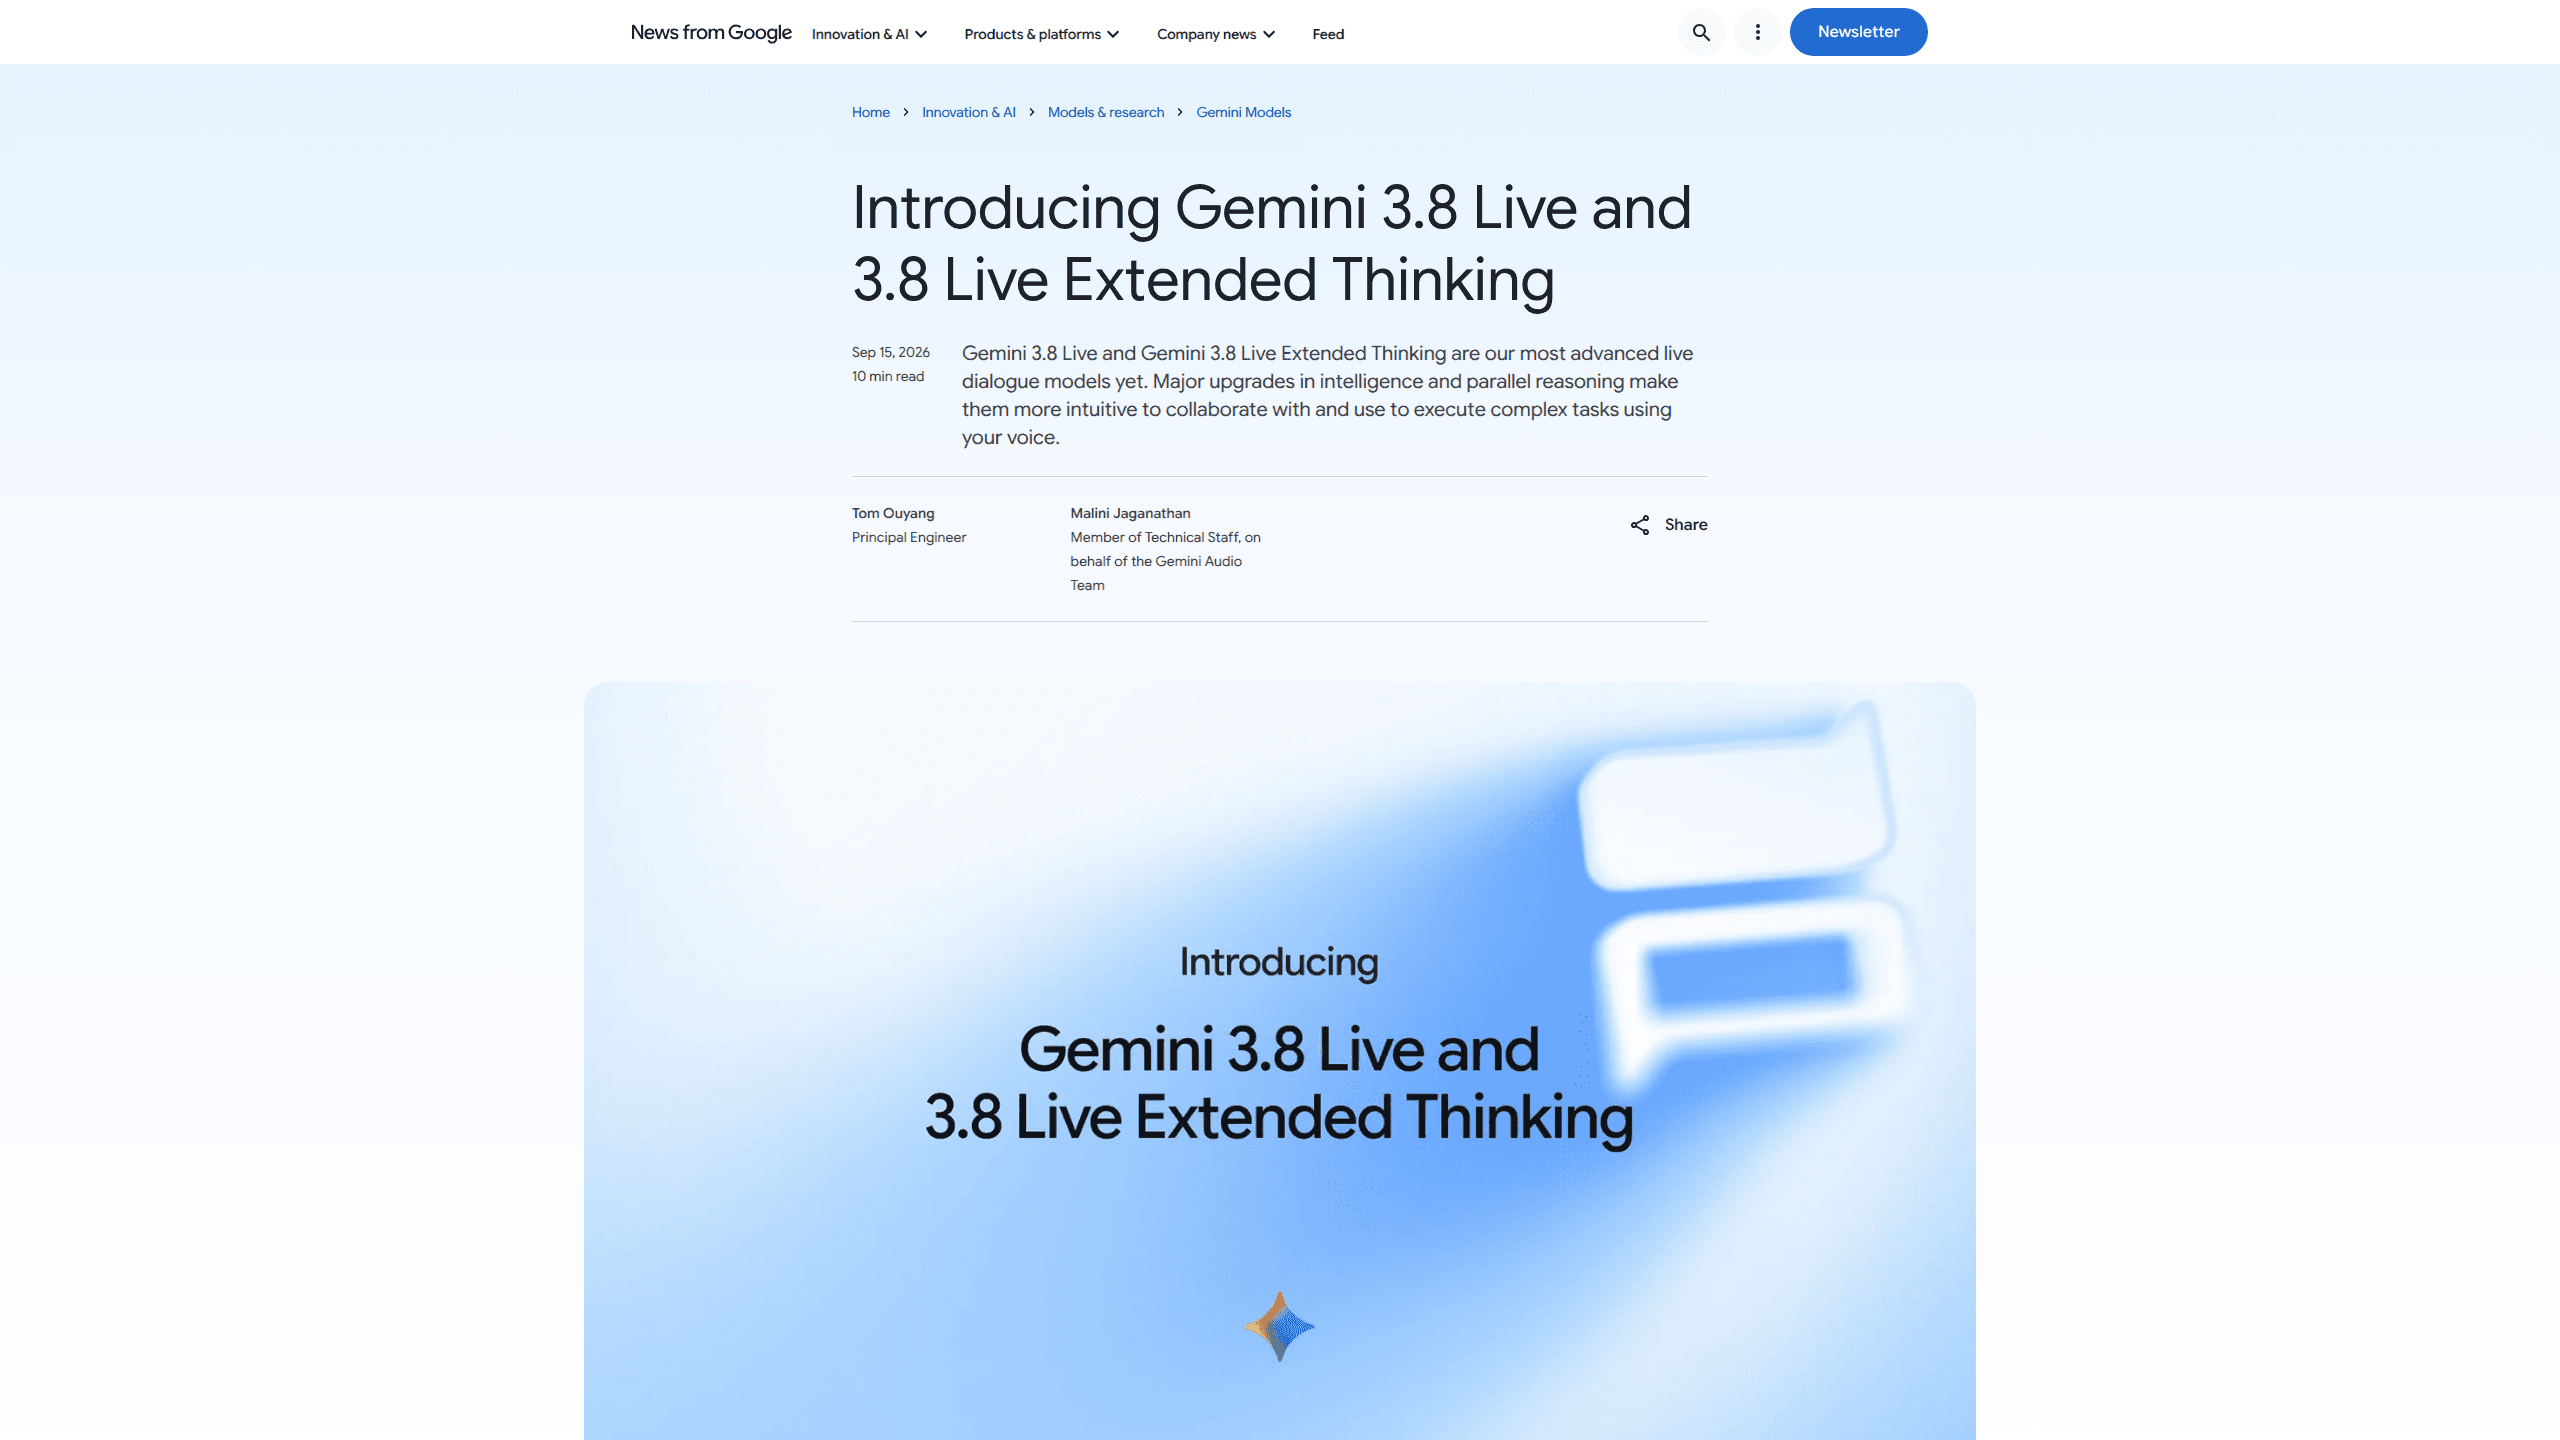
Sobre Gemini 3.8 & 3.8 Live Extended Thinking
O que é o Gemini 3.8 e o 3.8 Live Extended Thinking
São os modelos de conversação em tempo real mais avançados do Google até hoje, segundo a empresa. Os dois são nativamente de voz para voz, o que significa que ouvem áudio e respondem com áudio em vez de passar suas palavras por um modelo de transcrição separado, depois por um modelo de texto e depois por um gerador de voz. Essa cadeia antiga era a origem de boa parte do atraso e da perda de tom.
A diferença entre os dois se resume a como lidam com uma pergunta difícil, e essa única decisão de projeto define em qual você deve basear seu produto. O Gemini 3.8 Live responde rápido e chama ferramentas em segundo plano, o que serve para roteamento de atendimento ao cliente, busca por voz e prática de idiomas. O Gemini 3.8 Live Extended Thinking mantém um processo de "pensamento" rodando enquanto fala, então consegue narrar o progresso em tarefas de várias etapas, como planejar uma viagem ou depurar código, sem ficar em silêncio.
Os limites principais são práticos. O Extended Thinking só dá suporte a chamadas de ferramentas assíncronas e não bloqueantes. Além disso, é preciso esperar um sinal de ociosidade explícito antes de encerrar uma sessão. E os níveis de pensamento mais altos custam mais por minuto de áudio. A cobrança é por minutos de áudio, não por tokens, então apps de voz sempre ativos precisam fazer a conta do orçamento desde o início.
Como começar
- Abra o Google AI Studio ou o console da Gemini API e escolha
gemini-3.8-liveougemini-3.8-live-extended-thinking. - Para apps de voz ao vivo, conecte-se pela Gemini Live API usando um WebSocket com estado, em vez de uma única requisição.
- Envie o áudio de entrada como PCM de 16 bits a 16 kHz little-endian, e espere o áudio de saída em PCM de 16 bits a 24 kHz.
- Se usar o Extended Thinking, defina um nível de pensamento (low, medium ou high) e use só chamadas de ferramentas não bloqueantes.
- Encerre a sessão apenas depois de ver um status de ociosidade do modelo.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Gemini 3.8 & 3.8 Live Extended Thinking.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores que criam agentes de voz
- Equipes de atendimento ao cliente
- Usuários comuns do app Gemini
Tarefas
- Resolução de problemas em tempo real
- Prática de idiomas ao vivo
- Reservas e agendamento
Cenários
- Usar um assistente de mãos livres enquanto dirige ou cozinha, quando esperar em silêncio por uma resposta parece falha.
- Orientar alguém por um esboço no quadro branco, já que o 3.8 Live lê a entrada visual quase em tempo real.
- Coordenar várias funções assíncronas em uma única sessão falada, como verificar estoque, depois preço e depois prazo de entrega.
Principais recursos
Conversa de voz para voz
Os dois modelos pulam a velha cadeia de transcrever e depois gerar. O áudio entra. O áudio volta. O ganho são menos sinais de tom perdidos e menos atraso entre o que você diz e o que retorna. Para um app de voz, essa lacuna é a experiência inteira.
Pensar em voz alta sem ficar em silêncio
O Extended Thinking roda o raciocínio em paralelo à fala. Em vez de silêncio total diante de uma pergunta difícil, ele abre com uma breve espera verbal como "Deixa eu verificar isso" e depois narra o progresso enquanto trabalha. As demos do Google incluem orientação de xadrez ao vivo e a conversão de esboços no quadro branco mais comentários falados em um componente React que funciona.
Chamadas de ferramentas e API em segundo plano
Você pode continuar falando enquanto o modelo faz uma busca na web ou chama uma ferramenta. No Extended Thinking, só há suporte a ferramentas assíncronas não bloqueantes. Esse último detalhe importa. Uma chamada bloqueante travaria justamente o fluxo que o modelo tenta proteger.
Troca entre 97 idiomas em uma única chamada
O Gemini 3.8 Live detecta e alterna entre 97 idiomas compatíveis sem que você reinicie a sessão. Casas multilíngues e centrais de atendimento que recebem chamadas em idiomas misturados são quem mais aproveita isso, e ninguém precisa escolher um idioma de antemão.
Entrada visual quase em tempo real
O modelo padrão entende imagens e quadros de vídeo conforme chegam, mais ou menos um quadro por segundo. Isso deixa ele comentar o que uma câmera vê.
Marca d'água de áudio SynthID
Todo clipe de áudio que esses modelos geram carrega uma marca d'água SynthID invisível. Não há botão para desativá-la. Ela não muda o que você ouve, mas dá às plataformas uma forma de sinalizar fala gerada por IA.
Prós e contras
Prós
- O projeto de voz para voz corta o atraso que fazia os assistentes de voz antigos soarem robóticos.
- O Extended Thinking mantém a conversa viva enquanto trabalha, então pedidos complexos não geram silêncio total.
- O preço por minuto de áudio, $0.005 na entrada e $0.018 na saída, fica previsível em apps de alto volume.
- A troca nativa entre 97 idiomas serve produtos multilíngues sem configuração extra.
- A marca d'água SynthID invisível já vem integrada para quem publica áudio gerado.
Contras
- O Extended Thinking só permite chamadas de ferramentas assíncronas não bloqueantes, então ferramentas síncronas obrigam a outra arquitetura.
- É preciso esperar um status de ociosidade explícito para encerrar uma sessão, o que adiciona um estado que seu código tem de acompanhar.
- A cobrança por minuto de áudio sobe rápido em assistentes sempre ativos, porque não há teto fixo.
- Os níveis de pensamento mais fortes elevam o custo por minuto, então o raciocínio mais profundo não sai de graça.
Perguntas frequentes
O Gemini 3.8 Live é ajustado para conversa em tempo real rápida e barata, enquanto o 3.8 Live Extended Thinking adiciona raciocínio em segundo plano em várias etapas e consegue falar e pensar ao mesmo tempo. Os dois compartilham a mesma base de voz para voz, então escolha com base em latência ou profundidade.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Gemini 3.8 & 3.8 Live Extended Thinking.
Alternativas a Gemini 3.8 & 3.8 Live Extended Thinking
Prosp
Prosp · Escrita · Voz e linguagem · MarketingO Prosp é uma ferramenta de abordagem no LinkedIn com IA, feita para agências e equipes de vendas, e escreve a mensagem e a nota de voz com a sua própria voz para cada prospect, para que eles realmente respondam. Você conecta suas contas, encontra leads e deixa a IA redigir e enviar mensagens personalizadas em escala, tudo em uma única caixa de entrada. É feita para quem faz abordagem em volume. Essa é toda a proposta. Cada toque ainda precisa parecer humano.

Wordly AI Translation
Wordly · Voz e linguagem · ProdutividadeO Wordly AI Translation é uma plataforma de tradução e legendagem com IA em tempo real feita para reuniões, conferências e eventos. Ele entrega tradução ao vivo, legendas, transcrições e resumos em mais de 60 idiomas, e os participantes entram escaneando um QR code ou abrindo um link em vez de usar fones dedicados. A plataforma funciona com Zoom, Microsoft Teams, Google Meet e Webex, e foi pensada para organizações que querem acesso multilíngue sem contratar intérpretes humanos para cada sessão. Simples assim.
Musicful
Musicful AI · Voz e linguagem · VídeoO Musicful é um gerador de música com IA e um criador de videoclipes com IA que transforma texto em música em minutos. Você entrega um texto, um conjunto de letras ou uma melodia cantarolada e ele devolve uma faixa pronta com vocais e instrumentos. Também funciona como gerador de músicas com IA, produz videoclipes a partir das músicas que você cria e oferece uma ferramenta de cover com IA mais uma API para desenvolvedores. A plataforma roda no navegador e em um app para Android, então você pode começar uma música no computador e continuar no celular.